
1. 从目标轨迹到输入相位
自加速光束(accelerating optical beam)最吸引我的地方,是它在自由空间传播时,主瓣并不沿直线前进。最经典的 Airy beam 在傍轴近似下沿抛物线传播;更一般地,我们也可以先指定一条轨迹,再反过来寻找能够产生这条轨迹的输入光场。
传统做法通常从 caustic theory 出发,根据目标轨迹解析地推导空间相位或频谱相位。以 Generation of spirally accelerating optical beams 为例,它所解决的正是这样一个问题:
真正困难的是中间这一步:
学到 differentiable optics 和 inverse design 之后,我开始想:这里的问号是否一定要由我先完成一套解析推导?如果传播过程本身可以求导,那么也可以把输入相位当作未知参数,让优化器直接从传播结果中寻找答案:
PyTorch 会沿着光强计算、角谱传播和输入场构造自动反向传播,得到
再由 Adam 逐步更新相位。
本文就从这个思路出发,以一条凸抛物线为例,尝试用 phase-only inverse design 生成沿指定轨迹弯曲的高强度区域。整个实验使用 PyTorch 构建可微优化过程,并用 TorchOptics 检查训练后光场的二维传播。
1.1 简化为一维问题
我先只考虑 $x$ 方向,将完整二维相位掩模留到后续。目标轨迹取为
并用终点位移确定系数:
输入振幅固定为 Gaussian distribution:
唯一需要学习的是一维相位 $\phi(x)$:
当横向网格有 $N$ 个采样点时,优化器只需学习 $N$ 个实数,参数量远小于二维相位的 $N^2$。这里先验证一个基础问题:一张一维 phase-only mask,能不能让传播强度的高值区域逼近给定曲线?
当前损失没有约束无衍射、自修复、主瓣宽度恒定、旁瓣、能量效率或器件可制造性。因此,这里的结果只代表 trajectory inverse design 的第一步。
2. 设置数值网格
2.1 选择传播范围
实验采用以下参数:
1 | wavelength = 532e-9 |
横向坐标与输入 Gaussian amplitude 为
1 | coord = (torch.arange(N, device=device) - (N - 1) / 2) * dx |
横向视场为
坐标范围约为 $[-2.56,2.56]\ \mathrm{mm}$。$w_0=0.20\ \mathrm{mm}$ 对应 10 个横向 pixel,输入 Gaussian 不至于在网格上完全欠采样。
训练距离取一个 Rayleigh range:
在 $0$ 到 $z_R$ 之间均匀选择 64 个传播平面。目标轨迹被写成一个独立函数:
1 | z_values = torch.linspace( |
2.2 检查数值可表示性
参数确定之后,下一步不应该马上进入优化,而要先检查目标是否超出离散网格的表达能力。否则,如果轨迹已经越过横向视场、输入场采样不足,或者所需传播角超过 Nyquist limit,后面无论怎样调整 loss 和 optimizer 都无法解决问题。
当前参数对应的检查结果是:
- 目标在一个 Rayleigh range 内最大移动 $1\ \mathrm{mm}$,视场半宽为 $2.56\ \mathrm{mm}$,边界余量为 $1.56\ \mathrm{mm}$。
- Gaussian 的 $1/e$ amplitude radius 覆盖 10 个 pixel,输入场没有明显欠采样。
- 抛物线最大斜率约为 $8.40\ \mathrm{mrad}$。
- 当前横向采样对应的 Nyquist angle 约为 $13.30\ \mathrm{mrad}$,目标使用了约 63.2%。
- 64 个训练平面的间距约为 $3.75\ \mathrm{mm}$;在轨迹最陡处,相邻平面的目标位移约为 1.57 pixel。
Notebook 输出为
1 | Numerical sampling sanity check |
这些数值说明输入场和目标曲线都能被当前离散网格表示,说明优化失败不会来源于目标从一开始就在数值上不可表示。
2.3 表示可训练相位
相位参数用一个很小的 torch.nn.Module 表示:
1 | class PhaseMask(torch.nn.Module): |
每次 forward pass 都用当前相位构造复振幅:
1 | phase_x = phase_mask() |
训练期间没有必要强制 $\phi\in[0,2\pi)$。真正进入光场的是 $e^{i\phi}$,它天然具有 $2\pi$ 周期性。需要显示相位或把它加载到 phase-only modulator 时,再计算
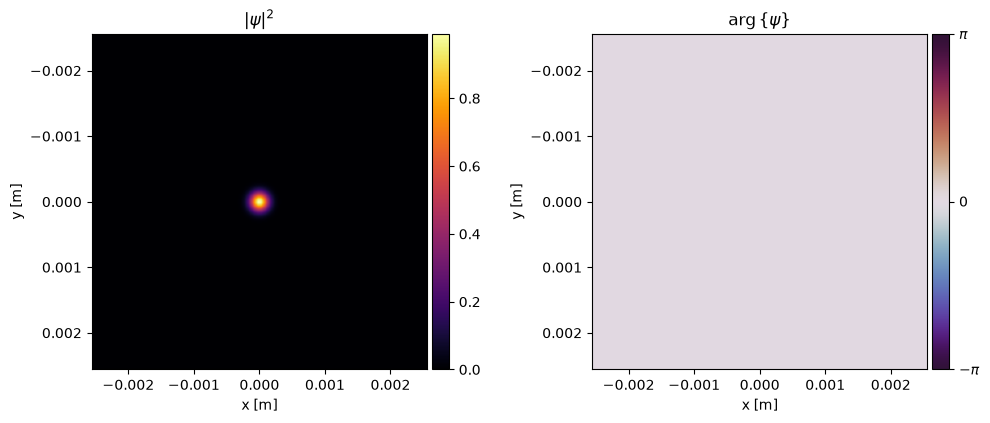
为了检查输入场,我把同一个一维复光场分别放在 $x$ 和 $y$ 两个方向,构造了一个可分离二维场。此时还没有训练,图中主要看到的是位于中心的 Gaussian input。
3. 用一维 ASM 传播
3.1 实现一维 ASM
目标轨迹和损失都定义在 $x$-$z$ 平面。如果先构造二维 Field,传播后再沿 $y$ 积分回到一维,那么训练过程会不断计算一个最终没有进入目标函数的额外维度。因此,我最后保留了一个直接用 PyTorch FFT 实现的一维 Angular Spectrum Method(ASM)。
ASM 的思路是把输入场分解为空间频率不同的平面波,让每个分量在频域积累传播相位。若 $f_x$ 以 cycles per meter 为单位,则
传播距离 $z$ 对应的传递函数为
所以
对应实现为
1 | def propagate_trajectory(field_x, z_values): |
输入频谱只需计算一次,随后针对每个 $z_i$ 乘上传递函数。FFT、复数乘法和 IFFT 都留在 autograd 计算图中,因此这个效率上的简化不会切断梯度。
传播结果直接写成
1 | fields_x = propagate_trajectory(input_field_x, z_values) |
堆叠后,强度张量的形状是 [num_z, N]。这里从始至终没有 $y$ 维度,也不需要执行 intensity.sum(dim=0)。
3.2 固定 TorchOptics 的传播方法
TorchOptics 的 Field.propagate_to_z() 默认使用 propagation_method="AUTO",它会根据传播距离与临界传播距离,在 ASM 和 Direct Integration Method(DIM)之间自动选择。临界距离与网格范围、采样间隔和波长有关,可以写为
训练使用自定义一维 ASM。若二维可视化在某些距离由 AUTO 切换到 DIM,训练和结果检查就会使用不同的传播方法。ASM 与 DIM 都可以求导,但数值离散误差有所不同。
因此,训练后的二维传播显式指定
1 | field.propagate_to_z( |
这样可以避免 ASM/DIM 模型切换,使训练与结果检查保持在同一种传播框架内。自定义一维 ASM 与 TorchOptics 二维 ASM 的维度和离散细节仍有差异。
4. 定义轨迹损失
有了正向传播模型之后,每个传播平面都会得到一条 intensity profile:
直觉上,只要找出每个平面的最亮位置
再比较它和目标位置 $x_t(z_i)$,就可以写出一个非常直接的轨迹损失:
问题在于,argmax 是离散选择。强度稍有变化,结果就可能从一个 pixel 跳到相邻 pixel,无法提供连续而稳定的梯度。
我也考虑过用 softmax 加权坐标构造 soft peak,但这又会把整条 profile 压缩成一个坐标。训练初期目标位置几乎没有光时,梯度信号可能很弱;如果存在两个分离峰,它们的加权中心甚至可能刚好位于目标位置,让坐标误差看起来很小,却没有真正形成目标主瓣。
所以我最终放弃了在训练中”先找峰值坐标”,转而直接比较完整的 intensity profile。
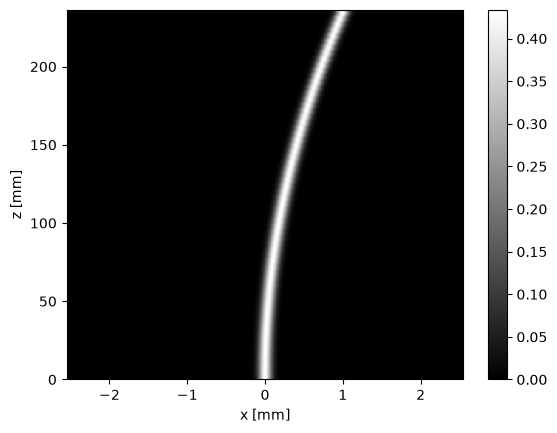
4.1 构造 Gaussian target tube
对于每个目标位置 $x_t(z_i)$,在其周围放置宽度为 $\sigma_x$ 的 Gaussian:
当前实验取 $\sigma_x=60\ \mu\mathrm m$:
1 | sigma_x = 60e-6 |
target_profiles 的形状为 [64, 256]。沿 $z$ 方向排列后,它形成一条具有有限宽度的 Gaussian tube。
4.2 用 profile overlap 代替 peak loss
不同传播面的峰值强度可能相差很大。这个阶段我先关心”形状和位置是否对齐”,因此对每个预测 profile 和目标 profile 分别做 $L^2$ normalization:
单个平面的 overlap 为
最终损失取为
1 | def trajectory_profile_loss( |
与单独比较坐标相比,这个损失保留了更多空间信息:目标区域太暗、非目标区域太亮,或者 profile 的形状与 target tube 不一致,都会降低 overlap。代价是它没有直接约束绝对功率——这个问题会在结果分析中再次出现。
5. 优化输入相位
优化器使用 Adam,学习率为 0.03,总共训练 380 次:
1 | optimizer = torch.optim.Adam( |
这个循环依次构造输入场、传播到多个 $z$ 平面、计算 profile overlap,再把梯度传回 $\phi(x)$。结果主要取决于 target 和 loss 的定义。
最后一次 optimizer.step() 更新的是相位参数,而当前循环里的 intensities_x 仍然对应更新前的参数。因此训练完成后,我重新执行了一次 forward pass,确保后面的图像和指标使用最终相位:
1 | with torch.no_grad(): |
6. 分析优化结果
优化结束以后,我分别从损失收敛、峰值轨迹、完整 x-z 强度分布、学习到的相位,以及二维传播截面几个角度检查结果。
6.1 损失收敛
训练 loss 从 0.643652 持续下降,在约 200 次迭代后进入平台,最终稳定在 0.21376 左右:
1 | 0000 loss=0.643652 |
loss 的下降表明梯度能够穿过复数场、ASM 和 intensity calculation 回到输入相位,同时预测 profile 与 target tube 的重合度在提高。profile-overlap loss 不衡量位置误差,因此还需要单独检查主瓣轨迹。
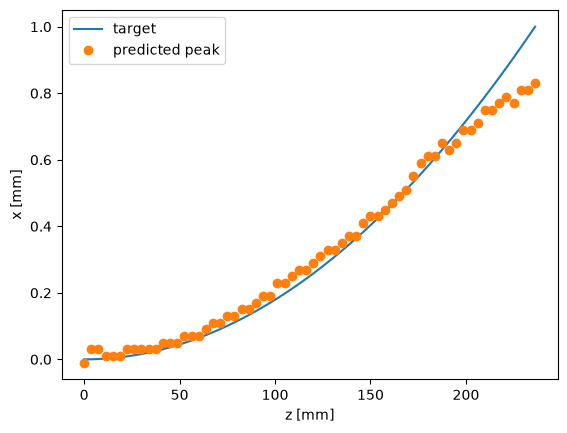
6.2 峰值轨迹
argmax 在训练完成后可以直接测量每个传播面的最亮 pixel:
1 |
|
把这些离散位置与目标抛物线放在一起,能够直接回答最初的问题。从图中可以看到,预测峰值整体沿正 $x$ 方向弯曲,并大体跟随目标轨迹;同时也能看到部分传播位置存在跳变和偏离。由于 hard argmax 只能落在横向网格点上,轨迹本身还带有 $20\ \mu\mathrm m$ 的量化。
6.3 x-z 强度分布
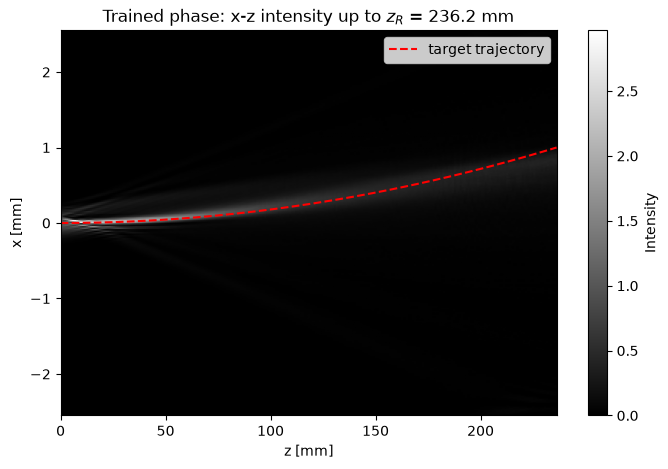
接下来,我把所有一维强度直接堆叠成 x-z map:
1 | xz_intensity = torch.stack(intensities_x, dim=0).T |
hard argmax 每个平面只留下一个坐标,完整强度图则保留主瓣宽度、旁瓣和多个竞争峰。图中的高强度 ridge 朝目标方向弯曲,但局部峰值、宽度和旁瓣结构都会随传播发生变化。
6.4 训练后的相位
训练后的一维相位被外积扩展到两个方向,最后显示的是二维场
的 wrapped phase:
1 | with torch.no_grad(): |
这里两个横向方向都使用同一个训练后的一维复光场。
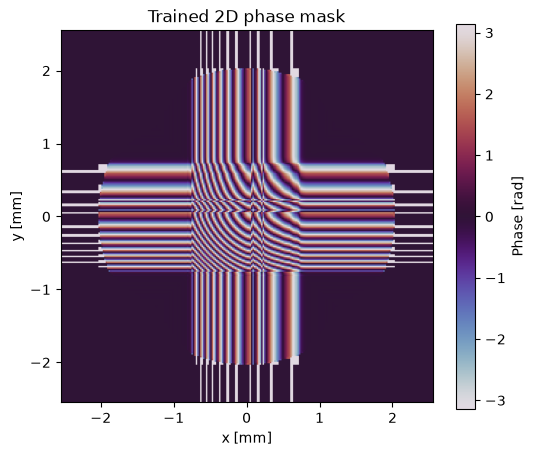
当前 loss 没有相位平滑、空间带宽、pixelation 或 phase quantization 约束,因此相位中出现快速变化并不意外。如果目标是实际加载到 SLM,这些器件约束需要在下一轮设计中显式加入。
6.5 二维传播截面
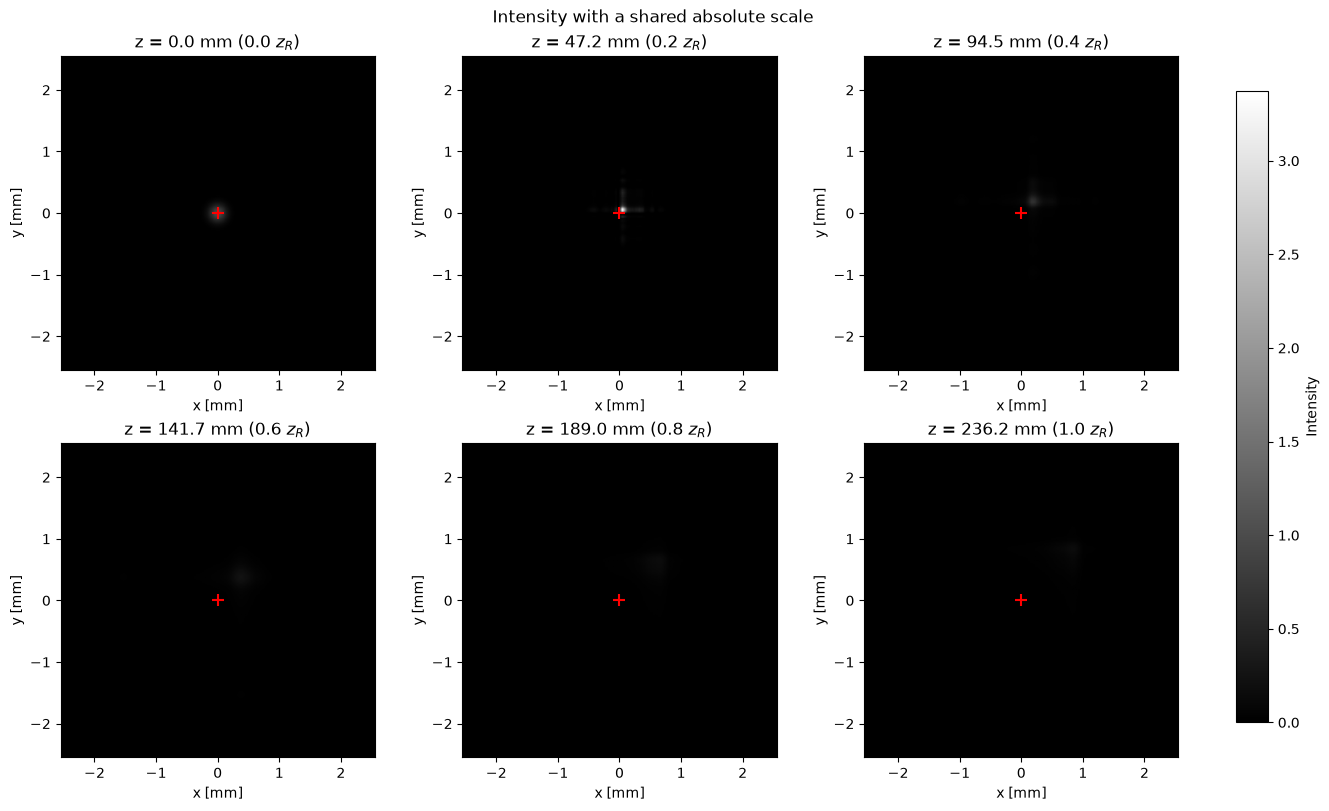
为了看清这个可分离二维场传播后是什么样子,我用 TorchOptics 的 ASM 在 $0$、$0.2z_R$、$0.4z_R$、$0.6z_R$、$0.8z_R$ 和 $z_R$ 处绘制 $x$-$y$ intensity cross-section。
这里用两张图观察同一组传播截面。第一张图采用共享的绝对强度尺度:所有子图使用相同的 vmin 和 vmax,因此既能看主瓣移到了哪里,也能比较不同传播距离的峰值强度和能量集中程度。图中可以看到,峰值强度并没有在传播过程中保持不变;这正是当前 normalized profile loss 没有直接约束的部分。
第二张图把每个传播面的强度分别除以该平面的最大值。逐面归一化后,较暗平面中的主瓣、旁瓣和空间结构会更加清楚,适合比较不同位置的形态变化;但由于每个平面都被重新缩放到最大值 1,它不能用于判断不同传播距离之间的绝对强度差异。
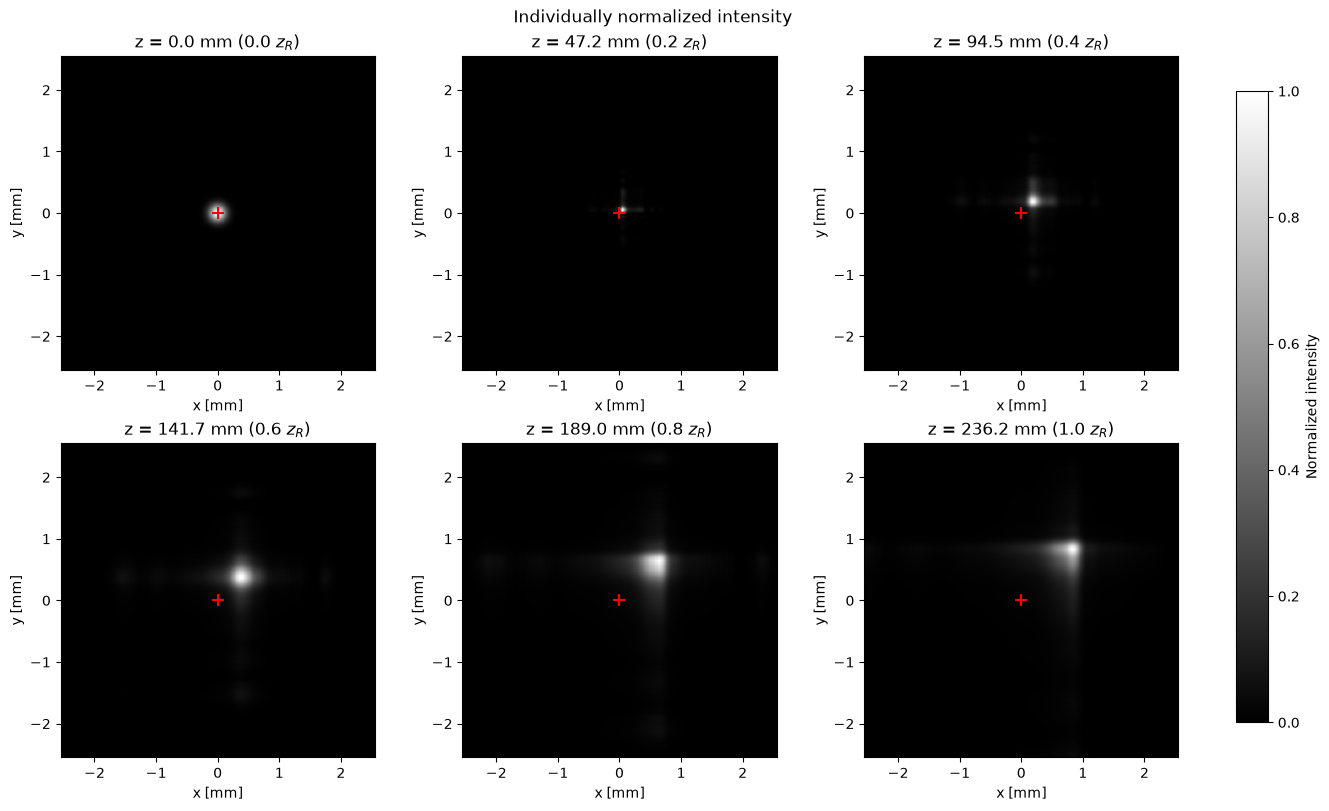
两种尺度提供互补信息。绝对尺度用于判断强度和能量集中程度是否稳定,相对尺度用于观察各传播面的主瓣与旁瓣结构。归一化会隐藏传播面之间的亮度差异,共享绝对尺度则可能使弱光平面的结构难以辨认。
7. 局限与改进方向
这次尝试说明:在给定的一维 ASM 和离散网格下,确实可以把输入 Gaussian 的 phase 写成可训练参数,并通过完整 x-z profile 的 overlap,让传播后的高强度区域逼近指定凸抛物线。
当前 profile 在每个传播面分别归一化,因此 loss 主要奖励空间重合,而不直接关心绝对功率。这会留下几类可能的退化结果:
- 目标区域的绝对强度较弱,但归一化后的形状相似;
- 不同传播面的峰值强度变化明显;
- 某些位置出现多个强度接近的竞争峰;
- 主瓣宽度和旁瓣强度没有得到控制;
- 相位包含不利于实际器件实现的高空间频率。
如果继续推进这个设计,我会优先在 loss 中加入能量集中度、旁瓣抑制和主瓣宽度约束,再逐步加入相位平滑、SLM pixelation 与量化。若要设计只沿 $x$ 加速、沿 $y$ 保持指定形态的二维光场,则应分别定义 $x$ 与 $y$ 方向的输入,或者直接优化完整二维相位。
本文采用 署名-非商业性使用-相同方式共享 4.0 国际 许可协议,转载请注明出处。
