<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <author>
    <name>Daria Lan</name>
  </author>
  <generator uri="https://hexo.io/">Hexo</generator>
  <id>https://believed-breadfruit.top/</id>
  <link href="https://believed-breadfruit.top/" rel="alternate"/>
  <link href="https://believed-breadfruit.top/atom.xml" rel="self"/>
  <rights>All rights reserved 2026, Daria Lan</rights>
  <subtitle>Software Engineer · Computational Optics · Builder · Writer</subtitle>
  <title>Atypical</title>
  <updated>2026-10-05T16:00:00.000Z</updated>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="思考" scheme="https://believed-breadfruit.top/categories/%E6%80%9D%E8%80%83/"/>
    <category term="AI" scheme="https://believed-breadfruit.top/tags/AI/"/>
    <category term="LLM" scheme="https://believed-breadfruit.top/tags/LLM/"/>
    <category term="提示词" scheme="https://believed-breadfruit.top/tags/%E6%8F%90%E7%A4%BA%E8%AF%8D/"/>
    <category term="复杂度" scheme="https://believed-breadfruit.top/tags/%E5%A4%8D%E6%9D%82%E5%BA%A6/"/>
    <category term="AI债" scheme="https://believed-breadfruit.top/tags/AI%E5%80%BA/"/>
    <content>
      <![CDATA[<p>最近看到池老师的一篇文章：<a href="https://mp.weixin.qq.com/s/mf0MQzOAnw5L9GCzn2Qlew">沉寂两个月后 AK 终于发声：理解 LLM 输出比以往更重要</a>。</p><p>我在思考一种叫“AI 债”的概念，定义为</p><div class="mathjax-block">$$D_{\text{AI}} = C_{\text{output}} - C_{\text{me}}$$</div><p>这里的 $C$ 代表复杂度，complexity。</p><p>当前的 AI 水平已经很高，在许多任务上远远超过了我。如果不加限制，它很容易生成超出我控制范围的内容。代码能跑，文章能写，项目也能迅速产出，但在这些产出中，真正属于自己可解释、可判断、可审核的部分，可能并没有那么多。</p><p>这样的差距如果不断积累，就会形成一种债。</p><h2 id="理解复杂度和审核复杂度"><a href="#理解复杂度和审核复杂度" class="headerlink" title="理解复杂度和审核复杂度"></a>理解复杂度和审核复杂度</h2><p>假设让 AI 写一个自由空间传播的 sanity checker。它可能会同时检查各种传输模型近似的适用条件，并分析采样、窗口、混叠等复杂问题。</p><p>在这份实现里，我可能无法完整解释所有数值细节、边界条件和工程处理方式。但是，我可以用已知的解析解做基准测试，用理论公式写单元测试，也可以直接观察模拟结果是否符合预期。</p><p>这说明，即使我缺乏完整理解，我仍然可能拥有一套独立的审核能力。</p><p>因此，原来的 $C_{\text{me}}$ 至少可以拆成两个部分：</p><ol><li><strong>理解能力 $C_u$</strong>：我能不能解释输出在做什么，以及为什么这样做。</li><li><strong>审核能力 $C_a$</strong>：我是否可以依据外部参考、测试用例或不变量，判断输出是否可以接受。</li></ol><p>在上面的例子里，实际情况可能是：</p><div class="mathjax-block">$$C_u &lt; C_{\text{output}} &lt; C_a$$</div><p>AI 输出的复杂度已经超过了我的完整理解范围，但还没有超过我的审核范围。</p><p>对应地，AI 债也可以拆成：</p><div class="mathjax-block">$$D_u = \max(0,\; C_{\text{output}} - C_u)$$</div><div class="mathjax-block">$$D_a = \max(0,\; C_{\text{output}} - C_a)$$</div><p>这些变量当然很难量化，但至少可以帮助我们简单建模分析，把不同的问题分开讨论。</p><h2 id="提示词如何改变复杂度"><a href="#提示词如何改变复杂度" class="headerlink" title="提示词如何改变复杂度"></a>提示词如何改变复杂度</h2><p>理解债取决于 $C_{\text{output}}$ 和 $C_u$ 之间的差距，审核债取决于 $C_{\text{output}}$ 和 $C_a$ 之间的差距。</p><p>有了上面的两个公式，我们就可以重新理解一些常见提示词是怎么起作用的。</p><p>比如，我们经常让 AI“说简单一点”，或者“假装我是初中生”，”explain it like I was 5”。这实际上是在降低输出的概念密度，让 $C_{\text{output}}$ 更接近理解能力 $C_u$。</p><p>要求“一步一步解释”，是在把原本省略的中间过程展开；要求“举个例子”，是在用熟悉的对象进行抽象概念；要求输出图表，则是在改变信息的表达方式，让复杂关系更容易被理解。</p><p>最近 Karpathy 提到使用 ASD STE100 来解释复杂技术内容，也是类似的思路。通过限制词汇、简化句法和减少歧义，降低理解难度。</p><p>这些提示词都在降低输出的理解复杂度，从而缩小 $C_{\text{output}}$ 和 $C_u$ 之间的差距。</p><p>如果想缩小审核债，也就是缩小 $C_{\text{output}}$ 和 $C_a$ 之间的差距，可以要求 AI 提供测试用例、reference 或 invariant，让我们拥有独立于 AI 解释之外的验收依据，从而提高审核力。</p><h2 id="输出语言也会改变复杂度"><a href="#输出语言也会改变复杂度" class="headerlink" title="输出语言也会改变复杂度"></a>输出语言也会改变复杂度</h2><p>输出语言本身也会影响 AI 输出复杂度，而且这里其实有两个不同的问题：表达语言和信息来源。</p><p>比如“用英文回答”，不仅会改变最终输出的语言，也可能改变 AI 使用的信息来源和语言分布。很多专业术语、论文、官方文档和技术规范最初就是英文，直接使用这些材料，可以减少一次翻译映射。</p><p>例如 field 在不同中文语境里可能被翻译成“场”“光场”“复振幅分布”等。这说明使用合适得语言可以增强 AI 输出稳定性，进而降低复杂度。</p><p>所以一个更稳定的提示词可以是：</p><blockquote><p>优先使用英文原始资料，但用中文回答，同时保留专业术语的英文原文。</p></blockquote><p>这样一来，一方面约束了信息来源，减少中间翻译带来的失真；另一方面又通过中文输出降低理解门槛。</p><p>前者减少了 $C_{\text{output}}$ 中由信息来源和翻译带来的不确定性，后者则提高了 $C_u$ 和 $C_a$。</p><h2 id="AI-债发生在生成还是采用"><a href="#AI-债发生在生成还是采用" class="headerlink" title="AI 债发生在生成还是采用"></a>AI 债发生在生成还是采用</h2><p>接下来还有一个定义上的问题：AI 债究竟是在生成那一刻产生的，还是在我们采用它的时候产生的？</p><p>最近在做很多调研，我越来越明显地感觉到，AI 可以一次输出大量信息，但如果缺少后续检验，信息很容易逐渐失真。</p><p>假设我想买扫地机器人，让 AI 帮我列出二十个型号并做横向比较。它可能会列出大量我完全不了解的参数，比如不同的导航技术、越障高度和集尘方式。</p><p>此时，$C_{\text{output}}$ 可能已经远远超过我的理解和审核能力。但我并不觉得自己已经欠下了 AI 债，因为这些内容目前还只是候选信息，我并没有拿它们做任何实质性的决定。</p><p>所以，AI 债是在“采用”阶段产生的，只有当我们真正接受这些内容，作为行动和决策的依据，债务才开始累积。</p><p>在上面的例子是我下单那一刻。</p><p>下面进一步讲一些常见的应用场景。</p><h2 id="场景-1：学习，允许可控超界"><a href="#场景-1：学习，允许可控超界" class="headerlink" title="场景 1：学习，允许可控超界"></a>场景 1：学习，允许可控超界</h2><p>在学习新知识时，最好让输出内容在最近学习区。不是说所有输出都低于自己的理解能力，在这种情况下，理想的状态是：</p><div class="mathjax-block">$$C_{\text{output}} = C_u + \delta$$</div><p>这里的 $\delta$ 就是我希望多学到的那一小步知识。</p><p>如果 $\delta &#x3D; 0$，说明 AI 说的东西我已经完全掌握，学习价值就很有限。如果 $\delta$ 太大，我得到的则会是一篇看起来信息量很大、实际上无法真正消化的答案。</p><p>这时候，前面提到的通俗解释、分步推理、类比和图表就有了明确作用。它们是在调节输出复杂度，让它落在刚好能够继续学习的范围内。</p><h2 id="场景-2：生产代码，守住审核边界"><a href="#场景-2：生产代码，守住审核边界" class="headerlink" title="场景 2：生产代码，守住审核边界"></a>场景 2：生产代码，守住审核边界</h2><p>代码上生产环境，真正关心的是测试覆盖率。所以</p><div class="mathjax-block">$$C_{\text{output}} &lt; C_a$$</div><p>AI 完全可以写出我自己写不出来的算法，但当我准备把这段代码合并进去时，我必须有足够的判断依据，比如测试用例、性能基准。</p><h2 id="场景-3：文章，核心逻辑需要自己覆盖"><a href="#场景-3：文章，核心逻辑需要自己覆盖" class="headerlink" title="场景 3：文章，核心逻辑需要自己覆盖"></a>场景 3：文章，核心逻辑需要自己覆盖</h2><p>文章主要强调事实和观点，如果一篇文章以我的名字发表，其中的核心观点通常需要由我自己解释和捍卫，事实需要可检验。</p><p>对于文章的核心论证部分，我更希望满足：</p><div class="mathjax-block">$$C_{\text{output}} &lt; \min(C_u, C_a)$$</div><p>也就是说，AI 可以在修辞和句法上超过我的日常表达，但是如果 AI 悄悄加入了一条我从未想过的逻辑链，比如从概念一推到概念二，再进一步延伸到概念三，而我只是读完以后觉得“好像有道理”，这是不允许的。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/10/05/2026-10-06-%E5%AE%9A%E4%B9%89%E4%B8%80%E7%A7%8DAI-%E5%80%BA/</id>
    <link href="https://believed-breadfruit.top/2026/10/05/2026-10-06-%E5%AE%9A%E4%B9%89%E4%B8%80%E7%A7%8DAI-%E5%80%BA/"/>
    <published>2026-10-05T16:00:00.000Z</published>
    <summary>用复杂度建模区分 AI 理解债与审核债，解释提示词、输出语言和应用场景怎样调节 AI 输出与个人能力之间的差距。</summary>
    <title>定义一种 AI 债</title>
    <updated>2026-10-05T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="技术" scheme="https://believed-breadfruit.top/categories/%E6%8A%80%E6%9C%AF/"/>
    <category term="数值光学" scheme="https://believed-breadfruit.top/tags/%E6%95%B0%E5%80%BC%E5%85%89%E5%AD%A6/"/>
    <category term="波动光学" scheme="https://believed-breadfruit.top/tags/%E6%B3%A2%E5%8A%A8%E5%85%89%E5%AD%A6/"/>
    <category term="FFT" scheme="https://believed-breadfruit.top/tags/FFT/"/>
    <category term="数值采样" scheme="https://believed-breadfruit.top/tags/%E6%95%B0%E5%80%BC%E9%87%87%E6%A0%B7/"/>
    <category term="Python" scheme="https://believed-breadfruit.top/tags/Python/"/>
    <content>
      <![CDATA[<h2 id="背景"><a href="#背景" class="headerlink" title="背景"></a>背景</h2><p>上一篇 <a href="https://www.believed-breadfruit.top/2026/09/13/2026-09-14-%E7%94%A8-PyTorch-%E5%AE%9E%E7%8E%B0%E4%B8%80%E4%B8%AA%E5%8F%AF%E5%BE%AE%E5%85%89%E5%AD%A6%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E7%B3%BB%E7%BB%9F/">用 PyTorch 实现一个可微光学逆向设计系统</a> 把整套 Fourier optics inverse-design pipeline 搬到了原生 PyTorch：phase modulator → ASM 传播 → mode-overlap loss → autograd → Adam。N&#x3D;250、Δx&#x3D;10 μm、λ&#x3D;700 nm、z&#x3D;0.2 m 这组参数下，optimizer 把 loss 顺利压到接近 0，整个链路跑通了。但里面 N、Δx、L、λ、z 这五个量是怎么选的，那篇文章里没问过；写好 <code>init</code> 阶段的几行代码，整个计算图就跑起来了。</p><p>可微光学里，参数本身就是模型的一部分。这五个量共同决定 forward model 能不能描述真实物理：采样点不够、Δx 太大、计算窗口装不下传播后的光场，或者传播距离与频域网格失配，forward 模型都会给出看上去合理、实际不对的 U_out。inverse design 里尤其危险：optimizer 只看得到 loss 下降，看不到 forward 内部的数值失真。误差会沿着完全正常的梯度 backprop；表面上 loss 降了，实际优化的可能只是数值伪影。</p><p>优化前应先做一次数值模拟检查，也就是 sanity check。本文用方孔衍射，依次检查网格参数、输入采样、计算窗口、频率采样、传播算子相位和传播模型的适用范围。目的很简单：确认当前 forward model 的输出能否用于 inverse design。</p><h2 id="先看方孔传播的结果"><a href="#先看方孔传播的结果" class="headerlink" title="先看方孔传播的结果"></a>先看方孔传播的结果</h2><p>输入场是一个边长为 $a&#x3D;100,\mu\mathrm m$ 的理想方孔，置于计算窗口中心：</p><div class="mathjax-block">$$N=512,\qquad\Delta x=\Delta y=2\,\mu\mathrm m,\qquad\lambda=532\,\mathrm{nm}.$$</div><p>由此得到计算窗口的物理宽度为</p><div class="mathjax-block">$$L=N\Delta x=1.024\,\mathrm{mm},$$</div><p>横纵方向覆盖 $[-0.512,,0.512],\mathrm{mm}$。</p><h3 id="输入场与角谱"><a href="#输入场与角谱" class="headerlink" title="输入场与角谱"></a>输入场与角谱</h3><p>下图左侧为输入方孔，右侧为它的二维角谱幅度。</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-8.png"></p><p>左图：方孔宽度占 50 个像素，边缘陡直，没有可见的锯齿或台阶。右图是它的二维频谱：中心一个亮峰，能量主要集中在中心十字形区域；横纵方向延伸出较弱的旁瓣。</p><h3 id="不同距离下的传播图"><a href="#不同距离下的传播图" class="headerlink" title="不同距离下的传播图"></a>不同距离下的传播图</h3><p><a href="https://github.com/ebezzam/waveprop">waveprop</a> 实现了 Fraunhofer、Fresnel、Angular Spectrum Method 和 Direct Integration。这里让四种方法都返回真实输出坐标，并在相同的物理观察窗口中比较。DI 直接离散 Rayleigh–Sommerfeld diffraction integral<sup>[1]</sup>，没有 Fresnel 或 Fraunhofer 近似，但仍受输入采样、输出窗口和离散积分误差限制，因此只把它作为交叉参考。</p><p>依次传播到</p><div class="mathjax-block">$$z=1\,\mathrm{mm},\quad10\,\mathrm{mm},\quad100\,\mathrm{mm},\quad150\,\mathrm{mm}.$$</div><p>每张图从左到右依次为 ASM、Fresnel、Fraunhofer 和 DI 四种方法在同一 ±0.5 mm 观察窗口内的结果。</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image.png" alt="z&#x3D;1 mm"></p><p><strong>z&#x3D;1 mm</strong> 时，ASM、Fresnel 和 DI 几乎重合。能量集中在中心约 0.1×0.1 mm² 的方形区域，与原始方孔差不多大；硬边衍射带来的近场干涉在方形内部留下细密的明暗纹理。Fraunhofer 在同一 ±0.5 mm 窗口内却只剩中心几颗像素，把远场图样按 z 缩到了一个亮斑。它要求传播距离远大于十几毫米，z&#x3D;1 mm 显然不在这个范围内；到了远场，这种按 z 缩放的尺度才是正常的。</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-1.png" alt="z&#x3D;10 mm"></p><p>到 z&#x3D;10 mm，方孔的轮廓已经看不出来了，但 ASM、Fresnel 和 DI 仍然一致：中心是明亮的方形主瓣，横纵方向各有几级旁瓣，整体呈十字形。Fraunhofer 依旧挤成一团中心亮斑，ASM、Fresnel 和 DI 都有的横纵旁瓣没有出现。</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-2.png" alt="z&#x3D;100 mm"></p><p>z&#x3D;100 mm 时，ASM 和 Fresnel 突然变了形：主瓣不见了，横纵方向密集的明暗条纹交叉成规则方格，亮度从中心往四边递减，条纹已经靠近窗口边缘。同一窗口里的 Fraunhofer 和 DI 则仍然平滑。Fraunhofer 是中心向外衰减的方形主瓣和横纵旁瓣，包络与输入角谱的十字形一致；DI 的形态接近，只是中心亮区在两个方向都略宽一些。</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-4.png" alt="z&#x3D;150 mm"></p><p>z&#x3D;150 mm 时，ASM 和 Fresnel 的方格继续向外铺开，几乎占满整个 1.024 mm 窗口。中心几格最亮，四边仍有可见强度，最外层已经被边界截断。Fraunhofer 和 DI 依然保持方形主瓣加横纵旁瓣的十字形结构，DI 在两个方向上都比 Fraunhofer 更宽。</p><p>Fraunhofer 和 DI 都没有这些方格，说明它们是当前数值设置引入的伪影。z&#x3D;100 mm 和 z&#x3D;150 mm 的 ASM&#x2F;Fresnel 已被离散条件污染；可能是窗口不够、FFT 周期边界的 wrap-around、传播算子欠采样，也可能是传播模型不在适用范围。</p><h2 id="这次传播需要检查的几个条件"><a href="#这次传播需要检查的几个条件" class="headerlink" title="这次传播需要检查的几个条件"></a>这次传播需要检查的几个条件</h2><h3 id="网格参数"><a href="#网格参数" class="headerlink" title="网格参数"></a>网格参数</h3><p>当前参数为</p><div class="mathjax-block">$$N=512,\qquad\Delta x=\Delta y=2\,\mu\mathrm m,\qquad\lambda=532\,\mathrm{nm}.$$</div><p>由 $\Delta x$ 与 $N$ 可以直接得到空间窗口宽度</p><div class="mathjax-block">$$L=N\Delta x=1.024\,\mathrm{mm},$$</div><p>横纵方向覆盖</p><div class="mathjax-block">$$[-0.512,\,0.512]\,\mathrm{mm}.$$</div><p>FFT 把空间域映射到频域后，频率采样间隔由 $L$ 唯一决定：</p><div class="mathjax-block">$$\Delta f=\frac{1}{L}\approx976.6\,\mathrm{m^{-1}}=0.9766\,\mathrm{mm^{-1}}.$$</div><p>对应的 Nyquist frequency 则由 $\Delta x$ 决定：</p><div class="mathjax-block">$$f_N=\frac{1}{2\Delta x}=2.5\times10^5\,\mathrm{m^{-1}}=250\,\mathrm{mm^{-1}}.$$</div><p>$\Delta x$ 决定输入场在空间域里采得够不够细；$L$ 决定传播后的光场会不会跑出窗口；$\Delta f$ 决定输入频谱与 propagation kernel 在频域里采得够不够密。</p><h3 id="输入采样"><a href="#输入采样" class="headerlink" title="输入采样"></a>输入采样</h3><p>空域看方孔轮廓是否被充分采样，频域看主要频谱能量是否集中在远离 Nyquist 边界的区域、并且其结构是否被 $\Delta f$ 充分描述。</p><h4 id="空域检查"><a href="#空域检查" class="headerlink" title="空域检查"></a>空域检查</h4><p>输入方孔宽度为</p><div class="mathjax-block">$$a=100\,\mu\mathrm m.$$</div><p>在当前网格上横向占</p><div class="mathjax-block">$$\frac{a}{\Delta x}=50$$</div><p>个像素。方孔宽度由 50 个采样点表示，轴对齐边界没有明显的栅格化失真。</p><h4 id="频域检查"><a href="#频域检查" class="headerlink" title="频域检查"></a>频域检查</h4><p>对输入场做二维 Fourier transform：</p><div class="mathjax-block">$$A(f_x,f_y)=\mathcal F\{U_0(x,y)\},$$</div><p>频谱能量为</p><div class="mathjax-block">$$S(f_x,f_y)=|A(f_x,f_y)|^2.$$</div><p>方孔存在硬边，因此频谱呈 sinc 型，没有有限带宽。这里定义边缘能量比 $\eta_{\mathrm{edge}}$，统计 Nyquist 频带最外侧 $20%$ 内的能量占比：</p><div class="mathjax-block">$$\eta_{\mathrm{edge}}=\frac{\displaystyle\sum_{|f_x|&gt;0.8f_N\ \mathrm{or}\ |f_y|&gt;0.8f_N}|A(f_x,f_y)|^2}{\displaystyle\sum_{f_x,f_y}|A(f_x,f_y)|^2}.$$</div><p>当前参数下得到</p><div class="mathjax-block">$$\eta_{\mathrm{edge}}\approx0.42\%.$$</div><p>输入频谱几乎完全集中在 $|f|&lt;0.8f_N$ 的内部区域，只有方孔硬边引入的高频尾部（约 $0.42%$ 的能量）落在最外侧 $20%$ 的频带内。</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-5.png"></p><p>上图左为输入方孔，右为它的二维角谱。红实线方框是外圈能量占比对应的频率区域，橙虚线方框是 sinc 主瓣。两块之间的空白区域就是被求和的高频尾部，对应 0.42% 的量化结果。</p><p>再看频域分辨率。方孔 sinc 频谱从中心到第一零点的频率尺度为</p><div class="mathjax-block">$$\frac{1}{a}=10^4\,\mathrm{m^{-1}}=10\,\mathrm{mm^{-1}}.$$</div><p>当前</p><div class="mathjax-block">$$\Delta f=0.9766\,\mathrm{mm^{-1}},$$</div><p>因此在一个 $1&#x2F;a$ 的频率尺度内大约有</p><div class="mathjax-block">$$\frac{10}{0.9766}\approx10.2$$</div><p>个采样点。这一密度足以分辨 sinc 主瓣的形状，也能描述至少一两级旁瓣。</p><h4 id="小结"><a href="#小结" class="headerlink" title="小结"></a>小结</h4><p>当前网格在输入这一侧没有明显问题：</p><table><thead><tr><th>检查项</th><th>当前量化</th><th>状态</th></tr></thead><tbody><tr><td>空间采样</td><td>$a&#x2F;\Delta x &#x3D; 50$ 像素</td><td>充足</td></tr><tr><td>频域边缘能量</td><td>$\eta_{\mathrm{edge}}\approx 0.42%$</td><td>充足</td></tr><tr><td>频域分辨率</td><td>$\sim 10.2$ 点 $&#x2F;1&#x2F;a$</td><td>充足</td></tr></tbody></table><p>因此，100 mm 和 150 mm 的异常主要不在输入场，而在后续的离散条件。</p><h3 id="计算窗口"><a href="#计算窗口" class="headerlink" title="计算窗口"></a>计算窗口</h3><p>传播后的光场还能不能留在当前 $L&#x3D;1.024,\mathrm{mm}$ 的窗口里？</p><p>窗口半宽为</p><div class="mathjax-block">$$\frac{L}{2}=0.512\,\mathrm{mm}.$$</div><h4 id="频域估算"><a href="#频域估算" class="headerlink" title="频域估算"></a>频域估算</h4><p>对于空间频率 $f$，近轴条件下的传播角约为</p><div class="mathjax-block">$$\theta\approx\lambda f,$$</div><p>传播距离 $z$ 后的横向位移约为</p><div class="mathjax-block">$$x\approx\lambda zf.$$</div><p>要求这部分光场仍然位于半窗口 $L&#x2F;2$ 内，可以定义安全频率</p><div class="mathjax-block">$$f_{\mathrm{safe}}(z)=\frac{L}{2\lambda z}.$$</div><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-6.png"></p><p>上图是输入角谱的中心截面，标出 sinc 第一零点（±10 mm⁻¹）、Nyquist 边界（±250 mm⁻¹）和四个距离对应的安全频率。z&#x3D;1 mm、10 mm 时，安全频率还在第一零点外；z&#x3D;100 mm 时降到 9.62 mm⁻¹，已经落进主瓣；z&#x3D;150 mm 时只有 6.42 mm⁻¹，主瓣里已有一部分频率分量会越过窗口半宽。</p><h4 id="空域估算"><a href="#空域估算" class="headerlink" title="空域估算"></a>空域估算</h4><p>从空间域也能得到同样的结论。方孔远场第一零点的位置约为</p><div class="mathjax-block">$$x_1\approx\frac{\lambda z}{a}.$$</div><p>代入当前参数：</p><table><thead><tr><th>$z$</th><th align="right">$1,\mathrm{mm}$</th><th align="right">$10,\mathrm{mm}$</th><th align="right">$100,\mathrm{mm}$</th><th align="right">$150,\mathrm{mm}$</th></tr></thead><tbody><tr><td>$x_1$</td><td align="right">$\approx 5.32,\mu\mathrm m$</td><td align="right">$\approx 53.2,\mu\mathrm m$</td><td align="right">$\approx 532,\mu\mathrm m$</td><td align="right">$\approx 798,\mu\mathrm m$</td></tr></tbody></table><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-7.png"></p><p>上图是 ASM、Fresnel、Fraunhofer、DI 在中心水平截面上的归一化强度，从左到右 z&#x3D;1、10、100、150 mm，黑色虚线为 Rayleigh–Sommerfeld 直接离散积分结果。z&#x3D;1 mm 与 z&#x3D;10 mm 时，ASM、Fresnel 和 DI 基本重合；z&#x3D;100 mm、z&#x3D;150 mm 时，ASM 与 Fresnel 在 DI 主瓣附近叠加了密集振荡，Fraunhofer 与 DI 仍是平滑曲线。</p><p>原窗口半宽只有 $512,\mu\mathrm m$。$z&#x3D;100,\mathrm{mm}$ 时，第一零点已贴近窗口边缘；$z&#x3D;150,\mathrm{mm}$ 时，它比窗口半宽大约多出 $56%$，主瓣外的结构会被截断。</p><h4 id="Padding-convergence-直接验证"><a href="#Padding-convergence-直接验证" class="headerlink" title="Padding convergence 直接验证"></a>Padding convergence 直接验证</h4><p>保持 $\Delta x&#x3D;2,\mu\mathrm m$ 不变，将网格依次扩大为 $N$、$2N$、$4N$，对应的窗口为</p><div class="mathjax-block">$$L: 1.024\rightarrow 2.048\rightarrow 4.096\,\mathrm{mm}.$$</div><p>传播完成后，只比较三种网格共同覆盖的中心感兴趣区域（Region of Interest，下称 ROI）：</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-9.png"></p><p>短距离下，padding convergence 已经稳定。z&#x3D;1 mm 和 z&#x3D;10 mm 的两条曲线都在 10⁻⁵ 量级以下，没有碰到 WARN 阈值；继续增大网格，差异可以忽略。</p><p>从 z&#x3D;100 mm 开始就不同了：1N→2N 已越过 FAIL 阈值，z&#x3D;150 mm 时误差接近 25%；2N→4N 仍高于 WARN，说明 4N 也还不够。</p><p>原始 N&#x3D;512 配置只在 z&#x3D;1 mm、z&#x3D;10 mm 下可信。z&#x3D;150 mm 时，网格每翻一倍确实都在改善：1N→2N 的误差为 25%，2N→4N 已降到 8%，但还没有收敛。</p><p>在 padding convergence 收敛前做 inverse design，forward model 输出本身就不稳定。</p><h4 id="Zero-padding-与真实增大-N-的区别"><a href="#Zero-padding-与真实增大-N-的区别" class="headerlink" title="Zero-padding 与真实增大 $N$ 的区别"></a>Zero-padding 与真实增大 $N$ 的区别</h4><p>这里的 padding convergence，就是比较 zero-padding 的效果。补零不改变原始输入的物理采样 $\Delta x$ 或方孔宽度 $a$，只是在传播前把数组扩到</p><div class="mathjax-block">$$N_{\mathrm{pad}}=1024\ \text{或}\ 2048,$$</div><p>再做 FFT。原始输入场仍定义在 $512\times512$ 网格上，$\Delta x$ 不变；变大的是计算数组：</p><div class="mathjax-block">$$L_{\mathrm{pad}}=N_{\mathrm{pad}}\Delta x,\qquad\Delta f_{\mathrm{pad}}=\frac{1}{N_{\mathrm{pad}}\Delta x}.$$</div><p>waveprop 的部分 FFT propagator 已内置 zero-padding。以 angular_spectrum 和 fresnel_conv 为例，<code>pad=True</code> 会先将输入网格扩到默认的 2 倍，即从 512×512 补到 1024×1024；传播在更大的数组上完成，最后裁回原输出区域。原始输入的 $\Delta x$ 和 $N$ 不变，FFT 内部使用更大的计算网格，以减轻 circular convolution 和周期边界的影响。</p><p>Fresnel 和 ASM 在 zero padding 之后的结果：</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-10.png" alt="z&#x3D;100 mm, with zero-padding"><br><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-11.png" alt="z&#x3D;150 mm, with zero-padding"></p><p>相较未加 padding 的 N&#x3D;512 结果，ASM&#x2F;Fresnel 的方格变细了，也更均匀；图中可见的间距也变小。zero-padding 将 $\Delta f$ 减半，但方格仍铺满 ±0.5 mm 窗口。Fraunhofer 和 DI 仍是平滑的方形主瓣加横纵旁瓣，没有方格。补零缓解了一部分问题，计算窗口却依然不够；waveprop 默认的 2 倍 zero-padding 对长距离传播仍然偏紧。</p><p>保持 zero-padding，再把 $N$ 真正提高到 1024。$\Delta x&#x3D;2,\mu\mathrm m$ 不变：</p><div class="mathjax-block">$$L: 1.024\rightarrow 2.048\,\mathrm{mm},\qquad\Delta f: 976.6\rightarrow 488.3\,\mathrm{m^{-1}}.$$</div><p>得到 $z&#x3D;100,\mathrm{mm}$ 和 $z&#x3D;150,\mathrm{mm}$ 下四种方法的光场分布图：</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-13.png" alt="z&#x3D;100 mm, N&#x3D;1024, with zero-padding"><br><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-14.png" alt="z&#x3D;150 mm, N&#x3D;1024, with zero-padding"></p><p>观察窗口扩大到 ±1.024 mm 后，z&#x3D;100 mm 下四种方法都出现了中心方形主瓣和横纵旁瓣，主瓣尺度也与 Fraunhofer 的远场估算一致。ASM&#x2F;Fresnel 中心仍有一层细密方格；$\Delta f$ 减半后，它的间距变小了，但不再铺满整个窗口。</p><p>z&#x3D;150 mm 时，亮斑继续变大，四种方法的整体形态也更接近。不过 ASM&#x2F;Fresnel 中心仍看得到网格。输入频谱并不是问题，传播算子的频域采样却仍然不够：z&#x3D;100 mm 和 z&#x3D;150 mm 时，kernel 相位随频率的变化比当前 $\Delta f$ 能分辨的更快，kernel 本身已有欠采样风险，这也解释了中心纹理为何没有消失。</p><p>下图给出 ASM、Fresnel、Fraunhofer 与 DI 的中心截面比较。横轴是传播距离 $z$，纵轴是归一化 MSE；上图为 N&#x3D;512、无 padding，下图为 N&#x3D;1024、加 zero-padding。</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-18.png" alt="Normalized MSE vs z, N&#x3D;512 no padding, no bandlimit"><br><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-15.png" alt="Normalized MSE vs propagation distance, N&#x3D;1024 with zero-padding, no bandlimit"></p><p>两图的对比重点是 ASM&#x2F;Fresnel。Fraunhofer 在远场的两组配置下与 DI 的曲线几乎重叠，这符合逻辑；z&#x3D;150 mm 时 ASM&#x2F;Fresnel vs DI 的 MSE 从约 0.165&#x2F;0.185 降到约 0.018&#x2F;0.048，差不多压了一个数量级，但仍未归零。因为剩余差距里既有 kernel 频域欠采样的成分，也可能夹着周期边界伪影，目前还无法把原因唯一归到某一种数值机制上。</p><h3 id="频率采样"><a href="#频率采样" class="headerlink" title="频率采样"></a>频率采样</h3><p>在 N&#x3D;1024 加 zero-padding 之后，ASM&#x2F;Fresnel 中心仍有细密网格。padding 收敛把 z&#x3D;150 mm 处的误差从约 25% 压到约 8%，但没归零。输入频谱本身没问题：能量主要落在远离 Nyquist 的区域，不是这个纹理的主因。</p><p>可能是当前频域网格对 propagation kernel 采得不够密。BLAS<sup>[2]</sup> 类的 band-limit 正是针对这一频段；若开启 BLAS 后网格消失，说明 kernel 的频域欠采样很可能是主要来源。</p><h4 id="ASM-传播算子"><a href="#ASM-传播算子" class="headerlink" title="ASM 传播算子"></a>ASM 传播算子</h4><p>Angular Spectrum Method 的传播关系是</p><div class="mathjax-block">$$U_z(x,y)=\mathcal F^{-1}\!\left[\mathcal F\{U_0\}\,H(f_x,f_y)\right],$$</div><p>其中</p><div class="mathjax-block">$$H(f_x,f_y)=\exp\!\left[i2\pi z\sqrt{\tfrac{1}{\lambda^2}-f_x^2-f_y^2}\right].$$</div><p>在标量 Helmholtz 范围内，ASM 不含 Fresnel 近似；问题在于，计算机只能采样离散的 $H(f_x,f_y)$。</p><p>令</p><div class="mathjax-block">$$H(f)=e^{i\phi(f)},\qquad\phi(f)=2\pi z\sqrt{\tfrac{1}{\lambda^2}-f^2}.$$</div><p>FFT 的频率格点为</p><div class="mathjax-block">$$f_m=m\Delta f,\qquad\Delta f=\frac{1}{L}=\frac{1}{N\Delta x}.$$</div><p>$\phi(f)$ 的局部斜率是：</p><div class="mathjax-block">$$\frac{d\phi}{df}=-\frac{2\pi z f}{\sqrt{1/\lambda^2-f^2}}.$$</div><p>当 $f\to 1&#x2F;\lambda$ 时，分母 $\sqrt{1&#x2F;\lambda^2-f^2}\to 0$，于是</p><div class="mathjax-block">$$\left|\frac{d\phi}{df}\right|\to\infty.$$</div><p>高空间频率处，$H(f)$ 的相位变化很快。相邻频率点 $f_m$、$f_{m+1}$ 之间，真实相位可能已跨过 $3\pi$、$6\pi$，采样却只留下两个点。这就是 transfer function 的 aliasing：$H(f)$ 本身被 undersampled。</p><h4 id="当前参数下的相步估计"><a href="#当前参数下的相步估计" class="headerlink" title="当前参数下的相步估计"></a>当前参数下的相步估计</h4><p>下面切到 $N&#x3D;1024$、$\Delta x&#x3D;2,\mu\mathrm m$ 的网格：</p><div class="mathjax-block">$$L=2.048\,\mathrm{mm},\qquad\Delta f=488.3\,\mathrm{m^{-1}}.$$</div><p>$\Delta f$ 不随 $z$ 改变，$\phi$ 对频率的变化速度却会随 $z$ 增大。沿 $f_x$ 方向，</p><div class="mathjax-block">$$\frac{\partial\phi_H}{\partial f_x}=-\frac{2\pi z f_x}{\sqrt{1/\lambda^2-f_x^2-f_y^2}},$$</div><p>所以相邻频率点间的 phase step 近似为</p><div class="mathjax-block">$$\Delta\phi_H\approx\left|\frac{\partial\phi_H}{\partial f_x}\right|\Delta f,$$</div><p>即</p><div class="mathjax-block">$$\Delta\phi_H\propto z\Delta f.$$</div><p>与 $N&#x3D;512$ 相比，$\Delta f$ 已减半，因此相同有效频带内的 phase step 也约减半。</p><p>取包含输入角谱 $99.9%$ 能量的有效频带</p><div class="mathjax-block">$$f_{\mathrm{eff}}\approx2.23\times10^5\,\mathrm{m^{-1}},$$</div><p>并在其中计算</p><div class="mathjax-block">$$\Delta\phi_{\max}=\max\left|\phi_H(f_x+\Delta f,f_y)-\phi_H(f_x,f_y)\right|,$$</div><p>四个距离下的结果为：</p><table><thead><tr><th>$z$</th><th align="right">$1,\mathrm{mm}$</th><th align="right">$10,\mathrm{mm}$</th><th align="right">$100,\mathrm{mm}$</th><th align="right">$150,\mathrm{mm}$</th></tr></thead><tbody><tr><td>$\Delta\phi_{\max}$</td><td align="right">$\approx 0.117\pi$</td><td align="right">$\approx 1.17\pi$</td><td align="right">$\approx 11.7\pi$</td><td align="right">$\approx 17.5\pi$</td></tr></tbody></table><p>将 $\Delta\phi_H\approx\pi$ 作为工程警戒线：$z&#x3D;1,\mathrm{mm}$ 相对安全，$z&#x3D;10,\mathrm{mm}$ 刚越线；$z&#x3D;100,\mathrm{mm}$ 和 $z&#x3D;150,\mathrm{mm}$ 的 propagator undersampling 风险仍然明显。</p><p>将 $N$ 从 512 提高到 1024，frequency sampling 确实改善了，但仍不足以覆盖长距离传播。窗口虽扩大一倍，z&#x3D;100 mm 和 z&#x3D;150 mm 时 propagation kernel 的相位变化仍比当前 frequency grid 快一个数量级以上。</p><p>Matsushima 和 Shimobaba<sup>[2]</sup>提出 BLAS，正是为处理标准 ASM 的 transfer function 在有限采样、有限窗口和传播几何共同限制下产生的误差。它裁去当前网格无法可靠传播的高频部分。</p><p>waveprop 可以直接开启 bandlimit：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 公共 API：angular_spectrum 返回 (u_out, x_out, y_out)；这里显式开启 bandlimit 与 padding</span></span><br><span class="line">u_asm, x_asm, y_asm = angular_spectrum(U0, wavelength, dx, z, bandlimit=<span class="literal">True</span>, pad=<span class="literal">True</span>)</span><br><span class="line"></span><br><span class="line">u_fres, _, _ = fresnel_conv(U0, wavelength, dx, d2_out, z, pad=<span class="literal">True</span>)</span><br></pre></td></tr></table></figure><p>启用 bandlimit 后，$z&#x3D;100,\mathrm{mm}$ 和 $z&#x3D;150,\mathrm{mm}$ 的结果如下：</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-16.png" alt="z&#x3D;100 mm, N&#x3D;1024, band-limited ASM"><br><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-17.png" alt="z&#x3D;150 mm, N&#x3D;1024, band-limited ASM"></p><p>启用 bandlimit 后，z&#x3D;100 mm 和 z&#x3D;150 mm 的 ASM 中心方格几乎消失，亮斑也与 DI 几乎贴合。这支持 kernel 欠采样是原有纹理主要来源的判断。</p><p>网格取 $N&#x3D;1024$，加入 zero-padding 并开启 bandlimit 后，ASM、Fresnel、Fraunhofer 与 DI 的中心截面比较如下：</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-19.png" alt="Normalized MSE vs z, N&#x3D;1024 + zero-padding"><br><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-21.png" alt="Normalized MSE vs z, N&#x3D;1024 + zero-padding + band-limit (BLAS)"></p><p>z&#x3D;100 mm、z&#x3D;150 mm 时，ASM&#x2F;Fresnel 的 MSE 明显降低。以 z&#x3D;100 mm 为例，ASM 从约 0.066 降到约 0.01，Fresnel 从约 0.081 降到约 0.005；z&#x3D;150 mm 时，ASM 约为 0.018，Fresnel 为 0.048。ASM 相对 DI 的误差已接近 0；Fresnel 因 paraxial approximation 仍保留约 0.048 的差距。</p><p>下图是中心水平截面的归一化强度，从左到右为 $z&#x3D;1,,10,,100,,150,\mathrm{mm}$；黑色虚线为 DI。</p><p><img src="/../images/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/image-20.png" alt="Central cross-sections of intensity"></p><p>z&#x3D;1 mm、10 mm 时，ASM、Fresnel 与 DI 基本重合，Fraunhofer 仍明显偏离。z&#x3D;100 mm、150 mm 时，ASM 与 DI 在共同 ROI 和容差内几乎贴合；Fresnel 的主瓣上仍有 paraxial approximation 带来的高频振荡。</p><h3 id="传播模型适用性"><a href="#传播模型适用性" class="headerlink" title="传播模型适用性"></a>传播模型适用性</h3><p>模型选择和离散网格是两层问题。Fresnel 用 paraxial 近似，Fraunhofer 用远场近似，ASM 使用完整的标量 $k_z$，DI 则直接离散 Rayleigh–Sommerfeld 积分。它们的物理假设不同；即便输入场和网格相同，结果也不一定应当相同。</p><p>传播距离 $z$ 会同时影响两层条件。距离太短时，Fresnel 和 Fraunhofer 的近似可能还不成立；距离变长后，ASM 的 kernel 相位又可能快过频域网格的采样速度。每次改变传播距离，都要重新检查模型假设和离散条件。</p><p>在 differentiable optics 中，后续优化无法补救选错的传播模型。若在 $z&#x3D;1,\mathrm{mm}$ 用 Fraunhofer 反传，autograd 会按远场 sinc 模式调整 phase map，loss 可以持续下降，目标却不是实际的近场光场。长距离 ASM 不开 bandlimit 也是一样：autograd 会把欠采样 kernel 产生的网格纹理写进 phase map；loss 下降了，相位图里却混入数值伪影。</p><h4 id="误差的两类来源"><a href="#误差的两类来源" class="headerlink" title="误差的两类来源"></a>误差的两类来源</h4><p>比较 Fresnel、ASM 和 DI 的输出前，先把公式本身的近似和网格造成的误差分开：</p><div class="mathjax-block">$$\text{总误差} = \text{传播模型近似误差} + \text{数值离散误差}.$$</div><p>Taylor 截断、远场假设和倏逝波处理，属于公式层面的近似；kernel 相位 aliasing、有限孔径、quadrature 和 circular convolution，则来自离散网格。同一个 ASM 在 $N&#x3D;1024$、padding 与 BLAS 都开启时表现良好，在 $N&#x3D;512$ 上却出现方格，说明问题出在离散条件，公式本身没有变。下面分别看模型近似和传播算子的离散误差。</p><h5 id="传播模型的近似误差"><a href="#传播模型的近似误差" class="headerlink" title="传播模型的近似误差"></a>传播模型的近似误差</h5><p>ASM、Fresnel、Fraunhofer 的关系可以直接从 ASM 的传播相位展开来看<sup>[3]</sup>：<br>$$<br>\phi_{ASM}(f_x, f_y) &#x3D; 2\pi z \sqrt{\tfrac{1}{\lambda^2} - f_x^2 - f_y^2}.<br>$$</p><p>对 $\sqrt{1 - \lambda^2(f_x^2+f_y^2)}$ 在零频附近展开：<br>$$<br>\phi_{ASM} &#x3D; \tfrac{2\pi z}{\lambda} - \pi\lambda z (f_x^2+f_y^2) - \tfrac{\pi}{4}\lambda^3 z (f_x^2+f_y^2)^2 + O(f^6).<br>$$</p><p>去掉与频率无关的全局相位，Fresnel 只保留二次项：<br>$$<br>\phi_{Fresnel} &#x3D; -\pi\lambda z (f_x^2 + f_y^2).<br>$$<br>Fraunhofer 在相位近似上也忽略这一二次项，并将输出写成按距离缩放的傅里叶变换。</p><p>对边长为 $a$ 的孔径，Fraunhofer 忽略二次相位后产生的最大相差为<br>$$<br>\max|\Delta\phi_{Fr \leftarrow F}| &#x3D; \tfrac{\pi a^2}{4\lambda z} &#x3D; \tfrac{\pi N_F}{4},<br>\qquad N_F &#x3D; \tfrac{a^2}{\lambda z}.<br>$$<br>$N_F$ 是 Fresnel 数。$N_F\gg1$ 仍是近场，$N_F\ll1$ 才进入 Fraunhofer 的远场范围。这个 $100,\mu\mathrm m$ 方孔在 $532,\mathrm{nm}$ 波长下，$a^2&#x2F;\lambda\approx18.8,\mathrm{mm}$。$z&#x3D;10,\mathrm{mm}$ 时 $N_F\approx1.88$，Fraunhofer 还不适用；$z&#x3D;100,\mathrm{mm}$ 和 $150,\mathrm{mm}$ 时分别为 $0.188$、$0.125$，可视为这组参数下的远场。</p><p>Fresnel 舍去四阶及更高阶项。以 $\sin\theta&#x3D;\lambda f$ 把空间频率写成传播角度，Fresnel 相对 ASM 漏掉的第一项相位为<br>$$<br>\Delta\phi_{F \leftarrow A} &#x3D; \tfrac{\pi z \sin^4\theta}{4\lambda}.<br>$$<br>$\Delta\phi_{F \leftarrow A}$ 表示同一角度分量传播距离 $z$ 后，Fresnel 与 ASM 累积的相位差。Fresnel 以二次相位近似精确的平方根相位；当这项差异接近 $1,\mathrm{rad}$，两者对该频率分量的相位预测就会明显分开。若保守地要求相位余项远小于 $1,\mathrm{rad}$，则有<br>$$<br>z \ll \tfrac{4\lambda}{\sin^4\theta}.<br>$$<br>这不是严格的物理边界，$1,\mathrm{rad}$ 只是在量级上筛查近似误差会不会影响结果。Fresnel 能否使用也不只取决于距离，还要看准备保留的传播角度：角度越大，舍去的四阶相位累积得越快。</p><p>主瓣第一零点处，$\theta_1&#x3D;\lambda&#x2F;a\approx5.3,\mathrm{mrad}$，对应距离上限约为 $2.7,\mathrm{km}$，所以 $1$ 至 $150,\mathrm{mm}$ 内的主瓣可用 Fresnel 描述。若要保留 $5^\circ$ 的旁瓣，界限缩到约 $37,\mathrm{mm}$；$10^\circ$ 时仅约 $2.3,\mathrm{mm}$。这和 Fraunhofer 的远场条件并不是同一件事：同一距离上，Fraunhofer 可能已足够描述孔径形成的远场主瓣，Fresnel 对宽角旁瓣的相位却仍会偏离 ASM。</p><p>ASM 没有 Fresnel 的 Taylor 截断。对传播波，它使用完整的标量 $k_z$；令 $q&#x3D;\sqrt{f_x^2+f_y^2}$，倏逝波对应 $q&gt;1&#x2F;\lambda$，需要另行处理。许多实现会直接将它们置零，但近场、sub-wavelength 或 metasurface 问题可能正需要这部分信号。这时可以估计目标面仍保留的倏逝波能量：<br>$$<br>\eta_{\rm ev}(z) &#x3D; \tfrac{\iint_{q&gt;1&#x2F;\lambda} |\tilde U_0|^2 \exp[-4\pi z\sqrt{q^2-1&#x2F;\lambda^2}]}{\iint |\tilde U_0|^2}.<br>$$</p><p>Forbes<sup>[5]</sup>指出，衍射积分中的振荡项会彼此抵消，因此这类相位余项适合作为保守筛查量。Southwell<sup>[4]</sup>给出的实验误差可用于量级参照。</p><h5 id="传播算子的离散误差"><a href="#传播算子的离散误差" class="headerlink" title="传播算子的离散误差"></a>传播算子的离散误差</h5><p>DI 直接离散 Rayleigh–Sommerfeld 积分，不含 Fresnel 或 Fraunhofer 的 Taylor 截断；但输入采样、积分求积、有限孔径和输出网格仍会带来误差。FFT-DI 还要处理 circular convolution 与 zero padding<sup>[1]</sup>。</p><p>ASM 的离散误差主要出在传播算子。距离变长后，相邻频率格点的相位可能跨过多个 $\pi$，当前 $\Delta f$ 无法采准高频部分，输出便会出现并不存在的网格纹理。zero-padding 会加密频率网格，能减轻但不保证消除误差。活动频带的 phase-step，以及不同 padding 下结果是否稳定，才决定当前 ASM 能不能用。若 BLAS 裁掉不可靠频带后重新贴合已收敛的 DI，就可以把纹理归因于 propagation kernel 的离散采样。</p><p>同一个 ASM 在 $N&#x3D;512$ 上出现方格，在 $N&#x3D;1024$ 加 padding 和 BLAS 后贴合 DI，变的只是离散条件。若用未限带的 ASM 做长距离 inverse design，优化器会把这些纹理当作可利用的结构；loss 即使下降，phase map 也不会对应实验中的光场。</p><h4 id="当前参数下的选型"><a href="#当前参数下的选型" class="headerlink" title="当前参数下的选型"></a>当前参数下的选型</h4><p>这组方孔的模型假设和离散网格都得通过检查。$N_F$ 用来判断 Fraunhofer 的远场假设；活动频带内的 $\Delta\phi_{\max}$ 用来判断 ASM 的 kernel 是否欠采样；padding convergence 则检查有限窗口和周期边界是否已经收敛。表中的 phase-step 使用 $N&#x3D;1024$ 时的频域网格。</p><table><thead><tr><th>$z$</th><th align="right">$N_F$</th><th align="right">$\Delta\phi_{\max}$</th><th>选择</th></tr></thead><tbody><tr><td>$1,\mathrm{mm}$</td><td align="right">$18.8$</td><td align="right">$0.117\pi$</td><td>Fresnel 或 ASM。窗口收敛后不需要 BLAS。</td></tr><tr><td>$10,\mathrm{mm}$</td><td align="right">$1.88$</td><td align="right">$1.17\pi$</td><td>Fraunhofer 仍不适用。主瓣可用 Fresnel；若采用 ASM，需处理 kernel 的欠采样。</td></tr><tr><td>$100,\mathrm{mm}$</td><td align="right">$0.188$</td><td align="right">$11.7\pi$</td><td>Fraunhofer 已进入适用范围。若需要 ASM 的完整场，须加 padding 和 BLAS。</td></tr><tr><td>$150,\mathrm{mm}$</td><td align="right">$0.125$</td><td align="right">$17.5\pi$</td><td>Fraunhofer 可用；ASM 还要通过 padding convergence。$1N\to2N$ 的边缘能量约为 $22.4%$，原窗口不能直接使用。</td></tr></tbody></table><h4 id="度量与-reference-选择"><a href="#度量与-reference-选择" class="headerlink" title="度量与 reference 选择"></a>度量与 reference 选择</h4><p>有些指标在传播前就能算出：传播算子的 phase-step 取决于 $z$、$\Delta f$ 和活动频带；倏逝波残余 $\eta_{\rm ev}(z)$ 可由输入角谱和距离估计；Fresnel 相对 ASM 的相位余项也只应在实际有能量的频带内取最大值。若把它们扩到整个 FFT 网格，最大值可能落在空频段，对当前光场没有参考价值。</p><p>模型和网格条件通过后，再比较输出场。若关心目标面的光强，可用</p><div class="mathjax-block">$$\epsilon_I = \frac{\|I_{\rm test}-I_{\rm ref}\|_2}{\|I_{\rm ref}\|_2}.$$</div><p>如果 phase map 还要送入后续设计，就应比较复振幅。两组场可能只差一个没有物理意义的全局相位，先令</p><div class="mathjax-block">$$\alpha = \arg\left[\sum U_{\mathrm{ref}}^* U_{\mathrm{test}}\right],\qquadU_{\mathrm{test}}' = U_{\mathrm{test}} e^{-i\alpha},$$</div><p>并计算</p><div class="mathjax-block">$$\epsilon_U = \frac{\left\|U_{\mathrm{test}}' - U_{\mathrm{ref}}\right\|_2}{\left\|U_{\mathrm{ref}}\right\|_2}.$$</div><p>局部相位差为 $\arg\left(U_{\mathrm{test}}’ U_{\mathrm{ref}}^*\right)$。暗区的 $|U|$ 接近零，phase 本身不稳定，统计时只保留 $I_{\mathrm{ref}}&gt;10^{-3}I_{\max}$ 的区域。不同传播器返回的输出坐标未必一致，比较前需插值到共同 ROI。</p><p>Fresnel 可与 ASM 对照，ASM 可与 DI 对照。DI 要充当 reference，自身也必须通过积分和网格收敛检查。允许的误差取决于任务：只比较目标面光强，和把复振幅继续送入后续设计，对精度的要求不同。</p><h2 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h2><p>这次方孔实验里，输入端的采样没有明显问题：方孔宽度由 50 个像素表示，主要频谱能量也远离 Nyquist 边界。真正限制结果的是传播后的离散条件。距离增大后，1.024 mm 的窗口装不下主瓣及其旁瓣，FFT 的周期边界开始影响结果；同时，ASM 的传播算子在频域中变化过快，有限的 $\Delta f$ 无法可靠采样，输出里便出现了并不存在的网格纹理。</p><p>因此，做 inverse design 之前，不能只确认代码能跑、loss 能降。至少要检查输入采样、计算窗口、padding convergence、活动频带内的 kernel phase-step，以及所选传播模型的适用范围。对这组参数而言，短距离下 Fresnel 或 ASM 都能使用；长距离若需要 ASM 的完整场，则应扩大网格、加入 zero-padding，并启用 band-limit，再用已收敛的 DI 或其他可信 reference 对照输出。</p><p>这些检查并不保证模型已经等同于实验系统，但能先排除一类更基础的问题：优化器是否在利用 forward model 的数值误差。forward model 没有收敛时，梯度再正确，也只会把伪影写进 phase map。</p><h2 id="参考文献"><a href="#参考文献" class="headerlink" title="参考文献"></a>参考文献</h2><p>[1] Shen, F. &amp; Wang, A. (2006). <em>Fast-Fourier-transform based numerical integration method for the Rayleigh–Sommerfeld diffraction formula</em>. Applied Optics 45(6), 1102–1110. <a href="https://doi.org/10.1364/AO.45.001102">DOI</a></p><p>[2] Matsushima, K. &amp; Shimobaba, T. (2009). <em>Band-Limited Angular Spectrum Method for Numerical Simulation of Free-Space Propagation in Far and Near Fields</em>. Optics Express 17(22), 19662–19673. <a href="https://doi.org/10.1364/OE.17.019662">DOI</a></p><p>[3] Goodman, J. W. (2005). <em>Introduction to Fourier Optics</em>. Roberts &amp; Company Publishers. 3rd edition.</p><p>[4] Southwell, W. H. (1981). <em>Validity of the Fresnel approximation in the near field</em>. JOSA 71(1), 7–14. <a href="https://doi.org/10.1364/JOSA.71.000007">DOI</a></p><p>[5] Forbes, G. W. (1996). <em>Validity of the Fresnel approximation in the diffraction of collimated beams</em>. JOSA A 13(9), 1816–1826. <a href="https://doi.org/10.1364/JOSAA.13.001816">DOI</a></p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/09/20/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/</id>
    <link href="https://believed-breadfruit.top/2026/09/20/2026-09-21-%E4%BD%A0%E7%9A%84Loss%E5%9C%A8%E4%B8%8B%E9%99%8D-%E4%BD%86%E4%BC%98%E5%8C%96%E7%9A%84%E5%8F%AF%E8%83%BD%E5%8F%AA%E6%98%AF%E6%95%B0%E5%80%BC%E4%BC%AA%E5%BD%B1/"/>
    <published>2026-09-20T16:00:00.000Z</published>
    <summary>通过一次方孔传播实验，检查输入采样、计算窗口、频域采样和传播模型怎样共同影响数值波传播结果。</summary>
    <title>你的 Loss 在下降，但优化的可能只是数值伪影</title>
    <updated>2026-09-20T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="技术" scheme="https://believed-breadfruit.top/categories/%E6%8A%80%E6%9C%AF/"/>
    <category term="differentiable optics" scheme="https://believed-breadfruit.top/tags/differentiable-optics/"/>
    <category term="inverse design" scheme="https://believed-breadfruit.top/tags/inverse-design/"/>
    <category term="PyTorch" scheme="https://believed-breadfruit.top/tags/PyTorch/"/>
    <category term="TorchOptics" scheme="https://believed-breadfruit.top/tags/TorchOptics/"/>
    <category term="accelerating beam" scheme="https://believed-breadfruit.top/tags/accelerating-beam/"/>
    <content>
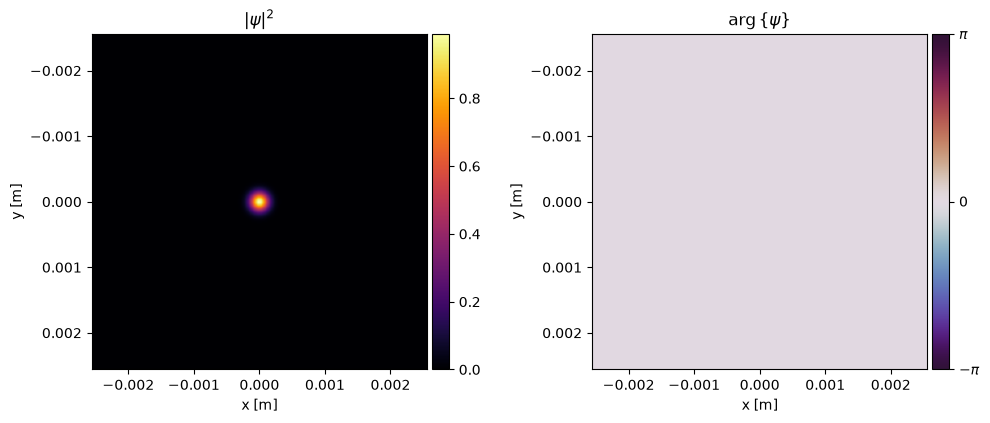
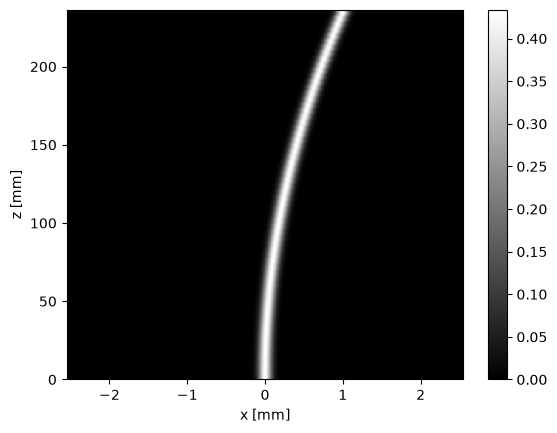
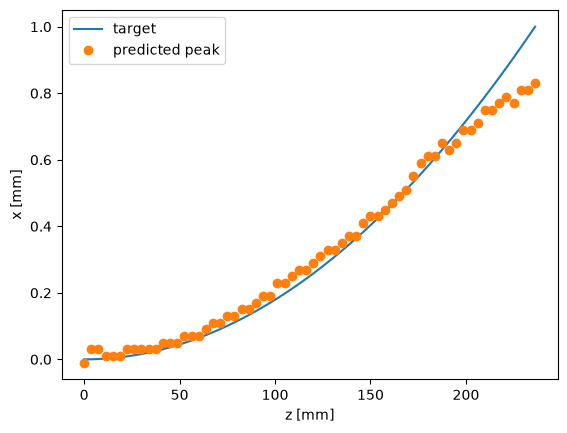
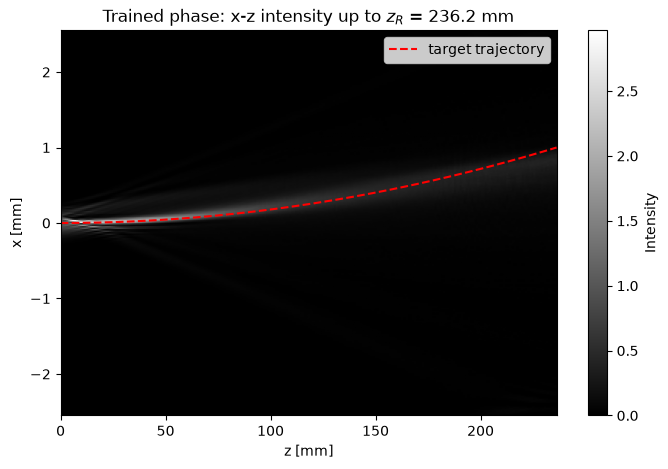
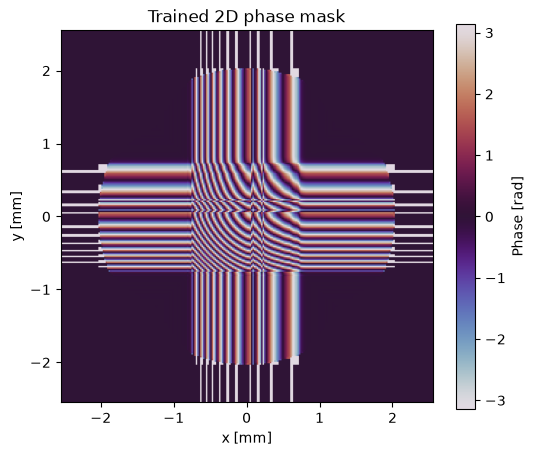
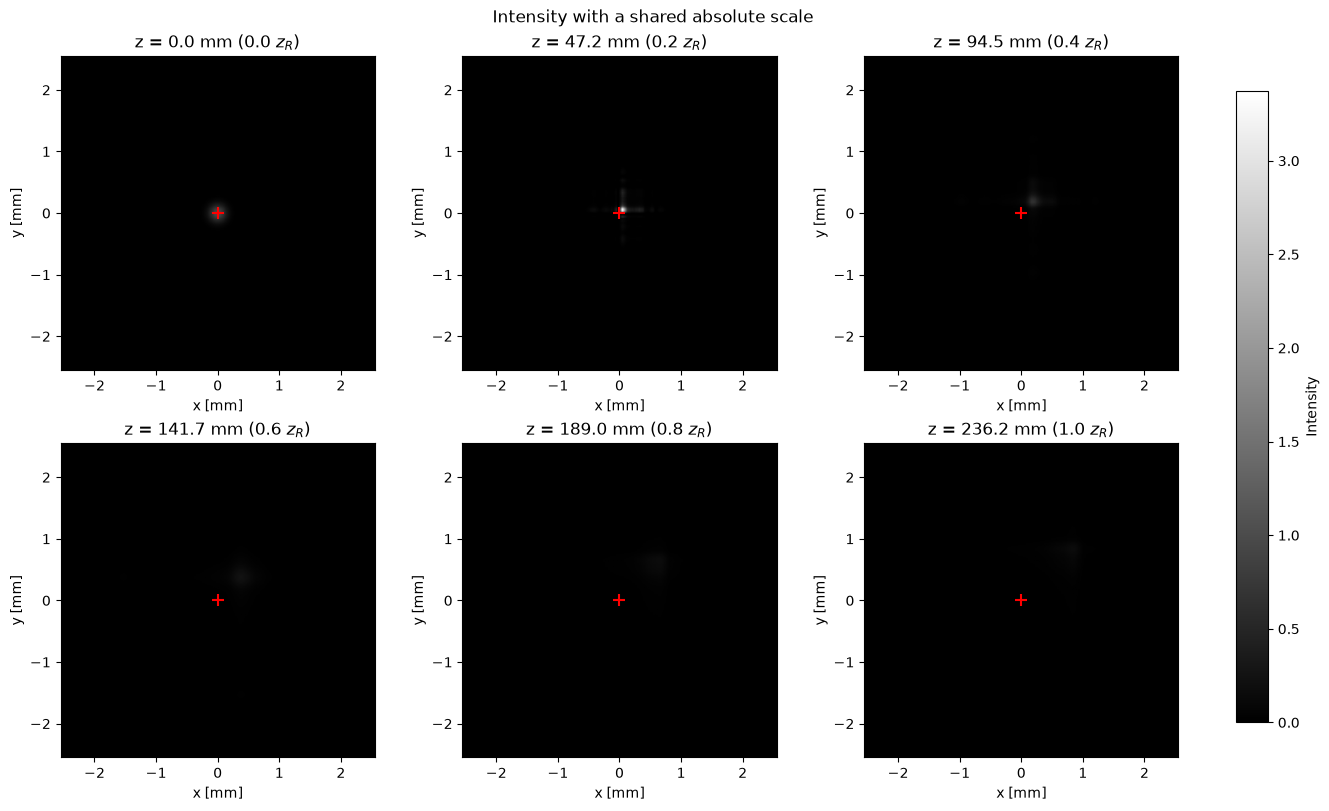
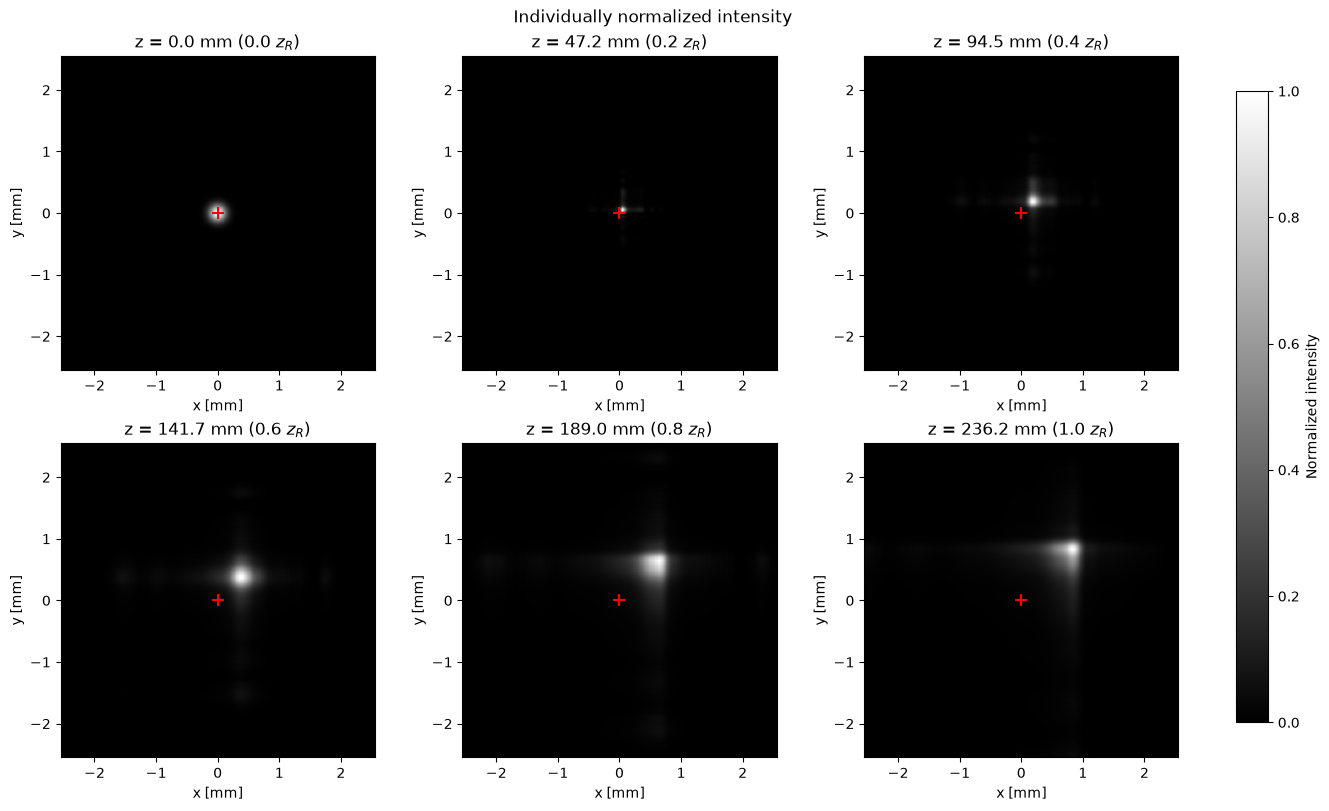
      <![CDATA[<h2 id="1-从目标轨迹到输入相位"><a href="#1-从目标轨迹到输入相位" class="headerlink" title="1. 从目标轨迹到输入相位"></a>1. 从目标轨迹到输入相位</h2><p>自加速光束（accelerating optical beam）最吸引我的地方，是它在自由空间传播时，主瓣并不沿直线前进。最经典的 Airy beam 在傍轴近似下沿抛物线传播；更一般地，我们也可以先指定一条轨迹，再反过来寻找能够产生这条轨迹的输入光场。</p><p>传统做法通常从 caustic theory 出发，根据目标轨迹解析地推导空间相位或频谱相位。以 <em>Generation of spirally accelerating optical beams</em> 为例，它所解决的正是这样一个问题：</p><div class="mathjax-block">$$\text{desired trajectory}\longrightarrow\text{spectral phase}\longrightarrow\text{input field}\longrightarrow\text{desired propagation}.$$</div><p>真正困难的是中间这一步：</p><div class="mathjax-block">$$x_t(z)\longrightarrow ? \longrightarrow \phi.$$</div><p>学到 differentiable optics 和 inverse design 之后，我开始想：这里的问号是否一定要由我先完成一套解析推导？如果传播过程本身可以求导，那么也可以把输入相位当作未知参数，让优化器直接从传播结果中寻找答案：</p><div class="mathjax-block">$$\phi(x)\longrightarrowu_x(x,0)\longrightarrow\{u_x(x,z_i)\}_{i=1}^{N_z}\longrightarrow\{I_x(x,z_i)\}_{i=1}^{N_z}\longrightarrow\mathcal L.$$</div><p>PyTorch 会沿着光强计算、角谱传播和输入场构造自动反向传播，得到</p><div class="mathjax-block">$$\frac{\partial \mathcal L}{\partial \phi(x)},$$</div><p>再由 Adam 逐步更新相位。</p><p>本文就从这个思路出发，以一条凸抛物线为例，尝试用 phase-only inverse design 生成沿指定轨迹弯曲的高强度区域。整个实验使用 PyTorch 构建可微优化过程，并用 <a href="https://github.com/MatthewFilipovich/torchoptics/tree/main">TorchOptics</a> 检查训练后光场的二维传播。</p><h3 id="1-1-简化为一维问题"><a href="#1-1-简化为一维问题" class="headerlink" title="1.1 简化为一维问题"></a>1.1 简化为一维问题</h3><p>我先只考虑 $x$ 方向，将完整二维相位掩模留到后续。目标轨迹取为</p><div class="mathjax-block">$$x_t(z)=az^2,\qquad a&gt;0,$$</div><p>并用终点位移确定系数：</p><div class="mathjax-block">$$a=\frac{x_t(z_{\max})}{z_{\max}^2}.$$</div><p>输入振幅固定为 Gaussian distribution：</p><div class="mathjax-block">$$A_x(x)=\exp\left(-\frac{x^2}{w_0^2}\right),$$</div><p>唯一需要学习的是一维相位 $\phi(x)$：</p><div class="mathjax-block">$$u_x(x,0)=A_x(x)e^{i\phi(x)}.$$</div><p>当横向网格有 $N$ 个采样点时，优化器只需学习 $N$ 个实数，参数量远小于二维相位的 $N^2$。这里先验证一个基础问题：<strong>一张一维 phase-only mask，能不能让传播强度的高值区域逼近给定曲线？</strong></p><p>当前损失没有约束无衍射、自修复、主瓣宽度恒定、旁瓣、能量效率或器件可制造性。因此，这里的结果只代表 trajectory inverse design 的第一步。</p><h2 id="2-设置数值网格"><a href="#2-设置数值网格" class="headerlink" title="2. 设置数值网格"></a>2. 设置数值网格</h2><h3 id="2-1-选择传播范围"><a href="#2-1-选择传播范围" class="headerlink" title="2.1 选择传播范围"></a>2.1 选择传播范围</h3><p>实验采用以下参数：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line">wavelength = <span class="number">532e-9</span></span><br><span class="line"></span><br><span class="line">N = <span class="number">256</span></span><br><span class="line">dx = <span class="number">20e-6</span>  <span class="comment"># FOV = 5.12 mm</span></span><br><span class="line"></span><br><span class="line">w0 = <span class="number">0.20e-3</span>  <span class="comment"># 0.20 mm</span></span><br><span class="line">z_rayleigh = torch.pi * w0**<span class="number">2</span> / wavelength</span><br><span class="line"></span><br><span class="line">z_min = <span class="number">0</span></span><br><span class="line">z_max = z_rayleigh</span><br><span class="line">num_z = <span class="number">64</span></span><br><span class="line"></span><br><span class="line">target_displacement_at_z_max = <span class="number">1e-3</span></span><br><span class="line">trajectory_coefficient = target_displacement_at_z_max / z_max**<span class="number">2</span></span><br></pre></td></tr></table></figure><p>横向坐标与输入 Gaussian amplitude 为</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">coord = (torch.arange(N, device=device) - (N - <span class="number">1</span>) / <span class="number">2</span>) * dx</span><br><span class="line">amplitude_x = torch.exp(-(coord**<span class="number">2</span>) / w0**<span class="number">2</span>)</span><br></pre></td></tr></table></figure><p>横向视场为</p><div class="mathjax-block">$$L=N\Delta x=5.12\ \mathrm{mm},$$</div><p>坐标范围约为 $[-2.56,2.56]\ \mathrm{mm}$。$w_0&#x3D;0.20\ \mathrm{mm}$ 对应 10 个横向 pixel，输入 Gaussian 不至于在网格上完全欠采样。</p><p>训练距离取一个 Rayleigh range：</p><div class="mathjax-block">$$z_R=\frac{\pi w_0^2}{\lambda}\approx236.2\ \mathrm{mm}.$$</div><p>在 $0$ 到 $z_R$ 之间均匀选择 64 个传播平面。目标轨迹被写成一个独立函数：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line">z_values = torch.linspace(</span><br><span class="line">    z_min,</span><br><span class="line">    z_max,</span><br><span class="line">    num_z,</span><br><span class="line">    device=device,</span><br><span class="line">)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">target_trajectory</span>(<span class="params">z</span>):</span><br><span class="line">    <span class="keyword">return</span> trajectory_coefficient * z**<span class="number">2</span></span><br><span class="line"></span><br><span class="line"></span><br><span class="line">target_x = target_trajectory(z_values)</span><br></pre></td></tr></table></figure><h3 id="2-2-检查数值可表示性"><a href="#2-2-检查数值可表示性" class="headerlink" title="2.2 检查数值可表示性"></a>2.2 检查数值可表示性</h3><p>参数确定之后，下一步不应该马上进入优化，而要先检查目标是否超出离散网格的表达能力。否则，如果轨迹已经越过横向视场、输入场采样不足，或者所需传播角超过 Nyquist limit，后面无论怎样调整 loss 和 optimizer 都无法解决问题。</p><p>当前参数对应的检查结果是：</p><ul><li>目标在一个 Rayleigh range 内最大移动 $1\ \mathrm{mm}$，视场半宽为 $2.56\ \mathrm{mm}$，边界余量为 $1.56\ \mathrm{mm}$。</li><li>Gaussian 的 $1&#x2F;e$ amplitude radius 覆盖 10 个 pixel，输入场没有明显欠采样。</li><li>抛物线最大斜率约为 $8.40\ \mathrm{mrad}$。</li><li>当前横向采样对应的 Nyquist angle 约为 $13.30\ \mathrm{mrad}$，目标使用了约 63.2%。</li><li>64 个训练平面的间距约为 $3.75\ \mathrm{mm}$；在轨迹最陡处，相邻平面的目标位移约为 1.57 pixel。</li></ul><p>Notebook 输出为</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">Numerical sampling sanity check</span><br><span class="line">--------------------------------------</span><br><span class="line">FOV half-width: 2.560 mm | max target displacement: 1.000 mm | margin: 1.560 mm</span><br><span class="line">Gaussian sampling: w0 / dx = 10.0 pixels | edge intensity = 0.00e+00</span><br><span class="line">Max target slope: 8.40 mrad | Nyquist angle: 13.30 mrad | usage: 63.2%</span><br><span class="line">Longitudinal step: 3.75 mm | largest target shift per plane: 1.57 pixels</span><br></pre></td></tr></table></figure><p>这些数值说明输入场和目标曲线都能被当前离散网格表示，说明优化失败不会来源于目标从一开始就在数值上不可表示。</p><h3 id="2-3-表示可训练相位"><a href="#2-3-表示可训练相位" class="headerlink" title="2.3 表示可训练相位"></a>2.3 表示可训练相位</h3><p>相位参数用一个很小的 <code>torch.nn.Module</code> 表示：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">class</span> <span class="title class_">PhaseMask</span>(torch.nn.Module):</span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self, n</span>):</span><br><span class="line">        <span class="built_in">super</span>().__init__()</span><br><span class="line">        self.phase_x = torch.nn.Parameter(torch.zeros(n))</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">forward</span>(<span class="params">self</span>):</span><br><span class="line">        <span class="keyword">return</span> self.phase_x</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">phase_mask = PhaseMask(N).to(device)</span><br></pre></td></tr></table></figure><p>每次 forward pass 都用当前相位构造复振幅：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">phase_x = phase_mask()</span><br><span class="line">input_field_x = amplitude_x.to(torch.complex64) * torch.exp(<span class="number">1j</span> * phase_x)</span><br></pre></td></tr></table></figure><p>训练期间没有必要强制 $\phi\in[0,2\pi)$。真正进入光场的是 $e^{i\phi}$，它天然具有 $2\pi$ 周期性。需要显示相位或把它加载到 phase-only modulator 时，再计算</p><div class="mathjax-block">$$\phi_{\mathrm{wrapped}}(x)=\arg\left[e^{i\phi(x)}\right].$$</div><p>为了检查输入场，我把同一个一维复光场分别放在 $x$ 和 $y$ 两个方向，构造了一个可分离二维场。此时还没有训练，图中主要看到的是位于中心的 Gaussian input。</p><p><img src="/../images/2026-09-18-%E7%94%A8-TorchOptics-%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E4%B8%80%E6%9D%A1%E5%87%B8-Accelerating-Beam-%E8%BD%A8%E8%BF%B9/image.png" alt="初始二维输入光场的强度分布。"></p><h2 id="3-用一维-ASM-传播"><a href="#3-用一维-ASM-传播" class="headerlink" title="3. 用一维 ASM 传播"></a>3. 用一维 ASM 传播</h2><h3 id="3-1-实现一维-ASM"><a href="#3-1-实现一维-ASM" class="headerlink" title="3.1 实现一维 ASM"></a>3.1 实现一维 ASM</h3><p>目标轨迹和损失都定义在 $x$-$z$ 平面。如果先构造二维 <code>Field</code>，传播后再沿 $y$ 积分回到一维，那么训练过程会不断计算一个最终没有进入目标函数的额外维度。因此，我最后保留了一个直接用 PyTorch FFT 实现的一维 Angular Spectrum Method（ASM）。</p><p>ASM 的思路是把输入场分解为空间频率不同的平面波，让每个分量在频域积累传播相位。若 $f_x$ 以 cycles per meter 为单位，则</p><div class="mathjax-block">$$f_z=\sqrt{\frac{1}{\lambda^2}-f_x^2},$$</div><p>传播距离 $z$ 对应的传递函数为</p><div class="mathjax-block">$$H(f_x,z)=\exp(i2\pi zf_z),$$</div><p>所以</p><div class="mathjax-block">$$u_x(x,z)=\mathcal F^{-1}\left\{\mathcal F[u_x(x,0)]H(f_x,z)\right\}.$$</div><p>对应实现为</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">propagate_trajectory</span>(<span class="params">field_x, z_values</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Propagate a 1D field along x with the angular spectrum method.&quot;&quot;&quot;</span></span><br><span class="line">    spatial_frequency_x = torch.fft.fftfreq(</span><br><span class="line">        field_x.numel(),</span><br><span class="line">        d=dx,</span><br><span class="line">        device=field_x.device,</span><br><span class="line">    )</span><br><span class="line">    longitudinal_frequency = torch.sqrt(</span><br><span class="line">        torch.clamp(<span class="number">1</span> / wavelength**<span class="number">2</span> - spatial_frequency_x**<span class="number">2</span>, <span class="built_in">min</span>=<span class="number">0</span>)</span><br><span class="line">    )</span><br><span class="line">    spectrum_x = torch.fft.fft(field_x)</span><br><span class="line"></span><br><span class="line">    propagated_fields_x = []</span><br><span class="line">    <span class="keyword">for</span> z <span class="keyword">in</span> z_values:</span><br><span class="line">        transfer_function = torch.exp(</span><br><span class="line">            <span class="number">1j</span> * <span class="number">2</span> * torch.pi * z * longitudinal_frequency</span><br><span class="line">        )</span><br><span class="line">        propagated_fields_x.append(</span><br><span class="line">            torch.fft.ifft(spectrum_x * transfer_function)</span><br><span class="line">        )</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> propagated_fields_x</span><br></pre></td></tr></table></figure><p>输入频谱只需计算一次，随后针对每个 $z_i$ 乘上传递函数。FFT、复数乘法和 IFFT 都留在 autograd 计算图中，因此这个效率上的简化不会切断梯度。</p><p>传播结果直接写成</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">fields_x = propagate_trajectory(input_field_x, z_values)</span><br><span class="line">intensities_x = [field.<span class="built_in">abs</span>().square() <span class="keyword">for</span> field <span class="keyword">in</span> fields_x]</span><br></pre></td></tr></table></figure><p>堆叠后，强度张量的形状是 <code>[num_z, N]</code>。这里从始至终没有 $y$ 维度，也不需要执行 <code>intensity.sum(dim=0)</code>。</p><h3 id="3-2-固定-TorchOptics-的传播方法"><a href="#3-2-固定-TorchOptics-的传播方法" class="headerlink" title="3.2 固定 TorchOptics 的传播方法"></a>3.2 固定 TorchOptics 的传播方法</h3><p>TorchOptics 的 <code>Field.propagate_to_z()</code> 默认使用 <code>propagation_method=&quot;AUTO&quot;</code>，它会根据传播距离与临界传播距离，在 ASM 和 Direct Integration Method（DIM）之间自动选择。临界距离与网格范围、采样间隔和波长有关，可以写为</p><div class="mathjax-block">$$z_c=\frac{2|x_{\max}|\Delta x}{\lambda}.$$</div><p>训练使用自定义一维 ASM。若二维可视化在某些距离由 AUTO 切换到 DIM，训练和结果检查就会使用不同的传播方法。ASM 与 DIM 都可以求导，但数值离散误差有所不同。</p><p>因此，训练后的二维传播显式指定</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">field.propagate_to_z(</span><br><span class="line">    z,</span><br><span class="line">    propagation_method=<span class="string">&quot;ASM&quot;</span>,</span><br><span class="line">)</span><br></pre></td></tr></table></figure><p>这样可以避免 ASM&#x2F;DIM 模型切换，使训练与结果检查保持在同一种传播框架内。自定义一维 ASM 与 TorchOptics 二维 ASM 的维度和离散细节仍有差异。</p><h2 id="4-定义轨迹损失"><a href="#4-定义轨迹损失" class="headerlink" title="4. 定义轨迹损失"></a>4. 定义轨迹损失</h2><p>有了正向传播模型之后，每个传播平面都会得到一条 intensity profile：</p><div class="mathjax-block">$$I_x(x,z_i)=|u_x(x,z_i)|^2.$$</div><p>直觉上，只要找出每个平面的最亮位置</p><div class="mathjax-block">$$x_{\mathrm{peak}}(z_i)=\operatorname*{arg\,max}_x I_x(x,z_i),$$</div><p>再比较它和目标位置 $x_t(z_i)$，就可以写出一个非常直接的轨迹损失：</p><div class="mathjax-block">$$\mathcal L_{\mathrm{traj}}=\frac{1}{N_z}\sum_{i=1}^{N_z}\left[x_{\mathrm{peak}}(z_i)-x_t(z_i)\right]^2.$$</div><p>问题在于，<code>argmax</code> 是离散选择。强度稍有变化，结果就可能从一个 pixel 跳到相邻 pixel，无法提供连续而稳定的梯度。</p><p>我也考虑过用 softmax 加权坐标构造 soft peak，但这又会把整条 profile 压缩成一个坐标。训练初期目标位置几乎没有光时，梯度信号可能很弱；如果存在两个分离峰，它们的加权中心甚至可能刚好位于目标位置，让坐标误差看起来很小，却没有真正形成目标主瓣。</p><p>所以我最终放弃了在训练中”先找峰值坐标”，转而直接比较完整的 intensity profile。</p><h3 id="4-1-构造-Gaussian-target-tube"><a href="#4-1-构造-Gaussian-target-tube" class="headerlink" title="4.1 构造 Gaussian target tube"></a>4.1 构造 Gaussian target tube</h3><p>对于每个目标位置 $x_t(z_i)$，在其周围放置宽度为 $\sigma_x$ 的 Gaussian：</p><div class="mathjax-block">$$T_i(x)=\exp\left[-\frac{(x-x_t(z_i))^2}{2\sigma_x^2}\right].$$</div><p>当前实验取 $\sigma_x&#x3D;60\ \mu\mathrm m$：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line">sigma_x = <span class="number">60e-6</span></span><br><span class="line"></span><br><span class="line">target_profiles = torch.exp(</span><br><span class="line">    -<span class="number">0.5</span> * ((coord[<span class="literal">None</span>, :] - target_x[:, <span class="literal">None</span>]) / sigma_x) ** <span class="number">2</span></span><br><span class="line">)</span><br><span class="line"></span><br><span class="line">target_profiles = target_profiles / (</span><br><span class="line">    torch.linalg.vector_norm(</span><br><span class="line">        target_profiles,</span><br><span class="line">        dim=<span class="number">1</span>,</span><br><span class="line">        keepdim=<span class="literal">True</span>,</span><br><span class="line">    )</span><br><span class="line">    + <span class="number">1e-12</span></span><br><span class="line">)</span><br></pre></td></tr></table></figure><p><code>target_profiles</code> 的形状为 <code>[64, 256]</code>。沿 $z$ 方向排列后，它形成一条具有有限宽度的 Gaussian tube。</p><p><img src="/../images/2026-09-18-%E7%94%A8-TorchOptics-%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E4%B8%80%E6%9D%A1%E5%87%B8-Accelerating-Beam-%E8%BD%A8%E8%BF%B9/image-1.png" alt="围绕目标抛物线构造的 Gaussian target tube，$\sigma_x&#x3D;60\ \mu\mathrm m$。"></p><h3 id="4-2-用-profile-overlap-代替-peak-loss"><a href="#4-2-用-profile-overlap-代替-peak-loss" class="headerlink" title="4.2 用 profile overlap 代替 peak loss"></a>4.2 用 profile overlap 代替 peak loss</h3><p>不同传播面的峰值强度可能相差很大。这个阶段我先关心”形状和位置是否对齐”，因此对每个预测 profile 和目标 profile 分别做 $L^2$ normalization：</p><div class="mathjax-block">$$\widehat I_i(x)=\frac{I_x(x,z_i)}{\|I_x(x,z_i)\|_2},\qquad\widehat T_i(x)=\frac{T(x)}{\|T(x)\|_2}.$$</div><p>单个平面的 overlap 为</p><div class="mathjax-block">$$O_i=\sum_x\widehat I_i(x)\widehat T_i(x),$$</div><p>最终损失取为</p><div class="mathjax-block">$$\mathcal L_{\mathrm{profile}}=\frac{1}{N_z}\sum_{i=1}^{N_z}(1-O_i).$$</div><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">trajectory_profile_loss</span>(<span class="params"></span></span><br><span class="line"><span class="params">    intensities_x,</span></span><br><span class="line"><span class="params">    target_profiles,</span></span><br><span class="line"><span class="params"></span>):</span><br><span class="line">    profiles = torch.stack(intensities_x, dim=<span class="number">0</span>)</span><br><span class="line"></span><br><span class="line">    profiles = profiles / (</span><br><span class="line">        torch.linalg.vector_norm(</span><br><span class="line">            profiles,</span><br><span class="line">            dim=<span class="number">1</span>,</span><br><span class="line">            keepdim=<span class="literal">True</span>,</span><br><span class="line">        )</span><br><span class="line">        + <span class="number">1e-12</span></span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    overlap = torch.<span class="built_in">sum</span>(</span><br><span class="line">        profiles * target_profiles,</span><br><span class="line">        dim=<span class="number">1</span>,</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> torch.mean(<span class="number">1</span> - overlap)</span><br></pre></td></tr></table></figure><p>与单独比较坐标相比，这个损失保留了更多空间信息：目标区域太暗、非目标区域太亮，或者 profile 的形状与 target tube 不一致，都会降低 overlap。代价是它没有直接约束绝对功率——这个问题会在结果分析中再次出现。</p><h2 id="5-优化输入相位"><a href="#5-优化输入相位" class="headerlink" title="5. 优化输入相位"></a>5. 优化输入相位</h2><p>优化器使用 Adam，学习率为 0.03，总共训练 380 次：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br></pre></td><td class="code"><pre><span class="line">optimizer = torch.optim.Adam(</span><br><span class="line">    phase_mask.parameters(),</span><br><span class="line">    lr=<span class="number">0.03</span>,</span><br><span class="line">)</span><br><span class="line"></span><br><span class="line">num_iterations = <span class="number">380</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">for</span> iteration <span class="keyword">in</span> <span class="built_in">range</span>(num_iterations):</span><br><span class="line">    optimizer.zero_grad()</span><br><span class="line"></span><br><span class="line">    phase_x = phase_mask()</span><br><span class="line">    input_field_x = (</span><br><span class="line">        amplitude_x.to(torch.complex64) * torch.exp(<span class="number">1j</span> * phase_x)</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    fields_x = propagate_trajectory(</span><br><span class="line">        input_field_x,</span><br><span class="line">        z_values,</span><br><span class="line">    )</span><br><span class="line">    intensities_x = [field.<span class="built_in">abs</span>().square() <span class="keyword">for</span> field <span class="keyword">in</span> fields_x]</span><br><span class="line"></span><br><span class="line">    loss = trajectory_profile_loss(</span><br><span class="line">        intensities_x,</span><br><span class="line">        target_profiles,</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    loss.backward()</span><br><span class="line">    optimizer.step()</span><br></pre></td></tr></table></figure><p>这个循环依次构造输入场、传播到多个 $z$ 平面、计算 profile overlap，再把梯度传回 $\phi(x)$。结果主要取决于 target 和 loss 的定义。</p><p>最后一次 <code>optimizer.step()</code> 更新的是相位参数，而当前循环里的 <code>intensities_x</code> 仍然对应更新前的参数。因此训练完成后，我重新执行了一次 forward pass，确保后面的图像和指标使用最终相位：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">with</span> torch.no_grad():</span><br><span class="line">    phase_x = phase_mask()</span><br><span class="line">    input_field_x = (</span><br><span class="line">        amplitude_x.to(torch.complex64) * torch.exp(<span class="number">1j</span> * phase_x)</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    fields_x = propagate_trajectory(</span><br><span class="line">        input_field_x,</span><br><span class="line">        z_values,</span><br><span class="line">    )</span><br><span class="line">    intensities_x = [field.<span class="built_in">abs</span>().square() <span class="keyword">for</span> field <span class="keyword">in</span> fields_x]</span><br></pre></td></tr></table></figure><h2 id="6-分析优化结果"><a href="#6-分析优化结果" class="headerlink" title="6. 分析优化结果"></a>6. 分析优化结果</h2><p>优化结束以后，我分别从损失收敛、峰值轨迹、完整 x-z 强度分布、学习到的相位，以及二维传播截面几个角度检查结果。</p><h3 id="6-1-损失收敛"><a href="#6-1-损失收敛" class="headerlink" title="6.1 损失收敛"></a>6.1 损失收敛</h3><p>训练 loss 从 0.643652 持续下降，在约 200 次迭代后进入平台，最终稳定在 0.21376 左右：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line">0000 loss=0.643652</span><br><span class="line">0040 loss=0.492147</span><br><span class="line">0080 loss=0.311251</span><br><span class="line">0120 loss=0.240704</span><br><span class="line">0160 loss=0.225951</span><br><span class="line">0200 loss=0.218037</span><br><span class="line">0240 loss=0.214968</span><br><span class="line">0280 loss=0.213989</span><br><span class="line">0320 loss=0.213797</span><br><span class="line">0360 loss=0.213764</span><br></pre></td></tr></table></figure><p>loss 的下降表明梯度能够穿过复数场、ASM 和 intensity calculation 回到输入相位，同时预测 profile 与 target tube 的重合度在提高。profile-overlap loss 不衡量位置误差，因此还需要单独检查主瓣轨迹。</p><h3 id="6-2-峰值轨迹"><a href="#6-2-峰值轨迹" class="headerlink" title="6.2 峰值轨迹"></a>6.2 峰值轨迹</h3><p><code>argmax</code> 在训练完成后可以直接测量每个传播面的最亮 pixel：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta">@torch.no_grad()</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">hard_peak_x</span>(<span class="params">intensity_x, x_axis</span>):</span><br><span class="line">    index = torch.argmax(intensity_x)</span><br><span class="line">    <span class="keyword">return</span> x_axis[index]</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">hard_pred_x = torch.stack(</span><br><span class="line">    [hard_peak_x(intensity_x, coord) <span class="keyword">for</span> intensity_x <span class="keyword">in</span> intensities_x]</span><br><span class="line">)</span><br></pre></td></tr></table></figure><p>把这些离散位置与目标抛物线放在一起，能够直接回答最初的问题。从图中可以看到，预测峰值整体沿正 $x$ 方向弯曲，并大体跟随目标轨迹；同时也能看到部分传播位置存在跳变和偏离。由于 hard argmax 只能落在横向网格点上，轨迹本身还带有 $20\ \mu\mathrm m$ 的量化。</p><p><img src="/../images/2026-09-18-%E7%94%A8-TorchOptics-%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E4%B8%80%E6%9D%A1%E5%87%B8-Accelerating-Beam-%E8%BD%A8%E8%BF%B9/image-2.png" alt="目标抛物线与训练后各传播平面的 hard-argmax peak position。"></p><h3 id="6-3-x-z-强度分布"><a href="#6-3-x-z-强度分布" class="headerlink" title="6.3 x-z 强度分布"></a>6.3 x-z 强度分布</h3><p>接下来，我把所有一维强度直接堆叠成 x-z map：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">xz_intensity = torch.stack(intensities_x, dim=<span class="number">0</span>).T</span><br></pre></td></tr></table></figure><p>hard argmax 每个平面只留下一个坐标，完整强度图则保留主瓣宽度、旁瓣和多个竞争峰。图中的高强度 ridge 朝目标方向弯曲，但局部峰值、宽度和旁瓣结构都会随传播发生变化。</p><p><img src="/../images/2026-09-18-%E7%94%A8-TorchOptics-%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E4%B8%80%E6%9D%A1%E5%87%B8-Accelerating-Beam-%E8%BD%A8%E8%BF%B9/image-3.png" alt="训练平面上的绝对强度 x-z map。"></p><h3 id="6-4-训练后的相位"><a href="#6-4-训练后的相位" class="headerlink" title="6.4 训练后的相位"></a>6.4 训练后的相位</h3><p>训练后的一维相位被外积扩展到两个方向，最后显示的是二维场</p><div class="mathjax-block">$$U_0(x,y)=u_x(y,0)u_x(x,0)$$</div><p>的 wrapped phase：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">with</span> torch.no_grad():</span><br><span class="line">    trained_phase_2d = torch.angle(input_field.data)</span><br></pre></td></tr></table></figure><p>这里两个横向方向都使用同一个训练后的一维复光场。</p><p><img src="/../images/2026-09-18-%E7%94%A8-TorchOptics-%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E4%B8%80%E6%9D%A1%E5%87%B8-Accelerating-Beam-%E8%BD%A8%E8%BF%B9/image-4.png" alt="由训练后的一维复光场构造的二维 wrapped phase。"></p><p>当前 loss 没有相位平滑、空间带宽、pixelation 或 phase quantization 约束，因此相位中出现快速变化并不意外。如果目标是实际加载到 SLM，这些器件约束需要在下一轮设计中显式加入。</p><h3 id="6-5-二维传播截面"><a href="#6-5-二维传播截面" class="headerlink" title="6.5 二维传播截面"></a>6.5 二维传播截面</h3><p>为了看清这个可分离二维场传播后是什么样子，我用 TorchOptics 的 ASM 在 $0$、$0.2z_R$、$0.4z_R$、$0.6z_R$、$0.8z_R$ 和 $z_R$ 处绘制 $x$-$y$ intensity cross-section。</p><p>这里用两张图观察同一组传播截面。第一张图采用<strong>共享的绝对强度尺度</strong>：所有子图使用相同的 <code>vmin</code> 和 <code>vmax</code>，因此既能看主瓣移到了哪里，也能比较不同传播距离的峰值强度和能量集中程度。图中可以看到，峰值强度并没有在传播过程中保持不变；这正是当前 normalized profile loss 没有直接约束的部分。</p><p><img src="/../images/2026-09-18-%E7%94%A8-TorchOptics-%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E4%B8%80%E6%9D%A1%E5%87%B8-Accelerating-Beam-%E8%BD%A8%E8%BF%B9/image-5.png" alt="六个传播距离处的二维强度截面，所有子图共享同一绝对强度尺度。"></p><p>第二张图把每个传播面的强度分别除以该平面的最大值。逐面归一化后，较暗平面中的主瓣、旁瓣和空间结构会更加清楚，适合比较不同位置的形态变化；但由于每个平面都被重新缩放到最大值 1，它不能用于判断不同传播距离之间的绝对强度差异。</p><p><img src="/../images/2026-09-18-%E7%94%A8-TorchOptics-%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E4%B8%80%E6%9D%A1%E5%87%B8-Accelerating-Beam-%E8%BD%A8%E8%BF%B9/image-6.png" alt="同一组六个二维强度截面，每个传播面分别归一化至最大值 1。"></p><p>两种尺度提供互补信息。绝对尺度用于判断强度和能量集中程度是否稳定，相对尺度用于观察各传播面的主瓣与旁瓣结构。归一化会隐藏传播面之间的亮度差异，共享绝对尺度则可能使弱光平面的结构难以辨认。</p><h2 id="7-局限与改进方向"><a href="#7-局限与改进方向" class="headerlink" title="7. 局限与改进方向"></a>7. 局限与改进方向</h2><p>这次尝试说明：在给定的一维 ASM 和离散网格下，确实可以把输入 Gaussian 的 phase 写成可训练参数，并通过完整 x-z profile 的 overlap，让传播后的高强度区域逼近指定凸抛物线。</p><p>当前 profile 在每个传播面分别归一化，因此 loss 主要奖励空间重合，而不直接关心绝对功率。这会留下几类可能的退化结果：</p><ul><li>目标区域的绝对强度较弱，但归一化后的形状相似；</li><li>不同传播面的峰值强度变化明显；</li><li>某些位置出现多个强度接近的竞争峰；</li><li>主瓣宽度和旁瓣强度没有得到控制；</li><li>相位包含不利于实际器件实现的高空间频率。</li></ul><p>如果继续推进这个设计，我会优先在 loss 中加入能量集中度、旁瓣抑制和主瓣宽度约束，再逐步加入相位平滑、SLM pixelation 与量化。若要设计只沿 $x$ 加速、沿 $y$ 保持指定形态的二维光场，则应分别定义 $x$ 与 $y$ 方向的输入，或者直接优化完整二维相位。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/09/17/2026-09-18-%E7%94%A8-TorchOptics-%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E4%B8%80%E6%9D%A1%E5%87%B8-Accelerating-Beam-%E8%BD%A8%E8%BF%B9/</id>
    <link href="https://believed-breadfruit.top/2026/09/17/2026-09-18-%E7%94%A8-TorchOptics-%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E4%B8%80%E6%9D%A1%E5%87%B8-Accelerating-Beam-%E8%BD%A8%E8%BF%B9/"/>
    <published>2026-09-17T16:00:00.000Z</published>
    <summary>用可微 PyTorch 优化器在一维 phase-only mask 上学习输入相位，让 Gaussian 输入沿指定凸抛物线轨迹传播，并结合 TorchOptics 检查二维传播截面。</summary>
    <title>用 TorchOptics 逆向设计一条凸 Accelerating Beam 轨迹</title>
    <updated>2026-09-17T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="技术" scheme="https://believed-breadfruit.top/categories/%E6%8A%80%E6%9C%AF/"/>
    <category term="differentiable optics" scheme="https://believed-breadfruit.top/tags/differentiable-optics/"/>
    <category term="inverse design" scheme="https://believed-breadfruit.top/tags/inverse-design/"/>
    <category term="PyTorch" scheme="https://believed-breadfruit.top/tags/PyTorch/"/>
    <category term="Fourier optics" scheme="https://believed-breadfruit.top/tags/Fourier-optics/"/>
    <content>
      <![CDATA[<blockquote><p><strong>Runnable code</strong></p><p>完整项目见 <a href="https://github.com/janice143/computational-optics">GitHub 仓库</a>，代码按职责组织如下：</p></blockquote><p>上一篇我没有使用 PyTorch，而是用 NumPy + Autograd 手动搭了一遍 <a href="http://arxiv.org/abs/2411.18591">TorchOptics</a> 论文 Figure 4 中的 inverse-design pipeline：</p><div class="mathjax-block">$$\phi_1,\phi_2,\phi_3 \rightarrow \text{phase modulation} \rightarrow \text{wave propagation} \rightarrow U_{\rm out} \rightarrow L \rightarrow \nabla_\phi L \rightarrow \text{Adam}.$$</div><p>那次实现最大的价值，是把 differentiable optics 背后的计算过程拆开来看清楚。但实际做计算光学、holography、DOE optimization 或 optical neural network 时，更常见的工具显然是 PyTorch。原因并不只是“PyTorch 可以训练神经网络”，而是它同时提供了可微光学需要的几样东西：</p><div class="mathjax-block">$$\text{PyTorch}=\text{Tensor computation}+\text{complex FFT}+\text{automatic differentiation}+\text{optimizer}+\text{GPU}$$</div><p>这篇文章继续复现同一个 inverse-design problem，但完全使用原生 PyTorch。目标是理解：</p><blockquote><p>一个 Fourier optics simulator 怎样自然地变成一个 PyTorch optimization model。</p></blockquote><hr><h2 id="一、问题场景：三平面相位调制器的逆向设计"><a href="#一、问题场景：三平面相位调制器的逆向设计" class="headerlink" title="一、问题场景：三平面相位调制器的逆向设计"></a>一、问题场景：三平面相位调制器的逆向设计</h2><h3 id="光学系统、目标与数值参数"><a href="#光学系统、目标与数值参数" class="headerlink" title="光学系统、目标与数值参数"></a>光学系统、目标与数值参数</h3><p>我们继续使用 TorchOptics 论文 Figure 4 中的实验。输入是一束 Gaussian beam $\psi_{\rm in}(x,y)$，目标是在输出平面得到四束 Gaussian beam $\phi_{\rm target}(x,y)$。光学系统中放置三块 phase-only modulator：</p><div class="mathjax-block">$$M_1=e^{i\phi_1(x,y)},\qquad M_2=e^{i\phi_2(x,y)},\qquad M_3=e^{i\phi_3(x,y)}.$$</div><p>三块调制器分别位于 $z&#x3D;0$、$0.2,{\rm m}$ 和 $0.4,{\rm m}$，最终 target plane 位于 $z&#x3D;0.6,{\rm m}$，所以整个系统是：</p><div class="mathjax-block">$$U_{\rm in}\rightarrow M_1\rightarrow P\rightarrow M_2\rightarrow P\rightarrow M_3\rightarrow P\rightarrow U_{\rm out},$$</div><p>其中每一段传播距离都是 $0.2,{\rm m}$。</p><p>论文 Listing 2 使用 $250\times250$ sampling grid、$10,\mu{\rm m}$ spacing、$700,{\rm nm}$ wavelength、$150,\mu{\rm m}$ Gaussian waist，三块 trainable phase modulator 使用 Adam、learning rate $0.1$，共优化 400 iterations。</p><p>这一次依然不直接调用 TorchOptics，而是自己实现其中的物理传播和 optimization。</p><h3 id="从-forward-problem-到-inverse-problem"><a href="#从-forward-problem-到-inverse-problem" class="headerlink" title="从 forward problem 到 inverse problem"></a>从 forward problem 到 inverse problem</h3><p>普通 Fourier optics simulation 做的是</p><div class="mathjax-block">$$U_0\overset{P}{\longrightarrow}U_z,$$</div><p>也就是给定 optical system，求输出光场。例如 Angular Spectrum Method：</p><div class="mathjax-block">$$U_z=\mathcal F^{-1}\!\left[\mathcal F(U_0)H_z\right].$$</div><p>这是 forward problem。现在则反过来：我们已经知道 $U_{\rm in}$ 和 $U_{\rm target}$，但不知道三块 phase modulator 应该具有怎样的相位 $\phi_1(x,y)$、$\phi_2(x,y)$ 和 $\phi_3(x,y)$。真正要求的是：</p><div class="mathjax-block">$$\phi_1^*,\phi_2^*,\phi_3^*=\arg\min_{\phi_1,\phi_2,\phi_3}L,\qquad L=L(U_{\rm out},U_{\rm target}).$$</div><p>这就是 inverse design。</p><hr><h2 id="二、整体思路：把光学系统写成-PyTorch-模型"><a href="#二、整体思路：把光学系统写成-PyTorch-模型" class="headerlink" title="二、整体思路：把光学系统写成 PyTorch 模型"></a>二、整体思路：把光学系统写成 PyTorch 模型</h2><h3 id="为什么-PyTorch-适合可微光学"><a href="#为什么-PyTorch-适合可微光学" class="headerlink" title="为什么 PyTorch 适合可微光学"></a>为什么 PyTorch 适合可微光学</h3><p>表面上，这不是一个 neural network：没有 convolution layer、transformer 或 dataset。但从 optimization 的角度来看，它和训练神经网络实际上是一样的。神经网络的计算链是</p><div class="mathjax-block">$$x\rightarrow f(x;W)\rightarrow \hat y\rightarrow L\rightarrow \nabla_WL,$$</div><p>现在的光学系统则是</p><div class="mathjax-block">$$U_{\rm in}\rightarrow F(U_{\rm in};\phi)\rightarrow U_{\rm out}\rightarrow L\rightarrow \nabla_\phi L.$$</div><p>唯一的区别是，神经网络里的参数是 $W$，这里的参数是 $\phi(x,y)$。所以在 PyTorch 看来，<code>weight</code> 和 <code>phase</code> 没有本质区别。只要它们是 <code>torch.nn.Parameter</code>，并且从 parameter 到 loss 的整个计算过程都由 differentiable operations 构成，PyTorch 就可以自动计算 gradient。</p><h3 id="Complex-autograd-如何连接-phase-与-loss"><a href="#Complex-autograd-如何连接-phase-与-loss" class="headerlink" title="Complex autograd 如何连接 phase 与 loss"></a>Complex autograd 如何连接 phase 与 loss</h3><p>光学传播最大的特殊之处在于场是复数：</p><div class="mathjax-block">$$U(x,y)\in\mathbb C,\qquad U=Ae^{i\varphi}.$$</div><p>因此传播过程中会大量出现复指数、FFT、共轭和模长运算：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">torch.exp(<span class="number">1j</span> * phi)</span><br><span class="line">torch.fft.fft2(...)</span><br><span class="line">torch.fft.ifft2(...)</span><br><span class="line">torch.conj(...)</span><br><span class="line">torch.<span class="built_in">abs</span>(...)</span><br></pre></td></tr></table></figure><p>PyTorch 原生支持 complex tensors，而且 <code>torch.fft</code> 的 FFT 运算支持 autograd。这里有一个非常重要的要求：最终 loss 必须是 real-valued scalar，比如 $L&#x3D;1-\eta$。PyTorch 对 complex computation 使用 Wirtinger calculus 处理反向传播；对于这种“内部存在 complex operations，但最终优化 real-valued loss”的问题，可以直接进行 gradient descent。</p><p>因此，下面这条计算链是完全合法的：</p><div class="mathjax-block">$$\phi\in\mathbb R \rightarrow e^{i\phi}\in\mathbb C \rightarrow \mathrm{FFT} \rightarrow U_{\rm out}\in\mathbb C \rightarrow |U|^2,\ |\langle U_t,U_o\rangle|^2 \rightarrow L\in\mathbb R.$$</div><hr><h2 id="三、准备输入场与目标场"><a href="#三、准备输入场与目标场" class="headerlink" title="三、准备输入场与目标场"></a>三、准备输入场与目标场</h2><h3 id="建立-sampling-grid"><a href="#建立-sampling-grid" class="headerlink" title="建立 sampling grid"></a>建立 sampling grid</h3><p>先建立空间坐标：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> torch</span><br><span class="line"></span><br><span class="line">Nx = <span class="number">250</span></span><br><span class="line">Ny = <span class="number">250</span></span><br><span class="line">dx = <span class="number">10e-6</span></span><br><span class="line">dy = <span class="number">10e-6</span></span><br><span class="line"></span><br><span class="line">real_dtype = torch.float64</span><br><span class="line">complex_dtype = torch.complex128</span><br><span class="line">device = torch.device(<span class="string">&quot;cuda&quot;</span> <span class="keyword">if</span> torch.cuda.is_available() <span class="keyword">else</span> <span class="string">&quot;cpu&quot;</span>)</span><br><span class="line"></span><br><span class="line">x = (torch.arange(Nx, dtype=real_dtype, device=device) - Nx // <span class="number">2</span>) * dx</span><br><span class="line">y = (torch.arange(Ny, dtype=real_dtype, device=device) - Ny // <span class="number">2</span>) * dy</span><br><span class="line">Y, X = torch.meshgrid(y, x, indexing=<span class="string">&quot;ij&quot;</span>)</span><br></pre></td></tr></table></figure><p>坐标满足</p><div class="mathjax-block">$$x_n=\left(n-\frac{N}{2}\right)\Delta x.$$</div><p>simulation window 大约为</p><div class="mathjax-block">$$L=N\Delta x=250\times10\,\mu{\rm m}=2.5\,{\rm mm}.$$</div><p>这和 NumPy 版本没有任何物理区别。</p><h3 id="构造-Gaussian-input"><a href="#构造-Gaussian-input" class="headerlink" title="构造 Gaussian input"></a>构造 Gaussian input</h3><p>Gaussian field 定义为</p><div class="mathjax-block">$$U(x,y)=C\exp\!\left[-\frac{(x-x_0)^2+(y-y_0)^2}{w_0^2}\right].$$</div><p>对应的 PyTorch 函数与输入场为：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">gaussian_beam</span>(<span class="params">X, Y, waist, x0=<span class="number">0.0</span>, y0=<span class="number">0.0</span>, amplitude=<span class="number">1.0</span></span>):</span><br><span class="line">    r2 = (X - x0) ** <span class="number">2</span> + (Y - y0) ** <span class="number">2</span></span><br><span class="line">    <span class="keyword">return</span> amplitude * torch.exp(-r2 / waist**<span class="number">2</span>)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">w0 = <span class="number">150e-6</span></span><br><span class="line">U_in = gaussian_beam(X, Y, waist=w0)</span><br></pre></td></tr></table></figure><p>这里依然要区分 field 和 intensity：$U(x,y)\neq I(x,y)$，真正的 intensity 是</p><div class="mathjax-block">$$I(x,y)=|U(x,y)|^2.$$</div><h3 id="构造-four-Gaussian-target"><a href="#构造-four-Gaussian-target" class="headerlink" title="构造 four-Gaussian target"></a>构造 four-Gaussian target</h3><p>论文原始 Listing 2 中的 target 并不是程序生成的，而是通过类似下面的代码加载已有 spatial profile：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">target_field = torch.load(<span class="string">&quot;target.pt&quot;</span>)</span><br></pre></td></tr></table></figure><p>这只是对论文实现的说明，不属于本文后续计算链。本文和上一篇一样，自行构造一个 four-Gaussian target：</p><div class="mathjax-block">$$U_{\rm target}=\sum_{j=1}^4G_j.$$</div><p>四个中心为 $(-d,-d)$、$(-d,d)$、$(d,-d)$ 和 $(d,d)$，这里取 $d&#x3D;0.5,{\rm mm}$。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">four_gaussian_target</span>(<span class="params">X, Y, offset, waist</span>):</span><br><span class="line">    centers = [</span><br><span class="line">        (-offset, -offset),</span><br><span class="line">        (-offset, +offset),</span><br><span class="line">        (+offset, -offset),</span><br><span class="line">        (+offset, +offset),</span><br><span class="line">    ]</span><br><span class="line"></span><br><span class="line">    U = torch.zeros_like(X)</span><br><span class="line">    <span class="keyword">for</span> x0, y0 <span class="keyword">in</span> centers:</span><br><span class="line">        U = U + gaussian_beam(X, Y, waist=waist, x0=x0, y0=y0)</span><br><span class="line">    <span class="keyword">return</span> U</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">U_target = four_gaussian_target(X, Y, offset=<span class="number">0.5e-3</span>, waist=w0)</span><br></pre></td></tr></table></figure><p>所以这里并不是逐 pixel 恢复论文的 <code>target.pt</code>，而是复现相同的 inverse-design problem：</p><div class="mathjax-block">$$\text{single Gaussian}\rightarrow\text{four Gaussian modes}.$$</div><h3 id="Field-normalization"><a href="#Field-normalization" class="headerlink" title="Field normalization"></a>Field normalization</h3><p>定义 power：</p><div class="mathjax-block">$$P=\iint|U(x,y)|^2\,dxdy\approx\sum_{m,n}|U_{mn}|^2\Delta x\Delta y.$$</div><p>归一化函数和调用方式为：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">normalize_field</span>(<span class="params">U, dx, dy</span>):</span><br><span class="line">    power = torch.<span class="built_in">sum</span>(torch.<span class="built_in">abs</span>(U) ** <span class="number">2</span>) * dx * dy</span><br><span class="line">    <span class="keyword">return</span> U / torch.sqrt(power)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">U_in = normalize_field(U_in, dx, dy)</span><br><span class="line">U_target = normalize_field(U_target, dx, dy)</span><br></pre></td></tr></table></figure><p>此时 $\iint |U|^2dxdy&#x3D;1$。</p><hr><h2 id="四、构建可微的传播算子"><a href="#四、构建可微的传播算子" class="headerlink" title="四、构建可微的传播算子"></a>四、构建可微的传播算子</h2><h3 id="ASM-transfer-function"><a href="#ASM-transfer-function" class="headerlink" title="ASM transfer function"></a>ASM transfer function</h3><p><code>H</code> 是传播距离为 $z$ 的 Angular Spectrum Method transfer function。它不是待优化参数，而是由采样网格、波长和传播距离一次性计算出的二维复数 tensor。对于输入场中的每个空间频率分量，<code>H</code> 给出它传播 $z$ 之后积累的相位与衰减：</p><div class="mathjax-block">$$U_z=\mathcal F^{-1}\!\left[\mathcal F(U_0)H\right],\qquad H(k_x,k_y;z)=e^{ik_z z}.$$</div><p>构造过程分为三步。<code>torch.fft.fftfreq()</code> 根据像素数和采样间隔生成与离散 FFT 一一对应的空间频率坐标 $f_x$、$f_y$，<code>fftshift()</code> 再把零频移动到数组中心。接着将 cycles&#x2F;m 转换为 rad&#x2F;m，并依据自由空间色散关系计算纵向波矢：</p><div class="mathjax-block">$$k=\frac{2\pi}{\lambda},\qquad k_x=2\pi f_x,\qquad k_y=2\pi f_y,\qquad k_z=\sqrt{k^2-k_x^2-k_y^2}.$$</div><p>最后，对每个 $(k_x,k_y)$ 计算 $e^{ik_z z}$，就得到与输入频谱尺寸相同的二维传输函数 <code>H</code>：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">make_transfer_function</span>(<span class="params"></span></span><br><span class="line"><span class="params">    Nx, Ny, dx, dy, wavelength, z, real_dtype, complex_dtype, device</span></span><br><span class="line"><span class="params"></span>):</span><br><span class="line">    fx = torch.fft.fftshift(</span><br><span class="line">        torch.fft.fftfreq(Nx, d=dx, dtype=real_dtype, device=device)</span><br><span class="line">    )</span><br><span class="line">    fy = torch.fft.fftshift(</span><br><span class="line">        torch.fft.fftfreq(Ny, d=dy, dtype=real_dtype, device=device)</span><br><span class="line">    )</span><br><span class="line">    FY, FX = torch.meshgrid(fy, fx, indexing=<span class="string">&quot;ij&quot;</span>)</span><br><span class="line"></span><br><span class="line">    k = <span class="number">2</span> * torch.pi / wavelength</span><br><span class="line">    KX = <span class="number">2</span> * torch.pi * FX</span><br><span class="line">    KY = <span class="number">2</span> * torch.pi * FY</span><br><span class="line">    kz2 = k**<span class="number">2</span> - KX**<span class="number">2</span> - KY**<span class="number">2</span></span><br><span class="line">    KZ = torch.sqrt(kz2.to(complex_dtype))</span><br><span class="line">    <span class="keyword">return</span> torch.exp(<span class="number">1j</span> * z * KZ)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">wavelength = <span class="number">700e-9</span></span><br><span class="line">propagation_distance = <span class="number">0.2</span></span><br><span class="line">H = make_transfer_function(</span><br><span class="line">    Nx=Nx,</span><br><span class="line">    Ny=Ny,</span><br><span class="line">    dx=dx,</span><br><span class="line">    dy=dy,</span><br><span class="line">    wavelength=wavelength,</span><br><span class="line">    z=propagation_distance,</span><br><span class="line">    real_dtype=real_dtype,</span><br><span class="line">    complex_dtype=complex_dtype,</span><br><span class="line">    device=device,</span><br><span class="line">)</span><br></pre></td></tr></table></figure><p>这里 <code>H.shape == (Ny, Nx)</code>，并与 centered FFT 后的 <code>spectrum</code> 逐点相乘。由于系统的三段传播距离都为 $0.2,\mathrm{m}$，三次传播可以复用同一个 <code>H</code>；如果三段距离不同，则应分别构造 <code>H1</code>、<code>H2</code> 和 <code>H3</code>。</p><p>把 <code>kz2</code> 转换成 <code>complex_dtype</code> 是故意的。前面已经令 <code>complex_dtype = torch.complex128</code>，因此这里会以复数形式计算平方根。理论上，当 $k_x^2+k_y^2&gt;k^2$ 时，$k_z$ 会变成 imaginary number，对应 evanescent component。虽然当前 sampling 参数实际上不会走到这一部分，把公式写成 complex 形式仍然更完整。</p><h3 id="Centered-FFT-与传播"><a href="#Centered-FFT-与传播" class="headerlink" title="Centered FFT 与传播"></a>Centered FFT 与传播</h3><p>和 NumPy 版本一样，先定义 centered FFT：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">fft2c</span>(<span class="params">U</span>):</span><br><span class="line">    <span class="keyword">return</span> torch.fft.fftshift(torch.fft.fft2(torch.fft.ifftshift(U)))</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">ifft2c</span>(<span class="params">A</span>):</span><br><span class="line">    <span class="keyword">return</span> torch.fft.fftshift(torch.fft.ifft2(torch.fft.ifftshift(A)))</span><br></pre></td></tr></table></figure><p>传播函数直接把输入场变换到频域，与 <code>H</code> 相乘，再变换回空间域：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">propagate</span>(<span class="params">U, H</span>):</span><br><span class="line">    spectrum = fft2c(U)</span><br><span class="line">    propagated_spectrum = spectrum * H</span><br><span class="line">    <span class="keyword">return</span> ifft2c(propagated_spectrum)</span><br></pre></td></tr></table></figure><p>这些全部都是 <code>torch.*</code> operations，因此 PyTorch 会记录 $U\rightarrow\mathrm{FFT}\rightarrow H\rightarrow\mathrm{IFFT}$。<code>torch.fft</code> 本身支持 autograd，所以 gradient 可以穿过整个传播过程。</p><h3 id="Phase-modulation"><a href="#Phase-modulation" class="headerlink" title="Phase modulation"></a>Phase modulation</h3><p>phase-only SLM 满足</p><div class="mathjax-block">$$M(x,y)=e^{i\phi(x,y)},\qquad U'=Ue^{i\phi}.$$</div><p>PyTorch 实现很直接：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">phase_modulate</span>(<span class="params">U, phi</span>):</span><br><span class="line">    <span class="keyword">return</span> U * torch.exp(<span class="number">1j</span> * phi)</span><br></pre></td></tr></table></figure><p>这里 <code>phi</code> 是 real tensor，但 <code>torch.exp(1j * phi)</code> 会变成 complex tensor。</p><hr><h2 id="五、把物理系统封装为-nn-Module"><a href="#五、把物理系统封装为-nn-Module" class="headerlink" title="五、把物理系统封装为 nn.Module"></a>五、把物理系统封装为 <code>nn.Module</code></h2><h3 id="Parameter-与-buffer：区分可训练参数和固定状态"><a href="#Parameter-与-buffer：区分可训练参数和固定状态" class="headerlink" title="Parameter 与 buffer：区分可训练参数和固定状态"></a>Parameter 与 buffer：区分可训练参数和固定状态</h3><p>前面已经定义了 <code>phase_modulate()</code>、<code>propagate()</code> 和传播传输函数 <code>H</code>。接下来把三块相位调制器及三段自由空间传播组合成一个完整模型。与 NumPy + Autograd 版本不同，这里不再分别维护 <code>phi1</code>、<code>phi2</code>、<code>phi3</code> 及其梯度，而是把它们注册为 <code>torch.nn.Parameter</code>，让 PyTorch 自动收集和更新。</p><p>传播传输函数 <code>H</code> 也属于模型状态，但它由波长、采样网格和传播距离决定，不应该被 optimizer 更新。因此用 <code>register_buffer()</code> 保存它，而不是把它定义成 Parameter。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">class</span> <span class="title class_">ThreePlanePhaseSystem</span>(torch.nn.Module):</span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params"></span></span><br><span class="line"><span class="params">        self,</span></span><br><span class="line"><span class="params">        Ny,</span></span><br><span class="line"><span class="params">        Nx,</span></span><br><span class="line"><span class="params">        H1,</span></span><br><span class="line"><span class="params">        H2,</span></span><br><span class="line"><span class="params">        H3,</span></span><br><span class="line"><span class="params">        dtype=torch.float64,</span></span><br><span class="line"><span class="params">    </span>):</span><br><span class="line">        <span class="built_in">super</span>().__init__()</span><br><span class="line"></span><br><span class="line">        self.phi1 = torch.nn.Parameter(torch.zeros(Ny, Nx, dtype=dtype))</span><br><span class="line">        self.phi2 = torch.nn.Parameter(torch.zeros(Ny, Nx, dtype=dtype))</span><br><span class="line">        self.phi3 = torch.nn.Parameter(torch.zeros(Ny, Nx, dtype=dtype))</span><br><span class="line"></span><br><span class="line">        self.register_buffer(<span class="string">&quot;H1&quot;</span>, H1)</span><br><span class="line">        self.register_buffer(<span class="string">&quot;H2&quot;</span>, H2)</span><br><span class="line">        self.register_buffer(<span class="string">&quot;H3&quot;</span>, H3)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">forward</span>(<span class="params">self, U</span>):</span><br><span class="line">        U = phase_modulate(U, self.phi1)</span><br><span class="line">        U = propagate(U, self.H1)</span><br><span class="line"></span><br><span class="line">        U = phase_modulate(U, self.phi2)</span><br><span class="line">        U = propagate(U, self.H2)</span><br><span class="line"></span><br><span class="line">        U = phase_modulate(U, self.phi3)</span><br><span class="line">        U = propagate(U, self.H3)</span><br><span class="line"></span><br><span class="line">        <span class="keyword">return</span> U</span><br></pre></td></tr></table></figure><p>三张 phase map 都从零开始，因此模型初始状态对应三块透明的 phase-only modulator。<code>model.parameters()</code> 会返回 <code>phi1</code>、<code>phi2</code> 和 <code>phi3</code>，而 <code>H</code> 不会出现在 optimizer 的参数列表中。与此同时，<code>H</code> 仍会出现在 <code>model.state_dict()</code> 里，并且在调用 <code>.to(device)</code> 时与三张 phase map 一起移动到目标设备。</p><h3 id="实例化模型并执行完整前向传播"><a href="#实例化模型并执行完整前向传播" class="headerlink" title="实例化模型并执行完整前向传播"></a>实例化模型并执行完整前向传播</h3><p>类定义完成后，需要把前面构造的 <code>H</code> 传入模型，并将整个模型移动到与 <code>U_in</code>、<code>U_target</code> 相同的设备。由于三段传播距离相同，三个 buffer 都传入同一个 transfer function：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line">model = ThreePlanePhaseSystem(</span><br><span class="line">    Ny,</span><br><span class="line">    Nx,</span><br><span class="line">    H,</span><br><span class="line">    H,</span><br><span class="line">    H,</span><br><span class="line">    dtype=real_dtype,</span><br><span class="line">).to(device)</span><br><span class="line"></span><br><span class="line">U_out = model(U_in)</span><br></pre></td></tr></table></figure><p><code>model(U_in)</code> 会自动调用 <code>forward()</code>。其内部计算链为：</p><div class="mathjax-block">$$U_{\rm in}\xrightarrow{e^{i\phi_1}}\xrightarrow{P_{0.2\,{\rm m}}}\xrightarrow{e^{i\phi_2}}\xrightarrow{P_{0.2\,{\rm m}}}\xrightarrow{e^{i\phi_3}}\xrightarrow{P_{0.2\,{\rm m}}}U_{\rm out}.$$</div><p>因此，<code>nn.Module</code> 并不等于 neural network；它可以封装任意由 PyTorch operations 构成的 differentiable computational model。这里封装的不是神经网络层，而是一个具有三张可训练 phase map 的物理光学系统。至此，前面分别定义的调制函数、传播函数和 transfer function 已经连接成一条可以实际调用的 forward path，下一步只需要为 <code>U_out</code> 定义 loss 并执行反向传播。</p><hr><h2 id="六、定义损失并执行优化"><a href="#六、定义损失并执行优化" class="headerlink" title="六、定义损失并执行优化"></a>六、定义损失并执行优化</h2><h3 id="Mode-overlap-loss"><a href="#Mode-overlap-loss" class="headerlink" title="Mode-overlap loss"></a>Mode-overlap loss</h3><p>论文使用：</p><div class="mathjax-block">$$L=1-\left|\iint U_{\rm out}(x,y)U_{\rm target}^*(x,y)\,dxdy\right|^2.$$</div><p>这里写成更一般的 normalized mode overlap：</p><div class="mathjax-block">$$\eta=\frac{|\langle U_t,U_o\rangle|^2}{\|U_t\|^2\|U_o\|^2}.$$</div><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">mode_overlap</span>(<span class="params">U_out, U_target, dx, dy</span>):</span><br><span class="line">    inner = torch.<span class="built_in">sum</span>(torch.conj(U_target) * U_out) * dx * dy</span><br><span class="line">    power_out = torch.<span class="built_in">sum</span>(torch.<span class="built_in">abs</span>(U_out) ** <span class="number">2</span>) * dx * dy</span><br><span class="line">    power_target = torch.<span class="built_in">sum</span>(torch.<span class="built_in">abs</span>(U_target) ** <span class="number">2</span>) * dx * dy</span><br><span class="line">    eta = torch.<span class="built_in">abs</span>(inner) ** <span class="number">2</span> / (power_out * power_target)</span><br><span class="line">    <span class="keyword">return</span> eta.real</span><br></pre></td></tr></table></figure><p>损失写成 <code>loss = 1 - eta</code>。如果 $U_{\rm out}&#x3D;U_{\rm target}$，那么 $\eta&#x3D;1$，所以 $L&#x3D;0$。</p><h3 id="loss-backward-如何计算-phase-gradient"><a href="#loss-backward-如何计算-phase-gradient" class="headerlink" title="loss.backward() 如何计算 phase gradient"></a><code>loss.backward()</code> 如何计算 phase gradient</h3><p>最核心的一行是：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">loss.backward()</span><br></pre></td></tr></table></figure><p>它实际上是在同时计算</p><div class="mathjax-block">$$\frac{\partial L}{\partial\phi_1},\qquad \frac{\partial L}{\partial\phi_2},\qquad \frac{\partial L}{\partial\phi_3}.$$</div><p>反向传播会沿着整个 computational graph 逆向执行：</p><div class="mathjax-block">$$L\rightarrow U_{\rm out}\rightarrow\mathrm{IFFT}\rightarrow H\rightarrow\mathrm{FFT}\rightarrow e^{i\phi_3}\rightarrow\cdots\rightarrow\phi_1.$$</div><p>PyTorch 的 autograd 会在 forward execution 时动态记录这些 tensor operations，并在 backward 时利用 chain rule 计算 gradient。计算后，<code>model.phi1.grad</code>、<code>model.phi2.grad</code> 和 <code>model.phi3.grad</code> 分别保存</p><div class="mathjax-block">$$\nabla_{\phi_1}L,\qquad \nabla_{\phi_2}L,\qquad \nabla_{\phi_3}L.$$</div><h3 id="Adam-与-optimization-loop"><a href="#Adam-与-optimization-loop" class="headerlink" title="Adam 与 optimization loop"></a>Adam 与 optimization loop</h3><p>上一篇我们手写了 Adam，这次直接把模型参数交给 PyTorch：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">optimizer = torch.optim.Adam(model.parameters(), lr=<span class="number">0.1</span>)</span><br></pre></td></tr></table></figure><p><code>model.parameters()</code> 会自动返回 <code>phi1</code>、<code>phi2</code> 和 <code>phi3</code>，但不会包含 <code>H</code>，因为 <code>H</code> 是 buffer，不是 Parameter。完整训练循环为：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">for</span> iteration <span class="keyword">in</span> <span class="built_in">range</span>(<span class="number">400</span>):</span><br><span class="line">    optimizer.zero_grad(set_to_none=<span class="literal">True</span>)</span><br><span class="line">    U_out = model(U_in)</span><br><span class="line">    eta = mode_overlap(U_out, U_target, dx, dy)</span><br><span class="line">    loss = <span class="number">1</span> - eta</span><br><span class="line">    loss.backward()</span><br><span class="line">    optimizer.step()</span><br></pre></td></tr></table></figure><p>这几行就是整个 inverse design。</p><hr><h2 id="七、PyTorch-实现中的边界与注意点"><a href="#七、PyTorch-实现中的边界与注意点" class="headerlink" title="七、PyTorch 实现中的边界与注意点"></a>七、PyTorch 实现中的边界与注意点</h2><h3 id="为什么必须清除累计梯度"><a href="#为什么必须清除累计梯度" class="headerlink" title="为什么必须清除累计梯度"></a>为什么必须清除累计梯度</h3><p>PyTorch 的 gradient 默认是累加的。第一次 <code>loss.backward()</code> 得到 $g_1$，第二次如果不清零，就会得到 $\mathrm{grad}&#x3D;g_1+g_2$。但这里希望每个 iteration 使用当前 loss 对参数的 gradient，因此每轮训练前要调用：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">optimizer.zero_grad()</span><br></pre></td></tr></table></figure><p>更常见的写法是：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">optimizer.zero_grad(set_to_none=<span class="literal">True</span>)</span><br></pre></td></tr></table></figure><h3 id="detach-只能用于计算图之外"><a href="#detach-只能用于计算图之外" class="headerlink" title="detach() 只能用于计算图之外"></a><code>detach()</code> 只能用于计算图之外</h3><p>训练过程中不能随便写 <code>U = U.detach()</code>，因为 <code>detach()</code> 意味着从这里切断 computational graph。如果执行</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">U = propagate(U, H)</span><br><span class="line">U = U.detach()</span><br></pre></td></tr></table></figure><p>loss 就不能再通过 $U$ 反向传播到前面的 phase modulator。因此，<code>detach()</code> 只应该用于 plot、save 或 NumPy conversion 等计算图之外的操作。</p><p>优化结束后，可以先在不记录梯度的条件下重新计算输出，再转换成 NumPy array 用于绘图或保存：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">with</span> torch.no_grad():</span><br><span class="line">    U_final = model(U_in)</span><br><span class="line"></span><br><span class="line">image = U_final.cpu().numpy()</span><br></pre></td></tr></table></figure><p><code>torch.no_grad()</code> 已经阻止这次 forward 建立计算图，因此这里不再需要额外调用 <code>detach()</code>。如果处理的是训练过程中已经位于计算图内的 tensor，则应使用 <code>tensor.detach().cpu().numpy()</code>。</p><h3 id="CPU、CUDA-与-Apple-Silicon"><a href="#CPU、CUDA-与-Apple-Silicon" class="headerlink" title="CPU、CUDA 与 Apple Silicon"></a>CPU、CUDA 与 Apple Silicon</h3><p>如果有 NVIDIA GPU，可以使用 <code>device = torch.device(&quot;cuda&quot;)</code>，否则使用 <code>device = torch.device(&quot;cpu&quot;)</code>。PyTorch 的 FFT 可以运行在 CPU 或 CUDA accelerator 上，并且支持 autograd。</p><p>对于这篇 reference implementation，我建议优先保证</p><div class="mathjax-block">$$\text{correctness}&gt;\text{GPU acceleration}.$$</div><p>尤其在 Apple Silicon 上，MPS 的 complex FFT 后端目前仍存在一些特定 FFT shape &#x2F; dimension 的兼容性问题，因此第一次验证算法时用 CPU 更稳妥。代码里因此使用：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">device = torch.device(<span class="string">&quot;cuda&quot;</span> <span class="keyword">if</span> torch.cuda.is_available() <span class="keyword">else</span> <span class="string">&quot;cpu&quot;</span>)</span><br></pre></td></tr></table></figure><hr><h2 id="八、从-NumPy-Autograd-到-PyTorch"><a href="#八、从-NumPy-Autograd-到-PyTorch" class="headerlink" title="八、从 NumPy + Autograd 到 PyTorch"></a>八、从 NumPy + Autograd 到 PyTorch</h2><h3 id="可微光学训练循环的核心五步"><a href="#可微光学训练循环的核心五步" class="headerlink" title="可微光学训练循环的核心五步"></a>可微光学训练循环的核心五步</h3><p>把所有细节去掉以后，PyTorch 版本的核心就是：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line">model = ThreePlanePhaseSystem(</span><br><span class="line">    Ny=Ny,</span><br><span class="line">    Nx=Nx,</span><br><span class="line">    H1=H,</span><br><span class="line">    H2=H,</span><br><span class="line">    H3=H,</span><br><span class="line">    dtype=real_dtype,</span><br><span class="line">).to(device)</span><br><span class="line">optimizer = torch.optim.Adam(model.parameters(), lr=<span class="number">0.1</span>)</span><br><span class="line"></span><br><span class="line"><span class="keyword">for</span> iteration <span class="keyword">in</span> <span class="built_in">range</span>(<span class="number">400</span>):</span><br><span class="line">    optimizer.zero_grad(set_to_none=<span class="literal">True</span>)</span><br><span class="line">    U_out = model(U_in)</span><br><span class="line">    eta = mode_overlap(U_out, U_target, dx, dy)</span><br><span class="line">    loss = <span class="number">1</span> - eta</span><br><span class="line">    loss.backward()</span><br><span class="line">    optimizer.step()</span><br></pre></td></tr></table></figure><p>所以 differentiable optics 最核心的模式其实就是：</p><div class="mathjax-block">$$\text{Physical Model}\rightarrow\text{Differentiable Model}\rightarrow\text{Optimization}.$$</div><p>这里完全没有要求 physical model 必须是 neural network。它可以是 ASM、Fresnel propagation、Rayleigh-Sommerfeld propagation，也可以包含 lens、aperture、aberration、SLM、DOE、detector 或 PSF model。只要 $\text{parameter}\rightarrow\text{output}$ 这一整条计算链可微，就可以做 inverse design。</p><h3 id="还能优化哪些光学参数"><a href="#还能优化哪些光学参数" class="headerlink" title="还能优化哪些光学参数"></a>还能优化哪些光学参数</h3><p>目前只优化 $\phi_1$、$\phi_2$ 和 $\phi_3$，但一旦 optical simulator 已经进入 PyTorch，其他参数同样可以成为 <code>torch.nn.Parameter</code>，例如 lens focal length $f$、传播距离 $z$、Zernike coefficients $a_1,a_2,\ldots,a_N$、DOE height profile $h(x,y)$、refractive-index distribution $n(x,y,z)$，甚至 wavelength-dependent optical parameters。</p><p>例如 phase DOE：</p><div class="mathjax-block">$$\phi(x,y)=\frac{2\pi}{\lambda}[n(\lambda)-1]h(x,y).$$</div><p>如果写成</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">h = torch.nn.Parameter(...)</span><br></pre></td></tr></table></figure><p>PyTorch 就可以计算 $\partial L&#x2F;\partial h$。这时优化的就不再只是数字 phase map，而可以逐渐靠近真正可制造的 optical element。</p><h3 id="Differentiable-optics-不等于-AI"><a href="#Differentiable-optics-不等于-AI" class="headerlink" title="Differentiable optics 不等于 AI"></a>Differentiable optics 不等于 AI</h3><p>下面两行代码看起来非常像 deep learning：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">loss.backward()</span><br><span class="line">optimizer.step()</span><br></pre></td></tr></table></figure><p>但这个系统其实没有任何 AI。模型完全由 Maxwell &#x2F; scalar diffraction physics 决定，不存在 training data、classification、neural network 或 feature extraction。它本质上是</p><div class="mathjax-block">$$\text{physics-based numerical optimization},$$</div><p>PyTorch 只是计算工具，真正发生的是</p><div class="mathjax-block">$$\text{Physics}+\text{Autograd}+\text{Optimization}.$$</div><p>这也是 differentiable optics 最有意思的地方：它把过去两个比较分离的世界连接起来。传统 computational optics 是</p><div class="mathjax-block">$$\text{given system}\rightarrow\text{simulate output},$$</div><p>现代 optimization 则是</p><div class="mathjax-block">$$\text{given objective}\rightarrow\text{optimize system}.$$</div><p>最终形成</p><div class="mathjax-block">$$\text{Forward Optics}+\text{Automatic Differentiation}=\text{Inverse Optical Design}.$$</div><p>而当这个 physical model 后面再连接 CNN、Transformer 或 reconstruction network 时，才真正进入所谓的 $\text{end-to-end optical + digital co-design}$。</p><p>TorchOptics 本身的设计目标也正是利用 PyTorch 实现 GPU-accelerated、fully differentiable Fourier-optics simulation，并支持 optical hardware 与 digital model 的联合优化。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/09/13/2026-09-14-%E7%94%A8-PyTorch-%E5%AE%9E%E7%8E%B0%E4%B8%80%E4%B8%AA%E5%8F%AF%E5%BE%AE%E5%85%89%E5%AD%A6%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E7%B3%BB%E7%BB%9F/</id>
    <link href="https://believed-breadfruit.top/2026/09/13/2026-09-14-%E7%94%A8-PyTorch-%E5%AE%9E%E7%8E%B0%E4%B8%80%E4%B8%AA%E5%8F%AF%E5%BE%AE%E5%85%89%E5%AD%A6%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1%E7%B3%BB%E7%BB%9F/"/>
    <published>2026-09-13T16:00:00.000Z</published>
    <summary>用原生 PyTorch 搭建可微 Fourier optics 链路，理解相位调制、ASM 传播、complex autograd 与逆向设计优化。</summary>
    <title>用 PyTorch 实现一个可微光学逆向设计系统</title>
    <updated>2026-09-13T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="技术" scheme="https://believed-breadfruit.top/categories/%E6%8A%80%E6%9C%AF/"/>
    <category term="differentiable optics" scheme="https://believed-breadfruit.top/tags/differentiable-optics/"/>
    <category term="inverse design" scheme="https://believed-breadfruit.top/tags/inverse-design/"/>
    <category term="Python" scheme="https://believed-breadfruit.top/tags/Python/"/>
    <category term="automatic differentiation" scheme="https://believed-breadfruit.top/tags/automatic-differentiation/"/>
    <content>
      <![CDATA[<blockquote><p><strong>Runnable code</strong></p><p>完整项目见 <a href="https://github.com/janice143/computational-optics">GitHub 仓库</a>，代码按职责组织如下：</p><ul><li>完整可运行实验：<a href="../numerical-simulation/autograd-inverse-design.ipynb"><code>autograd-inverse-design.ipynb</code></a>，包含可微 ASM、Gaussian 输入与目标场、mode-overlap loss、Autograd 梯度、Adam 优化，以及最终光场和三张相位图的可视化。</li><li>正文中的代码片段均摘自该 notebook，并按计算链路拆分讲解。</li></ul></blockquote><p>最近在学习论文 <a href="https://arxiv.org/abs/2411.18591"><em>TorchOptics: An open-source Python library for differentiable Fourier optics simulations</em></a>。</p><h2 id="一、问题场景：用三块相位调制器完成光束变换"><a href="#一、问题场景：用三块相位调制器完成光束变换" class="headerlink" title="一、问题场景：用三块相位调制器完成光束变换"></a>一、问题场景：用三块相位调制器完成光束变换</h2><h3 id="优化目标"><a href="#优化目标" class="headerlink" title="优化目标"></a>优化目标</h3><blockquote><p>给定一个输入光场和目标光场，不再人工设计每一块相位板，而是把相位分布当成待优化参数，通过光场传播、loss 和梯度下降，自动寻找合适的 phase profile。</p></blockquote><p>论文 Figure 4 给出了一个很小但非常完整的例子：</p><div class="mathjax-block">$$\text{Gaussian beam}\rightarrowM_1\rightarrow P\rightarrowM_2\rightarrow P\rightarrowM_3\rightarrow P\rightarrow\text{four Gaussian beams}.$$</div><h3 id="光学系统布局"><a href="#光学系统布局" class="headerlink" title="光学系统布局"></a>光学系统布局</h3><p>其中三块 phase modulator 分别位于</p><div class="mathjax-block">$$z=0,\quad 0.2,\quad 0.4\ {\rm m},$$</div><p>目标平面位于</p><div class="mathjax-block">$$z=0.6\ {\rm m}.$$</div><h3 id="数值参数"><a href="#数值参数" class="headerlink" title="数值参数"></a>数值参数</h3><p>论文使用 $250\times250$ 的采样网格、$10,\mu{\rm m}$ pixel spacing、$700,{\rm nm}$ 波长和 $150,\mu{\rm m}$ Gaussian waist，并用 Adam、$lr&#x3D;0.1$ 训练 400 iterations。</p><h3 id="初始条件与待优化参数"><a href="#初始条件与待优化参数" class="headerlink" title="初始条件与待优化参数"></a>初始条件与待优化参数</h3><p>输入是 waist 为 $150,\mu{\rm m}$ 的单束 Gaussian，目标是在四个指定位置形成四束 Gaussian。三块调制器的 phase profile</p><div class="mathjax-block">$$\phi_1(x,y),\quad \phi_2(x,y),\quad \phi_3(x,y)$$</div><p>均从零相位开始，因此初始系统只是让输入 Gaussian 在自由空间传播 $0.6,{\rm m}$。优化要寻找这三张 phase map，使输出 complex field 与目标 mode 尽可能重合。</p><hr><h2 id="二、整体思路：把传播模型接入梯度优化"><a href="#二、整体思路：把传播模型接入梯度优化" class="headerlink" title="二、整体思路：把传播模型接入梯度优化"></a>二、整体思路：把传播模型接入梯度优化</h2><p>TorchOptics 用 PyTorch 把这些步骤全部封装好了。但如果只调用：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">loss.backward()</span><br><span class="line">optimizer.step()</span><br></pre></td></tr></table></figure><p>其实很难真正理解 inverse design 到底发生了什么。</p><p>所以这次我不用 TorchOptics，而是只使用：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">NumPy</span><br><span class="line">Autograd</span><br><span class="line">Matplotlib</span><br></pre></td></tr></table></figure><p>自己搭出完整链路：</p><div class="mathjax-block">$$\text{phase}\rightarrow\text{optical propagation}\rightarrow\text{output field}\rightarrow\text{loss}\rightarrow\text{gradient}\rightarrow\text{Adam}$$</div><p>这里真正想验证的并不是能不能重新造一个 TorchOptics，而是：</p><blockquote><p>一个普通的 Fourier optics simulator，到底怎样变成一个可以做 inverse design 的 simulator？</p></blockquote><hr><h3 id="从-forward-simulation-到-inverse-design"><a href="#从-forward-simulation-到-inverse-design" class="headerlink" title="从 forward simulation 到 inverse design"></a>从 forward simulation 到 inverse design</h3><p>以前写光场传播时，我解决的问题通常是：</p><div class="mathjax-block">$$U_0(x,y)\overset{P}{\longrightarrow}U_z(x,y).$$</div><p>输入场、传播距离和系统参数都是已知的，我们只计算输出。</p><p>例如 Angular Spectrum Method：</p><div class="mathjax-block">$$U_z=\mathcal F^{-1}\left[\mathcal F(U_0)H_z\right],$$</div><p>其中 transfer function 为</p><div class="mathjax-block">$$H_z(k_x,k_y)=\exp\left[iz\sqrt{k^2-k_x^2-k_y^2}\right].$$</div><p>这属于典型的 forward problem：</p><div class="mathjax-block">$$\text{已知 optical system，求 output}$$</div><p>inverse design 则反过来了。</p><p>我们知道输入：</p><div class="mathjax-block">$$U_{\rm in},$$</div><p>也知道希望得到的目标：</p><div class="mathjax-block">$$U_{\rm target},$$</div><p>但是不知道中间的 phase modulator 应该长什么样。</p><p>于是：</p><div class="mathjax-block">$$\phi_1(x,y),\quad\phi_2(x,y),\quad\phi_3(x,y)$$</div><p>变成待求参数。</p><p>问题就变成：</p><div class="mathjax-block">$$\text{寻找 }\phi_1,\phi_2,\phi_3\text{，使 }U_{\rm out}\approx U_{\rm target}$$</div><p>这已经和训练神经网络非常像了。</p><p>只是我们训练的不是 neural-network weight，而是一个真实光学系统中的 phase profile。</p><hr><h2 id="三、建立可优化的光学问题"><a href="#三、建立可优化的光学问题" class="headerlink" title="三、建立可优化的光学问题"></a>三、建立可优化的光学问题</h2><h3 id="三平面-phase-modulator-的-forward-model"><a href="#三平面-phase-modulator-的-forward-model" class="headerlink" title="三平面 phase modulator 的 forward model"></a>三平面 phase modulator 的 forward model</h3><p>每块 phase modulator 的 transmission function 为</p><div class="mathjax-block">$$M_j(x,y)=e^{i\phi_j(x,y)}.$$</div><p>所以通过一块 phase-only SLM 后：</p><div class="mathjax-block">$$U'(x,y)=U(x,y)e^{i\phi_j(x,y)}.$$</div><p>三块调制器组成的完整 forward model 为：</p><div class="mathjax-block">$$U_1=U_{\rm in}e^{i\phi_1},$$</div><div class="mathjax-block">$$U_2=P_{z}(U_1)e^{i\phi_2},$$</div><div class="mathjax-block">$$U_3=P_{z}(U_2)e^{i\phi_3},$$</div><p>最后</p><div class="mathjax-block">$$U_{\rm out}=P_{z}(U_3).$$</div><p>用代码写出来反而非常简单：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">forward</span>(<span class="params">U_in, phi1, phi2, phi3, H</span>):</span><br><span class="line">    U = phase_modulate(U_in, phi1)</span><br><span class="line"></span><br><span class="line">    U = propagate(U, H)</span><br><span class="line">    U = phase_modulate(U, phi2)</span><br><span class="line"></span><br><span class="line">    U = propagate(U, H)</span><br><span class="line">    U = phase_modulate(U, phi3)</span><br><span class="line"></span><br><span class="line">    U = propagate(U, H)</span><br><span class="line">    <span class="keyword">return</span> U</span><br></pre></td></tr></table></figure><p>这里的 <code>H</code> 是传播距离为 $0.2,{\rm m}$ 的 ASM transfer function；三段自由空间传播使用同一个 <code>H</code>。<code>phase_modulate()</code> 与 <code>propagate()</code> 会在后文分别定义。这个函数就是整个 inverse-design forward model。</p><hr><h3 id="输入-Gaussian-beam"><a href="#输入-Gaussian-beam" class="headerlink" title="输入 Gaussian beam"></a>输入 Gaussian beam</h3><p>输入使用 Gaussian field：</p><div class="mathjax-block">$$U(x,y)=C\exp\left[-\frac{(x-x_0)^2+(y-y_0)^2}{w_0^2}\right].$$</div><p>注意这里定义的是 field amplitude，而不是 intensity。</p><p>因此：</p><div class="mathjax-block">$$I(x,y)=|U(x,y)|^2.$$</div><p>代码：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">gaussian_beam</span>(<span class="params">w0, C, X, Y, x0=<span class="number">0.0</span>, y0=<span class="number">0.0</span></span>):</span><br><span class="line">    R2 = (X - x0)**<span class="number">2</span> + (Y - y0)**<span class="number">2</span></span><br><span class="line">    <span class="keyword">return</span> C * np.exp(-R2 / w0**<span class="number">2</span>)</span><br></pre></td></tr></table></figure><p>采用论文参数：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">wavelength = <span class="number">700e-9</span></span><br><span class="line"></span><br><span class="line">Nx = <span class="number">250</span></span><br><span class="line">Ny = <span class="number">250</span></span><br><span class="line"></span><br><span class="line">dx = <span class="number">10e-6</span></span><br><span class="line">dy = <span class="number">10e-6</span></span><br><span class="line"></span><br><span class="line">w0 = <span class="number">150e-6</span></span><br></pre></td></tr></table></figure><p>所以整个 simulation window 为</p><div class="mathjax-block">$$L=N\Delta x=250\times10\,\mu{\rm m}=2.5\,{\rm mm}.$$</div><hr><h3 id="构造-four-Gaussian-target"><a href="#构造-four-Gaussian-target" class="headerlink" title="构造 four-Gaussian target"></a>构造 four-Gaussian target</h3><p>论文 Listing 2 并没有直接生成 target，而是：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">target_field = Field(torch.load(<span class="string">&quot;target.pt&quot;</span>), z=<span class="number">0.6</span>)</span><br></pre></td></tr></table></figure><p>也就是说，论文没有在 Listing 2 中给出四个 Gaussian 的具体位置参数。</p><p>因此这里并不是逐像素恢复论文的 <code>target.pt</code>，而是自己构造一个等价任务：</p><div class="mathjax-block">$$U_{\rm target}=\sum_{j=1}^{4}G_j(x,y).$$</div><p>四个 Gaussian 分别位于：</p><div class="mathjax-block">$$(-d,-d),\quad(-d,d),\quad(d,-d),\quad(d,d).$$</div><p>这里取：</p><div class="mathjax-block">$$d=0.5\,{\rm mm}.$$</div><p>代码：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">four_gaussian_target</span>(<span class="params">X, Y, offset, waist, C</span>):</span><br><span class="line">    centers = [</span><br><span class="line">        (-offset, -offset),</span><br><span class="line">        (-offset, +offset),</span><br><span class="line">        (+offset, -offset),</span><br><span class="line">        (+offset, +offset),</span><br><span class="line">    ]</span><br><span class="line"></span><br><span class="line">    U = np.zeros_like(X, dtype=np.complex128)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">for</span> x0, y0 <span class="keyword">in</span> centers:</span><br><span class="line">        U += gaussian_beam(</span><br><span class="line">            waist,</span><br><span class="line">            C,</span><br><span class="line">            X,</span><br><span class="line">            Y,</span><br><span class="line">            x0,</span><br><span class="line">            y0,</span><br><span class="line">        )</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> U</span><br></pre></td></tr></table></figure><p>因此这里的目标是：</p><div class="mathjax-block">$$\text{single Gaussian}\rightarrow\text{four Gaussian beams}$$</div><hr><h3 id="归一化输入场与目标场"><a href="#归一化输入场与目标场" class="headerlink" title="归一化输入场与目标场"></a>归一化输入场与目标场</h3><p>如果直接比较两个 field，它们的总功率也会影响 loss。</p><p>但现在真正关心的是：</p><blockquote><p>输出 field 的 spatial mode 是否和 target 一样？</p></blockquote><p>因此先定义 optical power：</p><div class="mathjax-block">$$P=\iint |U(x,y)|^2dxdy.$$</div><p>离散化以后：</p><div class="mathjax-block">$$P\approx\sum_{m,n}|U_{mn}|^2\Delta x\Delta y.$$</div><p>于是做 normalization：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">normalize</span>(<span class="params">U</span>):</span><br><span class="line">    power = (</span><br><span class="line">        np.<span class="built_in">sum</span>(np.<span class="built_in">abs</span>(U)**<span class="number">2</span>)</span><br><span class="line">        * dx</span><br><span class="line">        * dy</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> U / np.sqrt(power)</span><br></pre></td></tr></table></figure><p>这样：</p><div class="mathjax-block">$$\iint |U|^2dxdy=1.$$</div><p>输入场和 target 都进行归一化。</p><hr><h3 id="Phase-modulator-与零相位初始化"><a href="#Phase-modulator-与零相位初始化" class="headerlink" title="Phase modulator 与零相位初始化"></a>Phase modulator 与零相位初始化</h3><p>Phase-only modulator 不改变 amplitude，只改变 phase：</p><div class="mathjax-block">$$U_{\rm out}=U_{\rm in}e^{i\phi}.$$</div><p>所以代码只有一行：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">phase_modulate</span>(<span class="params">U, phi</span>):</span><br><span class="line">    <span class="keyword">return</span> U * anp.exp(<span class="number">1j</span> * phi)</span><br></pre></td></tr></table></figure><p>一开始我们完全不知道 phase profile 应该是什么，因此初始化：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">phi1 = np.zeros((Ny, Nx))</span><br><span class="line">phi2 = np.zeros((Ny, Nx))</span><br><span class="line">phi3 = np.zeros((Ny, Nx))</span><br></pre></td></tr></table></figure><p>此时：</p><div class="mathjax-block">$$e^{i\phi}=1.$$</div><p>三块 SLM 什么都没有做。</p><p>因此最初的 optical system 实际上只是：</p><div class="mathjax-block">$$\text{Gaussian}\rightarrow0.6\,{\rm m\ free\ space}.$$</div><p>显然不可能自动变成四个 Gaussian。</p><p>接下来就需要优化。</p><hr><h2 id="四、构建可微的前向传播"><a href="#四、构建可微的前向传播" class="headerlink" title="四、构建可微的前向传播"></a>四、构建可微的前向传播</h2><h3 id="Differentiable-ASM"><a href="#Differentiable-ASM" class="headerlink" title="Differentiable ASM"></a>Differentiable ASM</h3><p>我这里使用 Angular Spectrum Method 作为 propagation backend。</p><p>先把输入场变换到 spatial-frequency domain：</p><div class="mathjax-block">$$A(k_x,k_y)=\mathcal F\{U(x,y)\}.$$</div><p>自由空间传播会给每个 plane-wave component 加上不同 phase：</p><div class="mathjax-block">$$A_z=A_0H_z,$$</div><p>其中</p><div class="mathjax-block">$$H_z=\exp(i k_z z),$$</div><p>以及</p><div class="mathjax-block">$$k_z=\sqrt{k^2-k_x^2-k_y^2}.$$</div><p>最后：</p><div class="mathjax-block">$$U_z=\mathcal F^{-1}(A_z).$$</div><p>关键不在 ASM 本身。</p><p>关键在于现在：</p><div class="mathjax-block">$$U$$</div><p>依赖：</p><div class="mathjax-block">$$\phi_1,\phi_2,\phi_3.$$</div><p>因此 FFT 也必须存在于 automatic differentiation 的 computational graph 中。</p><p>这里将固定的 frequency grid 和 transfer function 用普通 NumPy 预先计算，而依赖 phase 的传播路径使用 <code>autograd.numpy</code>：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> numpy <span class="keyword">as</span> np</span><br><span class="line"><span class="keyword">import</span> autograd.numpy <span class="keyword">as</span> anp</span><br></pre></td></tr></table></figure><p>而不能在 differentiable path 中调用普通：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">numpy.fft.fft2</span><br></pre></td></tr></table></figure><p>否则 <code>grad()</code> 会把 phase 包装成 <code>ArrayBox</code>，普通 NumPy FFT 并不知道怎样处理它。</p><p>Autograd 官方文档说明它支持大部分 NumPy FFT 操作以及 complex number differentiation，因此这种包含 complex FFT 的 real-valued objective 可以进行 reverse-mode differentiation。</p><p>传播距离、波长和采样网格在优化过程中保持不变，因此先在 computational graph 外构造 $H$：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">make_asm_transfer_function</span>(<span class="params"></span></span><br><span class="line"><span class="params">    Nx, Ny, dx, dy, wavelength, z</span></span><br><span class="line"><span class="params"></span>):</span><br><span class="line">    fx = np.fft.fftshift(np.fft.fftfreq(Nx, d=dx))</span><br><span class="line">    fy = np.fft.fftshift(np.fft.fftfreq(Ny, d=dy))</span><br><span class="line">    FX, FY = np.meshgrid(fx, fy)</span><br><span class="line"></span><br><span class="line">    k = <span class="number">2</span> * np.pi / wavelength</span><br><span class="line">    KX = <span class="number">2</span> * np.pi * FX</span><br><span class="line">    KY = <span class="number">2</span> * np.pi * FY</span><br><span class="line">    KZ = np.sqrt(</span><br><span class="line">        (k**<span class="number">2</span> - KX**<span class="number">2</span> - KY**<span class="number">2</span>).astype(np.complex128)</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> np.exp(<span class="number">1j</span> * z * KZ)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">H = make_asm_transfer_function(</span><br><span class="line">    Nx=Nx,</span><br><span class="line">    Ny=Ny,</span><br><span class="line">    dx=dx,</span><br><span class="line">    dy=dy,</span><br><span class="line">    wavelength=wavelength,</span><br><span class="line">    z=propagation_distance,</span><br><span class="line">)</span><br></pre></td></tr></table></figure><p>这里的 <code>Nx</code>、<code>Ny</code>、<code>dx</code>、<code>dy</code>、<code>wavelength</code> 和 <code>propagation_distance</code> 就是问题场景中已经给出的数值参数。随后才定义可微的 FFT 传播：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">fft2c</span>(<span class="params">U</span>):</span><br><span class="line">    <span class="keyword">return</span> anp.fft.fftshift(</span><br><span class="line">        anp.fft.fft2(</span><br><span class="line">            anp.fft.ifftshift(U)</span><br><span class="line">        )</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">ifft2c</span>(<span class="params">A</span>):</span><br><span class="line">    <span class="keyword">return</span> anp.fft.fftshift(</span><br><span class="line">        anp.fft.ifft2(</span><br><span class="line">            anp.fft.ifftshift(A)</span><br><span class="line">        )</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">propagate</span>(<span class="params">U, H</span>):</span><br><span class="line">    A = fft2c(U)</span><br><span class="line">    <span class="keyword">return</span> ifft2c(A * H)</span><br></pre></td></tr></table></figure><p>于是 computational graph 变成：</p><div class="mathjax-block">$$\phi\rightarrowe^{i\phi}\rightarrowFFT\rightarrowH\rightarrowIFFT\rightarrowU_{\rm out}.$$</div><p>这一步完成以后，普通 Fourier-optics simulator 就变成了一个 differentiable simulator。</p><hr><h2 id="五、定义目标函数"><a href="#五、定义目标函数" class="headerlink" title="五、定义目标函数"></a>五、定义目标函数</h2><h3 id="Mode-overlap-loss"><a href="#Mode-overlap-loss" class="headerlink" title="Mode-overlap loss"></a>Mode-overlap loss</h3><p>接下来需要回答一个问题：</p><blockquote><p>怎么判断 output 和 target 有多接近？</p></blockquote><p>最直接的方法可能是 intensity MSE：</p><div class="mathjax-block">$$\|I_{\rm out}-I_{\rm target}\|^2.$$</div><p>但论文并不是这样做的。</p><p>它优化的是两个 complex fields 的 mode overlap。论文 loss 为：</p><div class="mathjax-block">$$L=1-\left|\iintU_{\rm out}(x,y)U_{\rm target}^*(x,y)dxdy\right|^2.$$</div><p>为了让实现对 field power 更稳健，我这里显式写成 normalized overlap：</p><div class="mathjax-block">$$\eta=\frac{|\langle U_t,U_o\rangle|^2}{\langle U_o,U_o\rangle\langle U_t,U_t\rangle}.$$</div><p>然后：</p><div class="mathjax-block">$$L=1-\eta$$</div><p>其中：</p><div class="mathjax-block">$$0\le\eta\le1.$$</div><p>当 output 完全等于 target mode：</p><div class="mathjax-block">$$\eta=1,$$</div><p>因此：</p><div class="mathjax-block">$$L=0.$$</div><p>代码：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">mode_overlap</span>(<span class="params">U_out, U_target, dx, dy</span>):</span><br><span class="line">    inner = (</span><br><span class="line">        anp.<span class="built_in">sum</span>(</span><br><span class="line">            anp.conj(U_target)</span><br><span class="line">            * U_out</span><br><span class="line">        )</span><br><span class="line">        * dx</span><br><span class="line">        * dy</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    power_out = (</span><br><span class="line">        anp.<span class="built_in">sum</span>(anp.<span class="built_in">abs</span>(U_out)**<span class="number">2</span>)</span><br><span class="line">        * dx</span><br><span class="line">        * dy</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    power_target = (</span><br><span class="line">        anp.<span class="built_in">sum</span>(anp.<span class="built_in">abs</span>(U_target)**<span class="number">2</span>)</span><br><span class="line">        * dx</span><br><span class="line">        * dy</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    eta = (</span><br><span class="line">        anp.<span class="built_in">abs</span>(inner)**<span class="number">2</span></span><br><span class="line">        / (power_out * power_target)</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> anp.real(eta)</span><br></pre></td></tr></table></figure><p>这里优化的不是简单的 intensity pattern。</p><p>而是 complex optical mode：</p><div class="mathjax-block">$$\text{amplitude + phase}$$</div><p>这也是 mode overlap 相比 intensity MSE 更重要的一点。</p><hr><h3 id="Objective-function"><a href="#Objective-function" class="headerlink" title="Objective function"></a>Objective function</h3><p>整个 optical system 现在已经可以看成一个函数：</p><div class="mathjax-block">$$U_{\rm out}=F(\phi_1,\phi_2,\phi_3).$$</div><p>再把 output 送进 loss：</p><div class="mathjax-block">$$L=L(U_{\rm out},U_{\rm target}).$$</div><p>于是最终：</p><div class="mathjax-block">$$L=L(\phi_1,\phi_2,\phi_3)$$</div><p>代码：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">objective</span>(<span class="params">phi1, phi2, phi3, U_in, U_target, H, dx, dy</span>):</span><br><span class="line">    U_out = forward(U_in, phi1, phi2, phi3, H)</span><br><span class="line">    eta = mode_overlap(U_out, U_target, dx, dy)</span><br><span class="line">    <span class="keyword">return</span> <span class="number">1.0</span> - eta</span><br></pre></td></tr></table></figure><p>这里把输入场、目标场、传播传输函数和积分采样间隔全部显式列出，避免 objective 依赖正文中没有交代的隐式全局状态。</p><hr><h2 id="六、从梯度到参数更新"><a href="#六、从梯度到参数更新" class="headerlink" title="六、从梯度到参数更新"></a>六、从梯度到参数更新</h2><h3 id="Automatic-differentiation"><a href="#Automatic-differentiation" class="headerlink" title="Automatic differentiation"></a>Automatic differentiation</h3><p>我们需要：</p><div class="mathjax-block">$$\frac{\partial L}{\partial\phi_1},\qquad\frac{\partial L}{\partial\phi_2},\qquad\frac{\partial L}{\partial\phi_3}.$$</div><p>每个 $\phi$ 都是一个：</p><div class="mathjax-block">$$250\times250$$</div><p>matrix。</p><p>也就是说单块 phase modulator 就有：</p><div class="mathjax-block">$$62500$$</div><p>个 optimization variables。</p><p>三块一共：</p><div class="mathjax-block">$$187500$$</div><p>个变量。</p><p>手推这样的 gradient 显然没有必要。</p><p>Autograd 可以直接根据 computational graph 使用 reverse-mode automatic differentiation。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">grad_phi1 = grad(objective, <span class="number">0</span>)</span><br><span class="line">grad_phi2 = grad(objective, <span class="number">1</span>)</span><br><span class="line">grad_phi3 = grad(objective, <span class="number">2</span>)</span><br><span class="line"></span><br><span class="line">objective_args = (U_in, U_target, H, dx, dy)</span><br><span class="line"></span><br><span class="line">g1 = grad_phi1(phi1, phi2, phi3, *objective_args)</span><br><span class="line">g2 = grad_phi2(phi1, phi2, phi3, *objective_args)</span><br><span class="line">g3 = grad_phi3(phi1, phi2, phi3, *objective_args)</span><br></pre></td></tr></table></figure><p><code>grad(objective, 0)</code>、<code>grad(objective, 1)</code> 和 <code>grad(objective, 2)</code> 分别指定对前三个 phase 参数求导；其余参数只作为 forward calculation 所需的固定量传入。</p><div class="mathjax-block">$$g_1=\nabla_{\phi_1}L,$$</div><div class="mathjax-block">$$g_2=\nabla_{\phi_2}L,$$</div><div class="mathjax-block">$$g_3=\nabla_{\phi_3}L.$$</div><p>至此最重要的链路已经跑通：</p><div class="mathjax-block">$$\phi\rightarrowe^{i\phi}\rightarrowFFT\rightarrowpropagation\rightarrowU_{\rm out}\rightarrowL\rightarrow\nabla_\phi L$$</div><hr><h3 id="Adam-更新-phase"><a href="#Adam-更新-phase" class="headerlink" title="Adam 更新 phase"></a>Adam 更新 phase</h3><p>最后只剩 optimizer。</p><p>我没有再引入 PyTorch，而是简单实现了一遍 Adam。</p><p>对于 gradient $g_t$：</p><div class="mathjax-block">$$m_t=\beta_1m_{t-1}+(1-\beta_1)g_t,$$</div><div class="mathjax-block">$$v_t=\beta_2v_{t-1}+(1-\beta_2)g_t^2.$$</div><p>经过 bias correction：</p><div class="mathjax-block">$$\hat m_t=\frac{m_t}{1-\beta_1^t},$$</div><div class="mathjax-block">$$\hat v_t=\frac{v_t}{1-\beta_2^t}.$$</div><p>最后：</p><div class="mathjax-block">$$\phi_{t+1}=\phi_t-\alpha\frac{\hat m_t}{\sqrt{\hat v_t}+\epsilon}.$$</div><p>代码：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">class</span> <span class="title class_">Adam</span>:</span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params"></span></span><br><span class="line"><span class="params">        self,</span></span><br><span class="line"><span class="params">        shape,</span></span><br><span class="line"><span class="params">        lr=<span class="number">0.1</span>,</span></span><br><span class="line"><span class="params">        beta1=<span class="number">0.9</span>,</span></span><br><span class="line"><span class="params">        beta2=<span class="number">0.999</span>,</span></span><br><span class="line"><span class="params">        eps=<span class="number">1e-8</span>,</span></span><br><span class="line"><span class="params">    </span>):</span><br><span class="line">        self.lr = lr</span><br><span class="line">        self.beta1 = beta1</span><br><span class="line">        self.beta2 = beta2</span><br><span class="line">        self.eps = eps</span><br><span class="line"></span><br><span class="line">        self.m = np.zeros(shape)</span><br><span class="line">        self.v = np.zeros(shape)</span><br><span class="line">        self.t = <span class="number">0</span></span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">update</span>(<span class="params">self, x, g</span>):</span><br><span class="line">        self.t += <span class="number">1</span></span><br><span class="line"></span><br><span class="line">        self.m = (</span><br><span class="line">            self.beta1 * self.m</span><br><span class="line">            + (<span class="number">1</span> - self.beta1) * g</span><br><span class="line">        )</span><br><span class="line"></span><br><span class="line">        self.v = (</span><br><span class="line">            self.beta2 * self.v</span><br><span class="line">            + (<span class="number">1</span> - self.beta2) * g**<span class="number">2</span></span><br><span class="line">        )</span><br><span class="line"></span><br><span class="line">        m_hat = (</span><br><span class="line">            self.m</span><br><span class="line">            / (<span class="number">1</span> - self.beta1**self.t)</span><br><span class="line">        )</span><br><span class="line"></span><br><span class="line">        v_hat = (</span><br><span class="line">            self.v</span><br><span class="line">            / (<span class="number">1</span> - self.beta2**self.t)</span><br><span class="line">        )</span><br><span class="line"></span><br><span class="line">        <span class="keyword">return</span> (</span><br><span class="line">            x</span><br><span class="line">            - self.lr</span><br><span class="line">            * m_hat</span><br><span class="line">            / (</span><br><span class="line">                np.sqrt(v_hat)</span><br><span class="line">                + self.eps</span><br><span class="line">            )</span><br><span class="line">        )</span><br></pre></td></tr></table></figure><p>三块 phase modulator 分别维护自己的 Adam state：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">adam1 = Adam(phi1.shape, lr=<span class="number">0.1</span>)</span><br><span class="line">adam2 = Adam(phi2.shape, lr=<span class="number">0.1</span>)</span><br><span class="line">adam3 = Adam(phi3.shape, lr=<span class="number">0.1</span>)</span><br></pre></td></tr></table></figure><hr><h3 id="Optimization-loop"><a href="#Optimization-loop" class="headerlink" title="Optimization loop"></a>Optimization loop</h3><p>最终训练循环其实已经非常接近 neural-network training：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line">objective_args = (U_in, U_target, H, dx, dy)</span><br><span class="line"></span><br><span class="line"><span class="keyword">for</span> i <span class="keyword">in</span> <span class="built_in">range</span>(num_iterations):</span><br><span class="line">    loss = objective(phi1, phi2, phi3, *objective_args)</span><br><span class="line"></span><br><span class="line">    g1 = grad_phi1(phi1, phi2, phi3, *objective_args)</span><br><span class="line">    g2 = grad_phi2(phi1, phi2, phi3, *objective_args)</span><br><span class="line">    g3 = grad_phi3(phi1, phi2, phi3, *objective_args)</span><br><span class="line"></span><br><span class="line">    phi1 = adam1.update(phi1, g1)</span><br><span class="line">    phi2 = adam2.update(phi2, g2)</span><br><span class="line">    phi3 = adam3.update(phi3, g3)</span><br></pre></td></tr></table></figure><p>其中 <code>num_iterations=400</code>，三个 <code>Adam</code> 实例分别保存三张 phase map 的一阶矩和二阶矩状态。</p><div class="mathjax-block">$$\text{Gaussian}$$</div><p>经过当前三块 phase masks，</p><p>得到：</p><div class="mathjax-block">$$U_{\rm out}.$$</div><p>计算它与：</p><div class="mathjax-block">$$U_{\rm target}$$</div><p>之间的 mode mismatch，</p><p>再沿着：</p><div class="mathjax-block">$$-\nabla_\phi L$$</div><p>方向调整所有 SLM pixels。</p><p>然后重新传播。</p><p>不断重复。</p><hr><h2 id="七、理解优化结果"><a href="#七、理解优化结果" class="headerlink" title="七、理解优化结果"></a>七、理解优化结果</h2><h3 id="怎样理解训练后的三张-phase-map"><a href="#怎样理解训练后的三张-phase-map" class="headerlink" title="怎样理解训练后的三张 phase map"></a>怎样理解训练后的三张 phase map</h3><p>最终得到：</p><div class="mathjax-block">$$\phi_1(x,y),\qquad\phi_2(x,y),\qquad\phi_3(x,y).$$</div><p>它们通常看起来并不像某种简单 lens 或 grating。</p><p>这是正常的。</p><p>因为 optimizer 并没有被告知：</p><blockquote><p>第一块负责分束，第二块负责聚焦，第三块负责修正。</p></blockquote><p>它只知道最终 objective：</p><div class="mathjax-block">$$U_{\rm out}\rightarrowU_{\rm target}.$$</div><p>因此三块 phase mask 会联合工作。</p><p>可以理解为：</p><div class="mathjax-block">$$M_1,M_2,M_3$$</div><p>共同构成了一个 spatial-mode transformation。</p><p>第一块产生新的 spatial-frequency components，传播过程中这些频率分量积累不同 phase，第二和第三块继续重新组织 amplitude 和 phase，最终让目标 plane 上的 complex field 尽可能接近指定 target。</p><p>这就是 multi-plane light conversion 背后的基本思想之一。</p><hr><h2 id="八、边界、差异与实现注意点"><a href="#八、边界、差异与实现注意点" class="headerlink" title="八、边界、差异与实现注意点"></a>八、边界、差异与实现注意点</h2><h3 id="与原论文的差异：这里固定使用-ASM"><a href="#与原论文的差异：这里固定使用-ASM" class="headerlink" title="与原论文的差异：这里固定使用 ASM"></a>与原论文的差异：这里固定使用 ASM</h3><p>需要特别说明一点。</p><p>论文给出的 propagation-method selection criterion 为：</p><div class="mathjax-block">$$z_{\rm critical}=\frac{L\Delta x}{\lambda}.$$</div><p>当前：</p><div class="mathjax-block">$$L=2.5\,{\rm mm},$$</div><div class="mathjax-block">$$\Delta x=10\,\mu{\rm m},$$</div><div class="mathjax-block">$$\lambda=700\,{\rm nm}.$$</div><p>因此：</p><div class="mathjax-block">$$z_{\rm critical}\approx35.7\,{\rm mm}.$$</div><p>而每次 propagation distance 为：</p><div class="mathjax-block">$$z=200\,{\rm mm}.$$</div><p>也就是说：</p><div class="mathjax-block">$$z&gt;z_{\rm critical}.$$</div><p>按照论文的规则，TorchOptics 在这种情况下默认更倾向使用 Direct Integration，而不是 ASM。论文 Listing 2 没有显式指定 propagation method，而是让 <code>System</code> 自己处理。</p><p>所以这篇文章更准确的表述是：</p><blockquote><p>用 NumPy + Autograd 重写 TorchOptics Figure 4 的 inverse-design architecture，并使用自己实现的 ASM 作为 differentiable propagation backend。</p></blockquote><p>它不是 Figure 4 的逐像素数值复刻。</p><p>如果之后把 <code>propagate()</code> 换成 differentiable DI，其余 optimization pipeline 完全不需要改变。</p><p>这一点实际上也很好地体现了系统设计：</p><div class="mathjax-block">$$\text{propagation model}\quad\text{和}\quad\text{optimization framework}$$</div><p>是两个可以独立替换的模块。</p><hr><h3 id="为什么优化中的-phase-可以超过-2-pi"><a href="#为什么优化中的-phase-可以超过-2-pi" class="headerlink" title="为什么优化中的 phase 可以超过 $2\pi$"></a>为什么优化中的 phase 可以超过 $2\pi$</h3><p>训练过程中我没有执行：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">phi = phi % (<span class="number">2</span> * np.pi)</span><br></pre></td></tr></table></figure><p>因为真正进入 forward model 的是：</p><div class="mathjax-block">$$e^{i\phi}.$$</div><p>而：</p><div class="mathjax-block">$$e^{i(\phi+2\pi n)}=e^{i\phi}.$$</div><p>所以数学上：</p><div class="mathjax-block">$$\phi$$</div><p>和：</p><div class="mathjax-block">$$\phi+2\pi$$</div><p>完全等价。</p><p>因此 optimization 时允许 phase 自由变化没有问题。</p><p>最终显示或映射到实际 SLM 时，再使用：</p><div class="mathjax-block">$$\phi_{\rm SLM}=\phi\bmod2\pi.$$</div><hr><h2 id="九、总结：从-forward-optics-到-inverse-design"><a href="#九、总结：从-forward-optics-到-inverse-design" class="headerlink" title="九、总结：从 forward optics 到 inverse design"></a>九、总结：从 forward optics 到 inverse design</h2><p>以前学习 Fourier optics 时，重点通常是：</p><div class="mathjax-block">$$U_0\rightarrowU_z.$$</div><p>也就是：</p><blockquote><p>光经过一个系统以后会变成什么？</p></blockquote><p>但 inverse design 把问题变成了：</p><div class="mathjax-block">$$\text{target}\rightarrow\text{system parameters}.$$</div><p>也就是：</p><blockquote><p>我想得到这个结果，中间的光学系统应该长什么样？</p></blockquote><p>真正连接这两个问题的并不是某个新的 diffraction formula。</p><p>Forward physics 仍然是：</p><div class="mathjax-block">$$FFT\rightarrowH\rightarrowIFFT.$$</div><p>新增的其实只有三个东西：</p><div class="mathjax-block">$$\text{objective}+\text{gradient}+\text{optimizer}$$</div><p>也就是说：</p><div class="mathjax-block">$$\text{Differentiable Optics}=\text{Forward Optics}+\text{Automatic Differentiation}$$</div><p>forward model 决定：</p><div class="mathjax-block">$$\text{一个设计会产生什么结果};$$</div><p>loss 定义：</p><div class="mathjax-block">$$\text{什么结果算好};$$</div><p>gradient 告诉我们：</p><div class="mathjax-block">$$\text{参数往哪个方向修改};$$</div><p>optimizer 则不断执行这个修改。</p><p>这次真正从头写完之后，TorchOptics 里面：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">loss.backward()</span><br><span class="line">optimizer.step()</span><br></pre></td></tr></table></figure><p>这两行代码背后的物理和计算过程也就不再是黑盒了。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/09/13/2026-09-14-%E7%94%A8-NumPy-%E4%B8%8E-Autograd-%E5%AE%9E%E7%8E%B0%E5%8F%AF%E5%BE%AE%E5%85%89%E5%AD%A6%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1/</id>
    <link href="https://believed-breadfruit.top/2026/09/13/2026-09-14-%E7%94%A8-NumPy-%E4%B8%8E-Autograd-%E5%AE%9E%E7%8E%B0%E5%8F%AF%E5%BE%AE%E5%85%89%E5%AD%A6%E9%80%86%E5%90%91%E8%AE%BE%E8%AE%A1/"/>
    <published>2026-09-13T16:00:00.000Z</published>
    <summary>不用 PyTorch，从头搭建可微 Fourier optics 链路，理解光场传播如何接入自动微分与逆向设计。</summary>
    <title>用 NumPy 与 Autograd 实现可微光学逆向设计</title>
    <updated>2026-09-13T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="Today I Learn" scheme="https://believed-breadfruit.top/categories/Today-I-Learn/"/>
    <category term="光学" scheme="https://believed-breadfruit.top/tags/%E5%85%89%E5%AD%A6/"/>
    <category term="衍射" scheme="https://believed-breadfruit.top/tags/%E8%A1%8D%E5%B0%84/"/>
    <category term="waveprop" scheme="https://believed-breadfruit.top/tags/waveprop/"/>
    <content>
      <![CDATA[<h2 id="导论：传播模型不是彼此独立的公式"><a href="#导论：传播模型不是彼此独立的公式" class="headerlink" title="导论：传播模型不是彼此独立的公式"></a>导论：传播模型不是彼此独立的公式</h2><p>自由空间衍射传播算法看起来很多，但它们并不是彼此独立的公式。把近似发生的位置标出来以后，整个 Propagation Family 实际上非常清楚：</p><div class="mathjax-block">$$\text{Maxwell} \rightarrow \text{Vector Helmholtz} \rightarrow \text{Scalar Helmholtz}$$</div><p>在 scalar Helmholtz 这一层，有两种等价的传播表述：</p><div class="mathjax-block">$$\text{Rayleigh-Sommerfeld} \quad\Longleftrightarrow\quad \text{Angular Spectrum}$$</div><p>然后再施加近轴近似：</p><div class="mathjax-block">$$\text{Scalar Helmholtz} \xrightarrow{\text{paraxial}} \text{Fresnel} \xrightarrow{\text{far field}} \text{Fraunhofer}$$</div><p>而 Direct Integration、FFT-DI、Shifted Fresnel 并不是新的物理理论：</p><div class="mathjax-block">$$\text{RS} \rightarrow [ \begin{cases} \text{Direct Integration}\\ \text{FFT-DI} \end{cases} ]$$</div><div class="mathjax-block">$$\text{Fresnel} \rightarrow \text{Shifted Fresnel}.$$</div><p>这篇文章重点不在“公式长什么样”，而在每一步究竟丢掉了什么物理信息，以及什么时候这个近似会失效。</p><hr><h2 id="一、物理起点：从-Maxwell-到-Scalar-Helmholtz"><a href="#一、物理起点：从-Maxwell-到-Scalar-Helmholtz" class="headerlink" title="一、物理起点：从 Maxwell 到 Scalar Helmholtz"></a>一、物理起点：从 Maxwell 到 Scalar Helmholtz</h2><h3 id="起点：Maxwell-方程"><a href="#起点：Maxwell-方程" class="headerlink" title="起点：Maxwell 方程"></a>起点：Maxwell 方程</h3><p>考虑线性、均匀、各向同性、无自由电荷、无自由电流介质。</p><p>设时间依赖采用</p><div class="mathjax-block">$$e^{-i\omega t}.$$</div><p>频域 Maxwell 方程为：</p><div class="mathjax-block">$$\nabla\times\mathbf E = i\omega\mu\mathbf H,$$</div><div class="mathjax-block">$$\nabla\times\mathbf H = -i\omega\epsilon\mathbf E,$$</div><p>同时：</p><div class="mathjax-block">$$\nabla\cdot(\epsilon\mathbf E)=0, \qquad \nabla\cdot(\mu\mathbf H)=0.$$</div><p>如果介质均匀，即</p><div class="mathjax-block">$$\epsilon=\text{const}, \qquad \mu=\text{const},$$</div><p>那么：</p><div class="mathjax-block">$$\nabla\cdot\mathbf E=0.$$</div><p>对第一式取旋度：</p><div class="mathjax-block">$$\nabla\times(\nabla\times\mathbf E)=i\omega\mu\nabla\times\mathbf H.$$</div><p>代入</p><div class="mathjax-block">$$\nabla\times\mathbf H=-i\omega\epsilon\mathbf E,$$</div><p>得到：</p><div class="mathjax-block">$$\nabla\times(\nabla\times\mathbf E)=\omega^2\mu\epsilon\mathbf E.$$</div><p>利用恒等式：</p><div class="mathjax-block">$$\nabla\times(\nabla\times\mathbf E)=\nabla(\nabla\cdot\mathbf E)-\nabla^2\mathbf E,$$</div><p>以及</p><div class="mathjax-block">$$\nabla\cdot\mathbf E=0,$$</div><p>得到：</p><div class="mathjax-block">$$-\nabla^2\mathbf E=\omega^2\mu\epsilon\mathbf E.$$</div><p>因此：</p><div class="mathjax-block">$$\nabla^2\mathbf E+k^2\mathbf E=0$$</div><p>其中</p><div class="mathjax-block">$$k=\omega\sqrt{\mu\epsilon}=\frac{2\pi n}{\lambda_0}.$$</div><p>这就是 vector Helmholtz equation。磁场同样满足：</p><div class="mathjax-block">$$\nabla^2\mathbf H+k^2\mathbf H=0.$$</div><p>到目前为止，还没有进入 Fresnel、Fraunhofer，也没有做 paraxial approximation。</p><hr><h3 id="第一个真正重要的近似：Vector-→-Scalar"><a href="#第一个真正重要的近似：Vector-→-Scalar" class="headerlink" title="第一个真正重要的近似：Vector → Scalar"></a>第一个真正重要的近似：Vector → Scalar</h3><p>因为介质均匀，电场的每个 Cartesian component 都满足：</p><div class="mathjax-block">$$\nabla^2 E_x+k^2E_x=0,$$</div><div class="mathjax-block">$$\nabla^2 E_y+k^2E_y=0,$$</div><div class="mathjax-block">$$\nabla^2 E_z+k^2E_z=0.$$</div><p>于是我们把其中一个分量抽象为 $U(x,y,z)$，得到 scalar Helmholtz equation：</p><div class="mathjax-block">$$\nabla^2 U+k^2U=0.$$</div><p>但是这里要区分两个概念。</p><p>在均匀介质内部，“每个场分量满足 Helmholtz equation”本身并不是近似。真正的 scalar approximation 是：</p><blockquote><p>我们不再同时求解完整的 $\mathbf E,\mathbf H$，而只用一个 scalar complex field $U$ 描述传播。</p></blockquote><p>这样做意味着忽略或者弱化：</p><div class="mathjax-block">$$\text{polarization coupling},$$</div><div class="mathjax-block">$$E_z,$$</div><p>以及复杂边界引起的 vector effects。</p><p>因此 scalar diffraction 通常适用于：</p><div class="mathjax-block">$$\text{feature size}\gg\lambda,$$</div><p>并且不是极高 NA、强聚焦、亚波长结构、复杂介质界面的问题。</p><p>如果研究</p><div class="mathjax-block">$$\text{high-NA focusing},$$</div><div class="mathjax-block">$$\text{nanophotonics},$$</div><div class="mathjax-block">$$\text{metasurfaces},$$</div><div class="mathjax-block">$$\text{subwavelength structures},$$</div><p>通常就不能只靠 scalar propagation，而需要 FDTD、FEM、RCWA、vector Debye integral 等 Maxwell solver。</p><p>所以 Propagation Family 的第一条边界是：</p><div class="mathjax-block">$$\text{Maxwell} \xrightarrow{\text{scalar approximation}} \text{Scalar Helmholtz}$$</div><p>后面的 RS、ASM、Fresnel、Fraunhofer 全都在这条边界之后。</p><hr><h2 id="二、Scalar-Helmholtz-的两种等价传播表述"><a href="#二、Scalar-Helmholtz-的两种等价传播表述" class="headerlink" title="二、Scalar Helmholtz 的两种等价传播表述"></a>二、Scalar Helmholtz 的两种等价传播表述</h2><h3 id="Scalar-Helmholtz-怎么产生传播公式？"><a href="#Scalar-Helmholtz-怎么产生传播公式？" class="headerlink" title="Scalar Helmholtz 怎么产生传播公式？"></a>Scalar Helmholtz 怎么产生传播公式？</h3><p>现在的问题变成：已知 $U(x’,y’,0)$，怎样求 $U(x,y,z)$？</p><p>Scalar Helmholtz：</p><div class="mathjax-block">$$(\nabla^2+k^2)U=0$$</div><p>对应的自由空间 Green’s function 是：</p><div class="mathjax-block">$$G(\mathbf r)=\frac{e^{ikr}}{4\pi r}$$</div><p>因为它满足：</p><div class="mathjax-block">$$(\nabla^2+k^2)G=-\delta(\mathbf r).$$</div><p>Green’s function 可以理解成：</p><blockquote><p>一个点源产生什么场。</p></blockquote><p>所以只要知道边界面上的场，就可以通过 Green’s theorem，把整个传播问题写成边界积分。这一步最终得到 Rayleigh–Sommerfeld diffraction integral。</p><hr><h3 id="Rayleigh–Sommerfeld：空间域中的-scalar-propagation"><a href="#Rayleigh–Sommerfeld：空间域中的-scalar-propagation" class="headerlink" title="Rayleigh–Sommerfeld：空间域中的 scalar propagation"></a>Rayleigh–Sommerfeld：空间域中的 scalar propagation</h3><p>设：</p><div class="mathjax-block">$$r=\sqrt{(x-x')^2+(y-y')^2+z^2}.$$</div><p>Rayleigh–Sommerfeld 第一类衍射积分可以写成：</p><div class="mathjax-block">$$U(x,y,z)=\iint U(x',y',0)\,h_{\rm RS}(x-x',y-y',z)\,dx'dy',$$</div><p>其中：</p><div class="mathjax-block">$$h_{\rm RS}= \frac{1}{2\pi} \frac{e^{ikr}}{r} \frac{z}{r} \left(\frac{1}{r}-ik\right)$$</div><p>也可以理解成 Green’s function 对传播方向法向量的导数。</p><p>这里最重要的是：</p><div class="mathjax-block">$$r=\sqrt{z^2+\Delta x^2+\Delta y^2}$$</div><p>被完整保留下来了。没有做：</p><div class="mathjax-block">$$r\approx z+\frac{\Delta x^2+\Delta y^2}{2z}.$$</div><p>因此 RS 并不是 paraxial diffraction formula。只要 scalar Helmholtz model 本身成立，RS 能够处理相对大的传播角度。</p><p>所以：</p><div class="mathjax-block">$$\text{RS 不要求 Fresnel 的近轴条件}$$</div><p>但它仍然不是 Maxwell-exact。它的物理边界仍然是：</p><div class="mathjax-block">$$\text{scalar diffraction}$$</div><p>而不是 vector electromagnetic propagation。</p><hr><h2 id="三、Angular-Spectrum：频域中的-Scalar-Helmholtz-解"><a href="#三、Angular-Spectrum：频域中的-Scalar-Helmholtz-解" class="headerlink" title="三、Angular Spectrum：频域中的 Scalar Helmholtz 解"></a>三、Angular Spectrum：频域中的 Scalar Helmholtz 解</h2><h3 id="Angular-Spectrum：从另一个方向直接解-Helmholtz"><a href="#Angular-Spectrum：从另一个方向直接解-Helmholtz" class="headerlink" title="Angular Spectrum：从另一个方向直接解 Helmholtz"></a>Angular Spectrum：从另一个方向直接解 Helmholtz</h3><p>现在回到：</p><div class="mathjax-block">$$\nabla^2U+k^2U=0.$$</div><p>不要用 Green’s function，而是在 transverse plane 对 $x,y$ 做 Fourier transform：</p><div class="mathjax-block">$$U(x,y,z)\leftrightarrow\tilde U(k_x,k_y,z).$$</div><p>因为：</p><div class="mathjax-block">$$\frac{\partial^2}{\partial x^2}\rightarrow-k_x^2,$$</div><div class="mathjax-block">$$\frac{\partial^2}{\partial y^2}\rightarrow-k_y^2,$$</div><p>Helmholtz equation 变成：</p><div class="mathjax-block">$$\frac{\partial^2\tilde U}{\partial z^2}+(k^2-k_x^2-k_y^2)\tilde U=0.$$</div><p>定义：</p><div class="mathjax-block">$$k_z=\sqrt{k^2-k_x^2-k_y^2}$$</div><p>向 $+z$ 传播的解为：</p><div class="mathjax-block">$$\tilde U(k_x,k_y,z)=\tilde U(k_x,k_y,0)e^{ik_zz}.$$</div><p>因此：</p><div class="mathjax-block">$$U(x,y,z)= \mathcal F^{-1} \left[ \mathcal F\{U_0\} e^{iz\sqrt{k^2-k_x^2-k_y^2}} \right].$$</div><p>这就是 Angular Spectrum Method。</p><hr><h3 id="ASM-还能自然看到-evanescent-waves"><a href="#ASM-还能自然看到-evanescent-waves" class="headerlink" title="ASM 还能自然看到 evanescent waves"></a>ASM 还能自然看到 evanescent waves</h3><p>如果：</p><div class="mathjax-block">$$k_x^2+k_y^2&lt;k^2,$$</div><p>那么 $k_z\in\mathbb R$，对应 propagating plane wave：</p><div class="mathjax-block">$$e^{ik_zz}.$$</div><p>如果：</p><div class="mathjax-block">$$k_x^2+k_y^2&gt;k^2,$$</div><p>则：</p><div class="mathjax-block">$$k_z=i\alpha.$$</div><p>传播项变成：</p><div class="mathjax-block">$$e^{-\alpha z}.$$</div><p>这就是 evanescent wave。因此 ASM 比 Fresnel 更清楚地暴露了：</p><div class="mathjax-block">$$\text{propagating spectrum} + \text{evanescent spectrum}$$</div><p>的结构。</p><p>不过对于普通毫米&#x2F;厘米尺度自由空间光学，evanescent components 通常传播很短距离就衰减掉。</p><hr><h3 id="RS-和-ASM-为什么其实是同一个物理模型？"><a href="#RS-和-ASM-为什么其实是同一个物理模型？" class="headerlink" title="RS 和 ASM 为什么其实是同一个物理模型？"></a>RS 和 ASM 为什么其实是同一个物理模型？</h3><p>RS：</p><div class="mathjax-block">$$U_z=U_0*h_{\rm RS}$$</div><p>是 spatial-domain representation。</p><p>ASM：</p><div class="mathjax-block">$$\tilde U_z=\tilde U_0H_{\rm ASM}$$</div><p>是 spatial-frequency representation。</p><p>二者本质上都是 scalar Helmholtz equation + outgoing-wave boundary condition 的解。因此可以理解为：</p><div class="mathjax-block">$$\text{RS}\overset{\mathcal F}{\Longleftrightarrow}\text{ASM}$$</div><p>一个是 Green-function &#x2F; impulse-response view，一个是 plane-wave &#x2F; transfer-function view。</p><p>所以在连续理论、正确边界条件和充分数值精度下：</p><div class="mathjax-block">$$U_{\rm RS}=U_{\rm ASM}.$$</div><p>如果程序结果差很多，通常应该先怀疑 sampling，而不是怀疑两种物理理论冲突。</p><hr><h2 id="四、统一传输函数模型：空域卷积与频域乘积"><a href="#四、统一传输函数模型：空域卷积与频域乘积" class="headerlink" title="四、统一传输函数模型：空域卷积与频域乘积"></a>四、统一传输函数模型：空域卷积与频域乘积</h2><p>RS 与 ASM 分别给出了 scalar Helmholtz 传播的空域和频域表述。现在可以把两者放入同一个线性平移不变系统框架：传播形式本身是统一的，模型之间真正变化的是传播核或传输函数。</p><h3 id="空域中的传播核"><a href="#空域中的传播核" class="headerlink" title="空域中的传播核"></a>空域中的传播核</h3><p>若点 $(x’,y’)$ 对输出点 $(x,y)$ 的影响只取决于坐标差，则传播可写成：</p><div class="mathjax-block">$$U_z=U_0*h_z$$</div><p>即：</p><div class="mathjax-block">$$U(x,y,z)=\iint U_0(x',y')h_z(x-x',y-y')dx'dy'.$$</div><p>其中 $h_z$ 是传播系统的 impulse response。对于 Rayleigh–Sommerfeld，传播核就是前面得到的 $h_{\rm RS}$。</p><h3 id="傅里叶域中的传输函数"><a href="#傅里叶域中的传输函数" class="headerlink" title="傅里叶域中的传输函数"></a>傅里叶域中的传输函数</h3><p>根据 convolution theorem：</p><div class="mathjax-block">$$\mathcal F\{U_0*h_z\}=\mathcal F\{U_0\}\mathcal F\{h_z\}.$$</div><p>定义传输函数：</p><div class="mathjax-block">$$H_z=\mathcal F\{h_z\},$$</div><p>传播便可以写成：</p><div class="mathjax-block">$$\tilde U_z=\tilde U_0H_z,$$</div><p>以及：</p><div class="mathjax-block">$$U_z=\mathcal F^{-1}\left[\mathcal F\{U_0\}H_z\right].$$</div><p>所以同一个传播过程具有两种等价表述：</p><div class="mathjax-block">$$\text{空域卷积}\quad\Longleftrightarrow\quad\text{傅里叶域乘积}.$$</div><p>RS 的 $h_{\rm RS}$ 与 ASM 的</p><div class="mathjax-block">$$H_{\rm ASM}=\exp\left[iz\sqrt{k^2-k_x^2-k_y^2}\right]$$</div><p>互为 Fourier transform。RS 和 ASM 因而不是两套冲突的理论，而是同一个 scalar Helmholtz 传播模型的空域与频域表示。</p><h3 id="Direct-Integration：直接计算空域卷积"><a href="#Direct-Integration：直接计算空域卷积" class="headerlink" title="Direct Integration：直接计算空域卷积"></a>Direct Integration：直接计算空域卷积</h3><p>将 RS 的连续卷积离散化：</p><div class="mathjax-block">$$U[m,n]\approx\sum_{p,q}U_0[p,q]h_{\rm RS}(x_m-x_p,y_n-y_q)\Delta x\Delta y$$</div><p>就得到 Direct Integration。它没有增加新的物理近似，只是在对 RS integral 做 numerical quadrature。</p><p>对于 $N\times N$ 的输入和输出，每个 $N^2$ 输出点都要累加 $N^2$ 个输入点，因此计算量约为：</p><div class="mathjax-block">$$O(N^4).$$</div><p>DI 很慢，但没有 FFT 自带的 periodicity、circular convolution 和 frequency-grid mapping 问题，因此通常适合作为 numerical reference。</p><h3 id="FFT-DI：在频域计算同一个-RS-卷积"><a href="#FFT-DI：在频域计算同一个-RS-卷积" class="headerlink" title="FFT-DI：在频域计算同一个 RS 卷积"></a>FFT-DI：在频域计算同一个 RS 卷积</h3><p>对 RS kernel 使用 convolution theorem：</p><div class="mathjax-block">$$U_z=\mathcal F^{-1}\left[\mathcal F(U_0)\mathcal F(h_{\rm RS})\right]$$</div><p>就得到 FFT-DI，计算量降低为：</p><div class="mathjax-block">$$O(N^2\log N).$$</div><p>因此 DI 和 FFT-DI 不是前后递进的物理近似，而是同一个 Rayleigh–Sommerfeld 模型的两种计算方法：</p><div class="mathjax-block">$$\text{Rayleigh–Sommerfeld} \longrightarrow \begin{cases} \text{DI：空域直接积分}\\ \text{FFT-DI：频域快速卷积} \end{cases}$$</div><h3 id="FFT-DI-引入的是数值假设，不是物理假设"><a href="#FFT-DI-引入的是数值假设，不是物理假设" class="headerlink" title="FFT-DI 引入的是数值假设，不是物理假设"></a>FFT-DI 引入的是数值假设，不是物理假设</h3><p>DFT 隐含周期边界：</p><div class="mathjax-block">$$u[n+N]=u[n].$$</div><p>因此直接计算：</p><div class="mathjax-block">$$IFFT\{FFT(U)FFT(h)\}$$</div><p>得到的是 circular convolution，而物理上的 RS 是 linear convolution。为了避免 wrap-around，必须进行 zero padding，典型条件为：</p><div class="mathjax-block">$$N_{\rm FFT}\ge N_U+N_h-1.$$</div><p>所以 FFT-DI 的误差边界来自 sampling、finite window、zero padding 和 quadrature，而不是新的 diffraction approximation。</p><hr><h2 id="五、Fresnel：从空域和频域引入近轴近似"><a href="#五、Fresnel：从空域和频域引入近轴近似" class="headerlink" title="五、Fresnel：从空域和频域引入近轴近似"></a>五、Fresnel：从空域和频域引入近轴近似</h2><h3 id="频域推导：近似-ASM-的传输函数"><a href="#频域推导：近似-ASM-的传输函数" class="headerlink" title="频域推导：近似 ASM 的传输函数"></a>频域推导：近似 ASM 的传输函数</h3><p>现在从 ASM 开始最清楚。</p><p>ASM：</p><div class="mathjax-block">$$k_z=\sqrt{k^2-k_x^2-k_y^2}.$$</div><p>提取 $k$：</p><div class="mathjax-block">$$k_z=k\sqrt{1-\frac{k_x^2+k_y^2}{k^2}}.$$</div><p>如果：</p><div class="mathjax-block">$$k_x^2+k_y^2\ll k^2$$</div><p>利用：</p><div class="mathjax-block">$$\sqrt{1-\epsilon}\approx1-\frac{\epsilon}{2},$$</div><p>得到：</p><div class="mathjax-block">$$k_z\approx k-\frac{k_x^2+k_y^2}{2k}.$$</div><p>因此 propagation transfer function $e^{ik_zz}$ 变成：</p><div class="mathjax-block">$$H_F=e^{ikz}\exp\left[-i\frac{z}{2k}(k_x^2+k_y^2)\right].$$</div><p>这就是 Fresnel propagation。</p><p>所以 Fresnel approximation 真正表达的是：</p><div class="mathjax-block">$$k_\perp\ll k$$</div><p>也就是：</p><div class="mathjax-block">$$\sin\theta\ll1.$$</div><p>这就是 paraxial approximation。</p><hr><h3 id="空域推导：近似-RS-的传播距离"><a href="#空域推导：近似-RS-的传播距离" class="headerlink" title="空域推导：近似 RS 的传播距离"></a>空域推导：近似 RS 的传播距离</h3><p>RS 中：</p><div class="mathjax-block">$$r=\sqrt{z^2+\rho^2},$$</div><p>其中：</p><div class="mathjax-block">$$\rho^2=(x-x')^2+(y-y')^2.$$</div><p>写成：</p><div class="mathjax-block">$$r=z\sqrt{1+\frac{\rho^2}{z^2}}.$$</div><p>展开：</p><div class="mathjax-block">$$r=z+\frac{\rho^2}{2z}-\frac{\rho^4}{8z^3}+\cdots$$</div><p>Fresnel 只保留：</p><div class="mathjax-block">$$r\approx z+\frac{\rho^2}{2z}.$$</div><p>但是传播相位是 $kr$。所以真正判断误差大小的不是单纯 $\rho\ll z$，而是被丢掉的相位：</p><div class="mathjax-block">$$\Delta\phi\approx\frac{k\rho^4}{8z^3}.$$</div><p>需要：</p><div class="mathjax-block">$$\frac{k\rho_{\max}^4}{8z^3}\ll1.$$</div><p>这个条件比一句“$z$ 足够远”更准确。</p><hr><h3 id="Fresnel-的空域卷积形式"><a href="#Fresnel-的空域卷积形式" class="headerlink" title="Fresnel 的空域卷积形式"></a>Fresnel 的空域卷积形式</h3><p>经过这个近似：</p><div class="mathjax-block">$$r\approx z+\frac{x^2+y^2}{2z}.$$</div><p>同时 amplitude slowly varying：</p><div class="mathjax-block">$$\frac{1}{r}\approx\frac{1}{z},$$</div><p>以及：</p><div class="mathjax-block">$$\frac{z}{r}\approx1.$$</div><p>于是 RS kernel 简化成：</p><div class="mathjax-block">$$h_F(x,y,z)= \frac{e^{ikz}}{i\lambda z} \exp\left[i\frac{k}{2z}(x^2+y^2)\right].$$</div><p>因此：</p><div class="mathjax-block">$$U_z=U_0*h_F.$$</div><p>这是 Fresnel diffraction 的 convolution form。</p><hr><h3 id="Fresnel-并不等于“近场”"><a href="#Fresnel-并不等于“近场”" class="headerlink" title="Fresnel 并不等于“近场”"></a>Fresnel 并不等于“近场”</h3><p>这也是一个很常见的误解。</p><p>Fresnel 的真正条件是：</p><div class="mathjax-block">$$\text{paraxial}$$</div><p>而不是简单 $z$ 小。</p><p>一个系统即使传播距离很长，如果角度仍然很小，Fresnel 仍然可以非常准确。相反，如果存在大角度、高空间频率，即使距离不算特别短，$k_\perp&#x2F;k$ 比较大，Fresnel 也可能失效。</p><p>所以更合理的理解是：</p><div class="mathjax-block">$$\text{ASM/RS}\xrightarrow{\text{small angle}}\text{Fresnel}.$$</div><hr><h2 id="六、Fraunhofer：从空域和频域走向远场"><a href="#六、Fraunhofer：从空域和频域走向远场" class="headerlink" title="六、Fraunhofer：从空域和频域走向远场"></a>六、Fraunhofer：从空域和频域走向远场</h2><h3 id="空域推导：忽略输入面的二次相位"><a href="#空域推导：忽略输入面的二次相位" class="headerlink" title="空域推导：忽略输入面的二次相位"></a>空域推导：忽略输入面的二次相位</h3><p>Fresnel integral 可以写成：</p><div class="mathjax-block">$$U(x,y,z)= \frac{e^{ikz}}{i\lambda z} e^{i\frac{k}{2z}(x^2+y^2)}$$</div><div class="mathjax-block">$$\times \iint U_0(x',y') e^{i\frac{k}{2z}(x'^2+y'^2)} e^{-i\frac{2\pi}{\lambda z}(xx'+yy')} dx'dy'.$$</div><p>Fraunhofer approximation 再进一步认为，在整个输入 aperture 上：</p><div class="mathjax-block">$$e^{i\frac{k}{2z}(x'^2+y'^2)}\approx1.$$</div><p>假设 aperture 最大半径为 $a$，则最大附加相位：</p><div class="mathjax-block">$$\Delta\phi_{\rm aperture}\approx\frac{ka^2}{2z}.$$</div><p>要求：</p><div class="mathjax-block">$$\frac{ka^2}{2z}\ll1.$$</div><p>代入：</p><div class="mathjax-block">$$k=\frac{2\pi}{\lambda},$$</div><p>得到：</p><div class="mathjax-block">$$z\gg\frac{\pi a^2}{\lambda}.$$</div><p>不同教材根据允许的 phase error，会给出略有不同的常数，因此工程中经常简写成：</p><div class="mathjax-block">$$z\gg\frac{a^2}{\lambda}.$$</div><hr><h3 id="频域结果：远场是输入场的-Fourier-transform"><a href="#频域结果：远场是输入场的-Fourier-transform" class="headerlink" title="频域结果：远场是输入场的 Fourier transform"></a>频域结果：远场是输入场的 Fourier transform</h3><p>去掉输入 quadratic phase：</p><div class="mathjax-block">$$U(x,y,z)\approx \frac{e^{ikz}}{i\lambda z} e^{i\frac{k}{2z}(x^2+y^2)}$$</div><div class="mathjax-block">$$\times \iint U_0(x',y')e^{-i2\pi(f_xx'+f_yy')}dx'dy',$$</div><p>其中：</p><div class="mathjax-block">$$f_x=\frac{x}{\lambda z},\qquad f_y=\frac{y}{\lambda z}.$$</div><p>因此：</p><div class="mathjax-block">$$U(x,y,z)\propto \mathcal F\{U_0\} \left(\frac{x}{\lambda z},\frac{y}{\lambda z}\right).$$</div><p>所以 Fraunhofer pattern 就是 aperture 的 Fourier transform。</p><hr><h3 id="Lens：在有限距离实现-Fourier-transform"><a href="#Lens：在有限距离实现-Fourier-transform" class="headerlink" title="Lens：在有限距离实现 Fourier transform"></a>Lens：在有限距离实现 Fourier transform</h3><p>Fraunhofer condition：</p><div class="mathjax-block">$$z\gg\frac{a^2}{\lambda}$$</div><p>针对的是：</p><div class="mathjax-block">$$\text{free-space propagation}.$$</div><p>如果加入 thin lens：</p><div class="mathjax-block">$$t_L(x,y)=\exp\left[-i\frac{k}{2f}(x^2+y^2)\right],$$</div><p>lens 的 quadratic phase 可以和传播中的 quadratic phase 抵消。结果是在后焦面 $z&#x3D;f$ 直接得到输入场的 Fourier transform。</p><p>因此实验室里不需要真的传播几十米甚至几百米才能观察 far-field diffraction。Lens 实际上实现了：</p><div class="mathjax-block">$$\text{finite-distance Fourier transform}.$$</div><hr><h2 id="七、总结：模型谱系、适用边界与选择方法"><a href="#七、总结：模型谱系、适用边界与选择方法" class="headerlink" title="七、总结：模型谱系、适用边界与选择方法"></a>七、总结：模型谱系、适用边界与选择方法</h2><h3 id="最终-Propagation-Family"><a href="#最终-Propagation-Family" class="headerlink" title="最终 Propagation Family"></a>最终 Propagation Family</h3><p>现在可以把整个关系重新画成：</p><div class="mathjax-block">$$\text{Maxwell Equations}$$</div><div class="mathjax-block">$$\downarrow$$</div><p>均匀、线性、各向同性、无源、单色场</p><div class="mathjax-block">$$\text{Vector Helmholtz}$$</div><div class="mathjax-block">$$\downarrow\quad\text{scalar approximation}$$</div><div class="mathjax-block">$$\text{Scalar Helmholtz}$$</div><p>从这里分成两个等价表示：</p><div class="mathjax-block">$$\begin{array}{ccc}\text{Spatial domain} &amp;&amp; \text{Spatial-frequency domain}\\[4pt]\downarrow &amp;&amp; \downarrow\\\text{Rayleigh-Sommerfeld} &amp;&amp; \text{Angular Spectrum}\\\downarrow &amp;&amp;\\\text{DI / FFT\text{-}DI} &amp;&amp;\end{array}$$</div><p>然后施加：</p><div class="mathjax-block">$$k_\perp\ll k$$</div><p>得到：</p><div class="mathjax-block">$$\text{Fresnel}$$</div><p>数值实现可以有：</p><div class="mathjax-block">$$\text{one-step},\quad\text{two-step},\quad\text{multi-step},\quad\text{shifted Fresnel}.$$</div><p>继续增加 far-field 条件：</p><div class="mathjax-block">$$\frac{ka^2}{2z}\ll1$$</div><p>得到：</p><div class="mathjax-block">$$\text{Fraunhofer}.$$</div><hr><h3 id="各模型的“前提—丢失信息—失效边界”"><a href="#各模型的“前提—丢失信息—失效边界”" class="headerlink" title="各模型的“前提—丢失信息—失效边界”"></a>各模型的“前提—丢失信息—失效边界”</h3><table><thead><tr><th>模型</th><th>核心方程</th><th>新增假设</th><th>主要失效场景</th></tr></thead><tbody><tr><td>Maxwell</td><td>$\nabla\times E,\nabla\times H$</td><td>基本电磁理论</td><td>通常作为最完整模型</td></tr><tr><td>Vector Helmholtz</td><td>$\nabla^2\mathbf E+k^2\mathbf E&#x3D;0$</td><td>单色、均匀、线性、各向同性、无源区域</td><td>强非均匀介质等</td></tr><tr><td>Scalar Helmholtz</td><td>$\nabla^2U+k^2U&#x3D;0$</td><td>忽略显著 vector&#x2F;polarization coupling</td><td>高 NA、亚波长、纳米光学</td></tr><tr><td>RS</td><td>Green-function integral</td><td>scalar Helmholtz</td><td>同 scalar approximation</td></tr><tr><td>ASM</td><td>$H&#x3D;e^{ik_zz}$</td><td>scalar Helmholtz</td><td>物理上同 RS；数值上易受 sampling 影响</td></tr><tr><td>Fresnel</td><td>$k_z\approx k-k_\perp^2&#x2F;2k$</td><td>paraxial</td><td>large angle &#x2F; high spatial frequency</td></tr><tr><td>Fraunhofer</td><td>$U\propto\mathcal F(U_0)$</td><td>Fresnel + far field</td><td>Fresnel&#x2F;near-field diffraction</td></tr><tr><td>Shifted Fresnel</td><td>scaled Fresnel FFT</td><td>与 Fresnel 相同</td><td>无法解决 non-paraxial propagation</td></tr><tr><td>DI</td><td>离散 RS integral</td><td>数值 quadrature</td><td>计算量巨大</td></tr><tr><td>FFT-DI</td><td>FFT convolution</td><td>DFT sampling&#x2F;padding</td><td>aliasing、wrap-around、有限窗口</td></tr></tbody></table><hr><h3 id="最重要的一条判断链"><a href="#最重要的一条判断链" class="headerlink" title="最重要的一条判断链"></a>最重要的一条判断链</h3><p>以后遇到任何 propagation 问题，不应该第一反应问：</p><blockquote><p>“用 ASM 还是 Fresnel？”</p></blockquote><p>更合理的是先判断你在哪一层。</p><p>如果 polarization、high NA、subwavelength structure 已经重要：</p><div class="mathjax-block">$$\text{Scalar model 本身就不成立}$$</div><p>应该回 Maxwell solver。</p><p>如果 scalar optics 成立，但存在明显大角度传播：</p><div class="mathjax-block">$$\text{RS / ASM}$$</div><p>更适合。</p><p>如果：</p><div class="mathjax-block">$$k_\perp\ll k,$$</div><p>也就是传播主要沿 optical axis：</p><div class="mathjax-block">$$\text{Fresnel}$$</div><p>可以成立。</p><p>如果进一步：</p><div class="mathjax-block">$$\frac{ka^2}{2z}\ll1,$$</div><p>则：</p><div class="mathjax-block">$$\text{Fraunhofer}.$$</div><p>而 DI、FFT-DI、Shifted Fresnel、one-step Fresnel 这些问题，已经不是新的物理层级，而是在确定物理模型之后：</p><div class="mathjax-block">$$\text{How do we compute it numerically?}$$</div><p>这也是 <code>waveprop</code> 后面真正开始变得有价值的地方：从这里开始，问题不再是“公式会不会”，而是如何保证离散计算真的逼近上面的连续物理模型。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/09/10/2026-09-11-Propagation-Family%EF%BC%9A%E4%BB%8E-Maxwell-%E6%96%B9%E7%A8%8B%E5%88%B0-RS%E3%80%81ASM%E3%80%81Fresnel-%E4%B8%8E-Fraunhofer/</id>
    <link href="https://believed-breadfruit.top/2026/09/10/2026-09-11-Propagation-Family%EF%BC%9A%E4%BB%8E-Maxwell-%E6%96%B9%E7%A8%8B%E5%88%B0-RS%E3%80%81ASM%E3%80%81Fresnel-%E4%B8%8E-Fraunhofer/"/>
    <published>2026-09-10T16:00:00.000Z</published>
    <summary>梳理自由空间衍射传播模型从 Maxwell 方程到 RS、ASM、Fresnel 与 Fraunhofer 的谱系、近似边界与数值实现。</summary>
    <title>Propagation Family：从 Maxwell 方程到 RS、ASM、Fresnel 与 Fraunhofer</title>
    <updated>2026-09-10T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="Today I Learn" scheme="https://believed-breadfruit.top/categories/Today-I-Learn/"/>
    <category term="技术" scheme="https://believed-breadfruit.top/tags/%E6%8A%80%E6%9C%AF/"/>
    <category term="JavaScript" scheme="https://believed-breadfruit.top/tags/JavaScript/"/>
    <category term="前端" scheme="https://believed-breadfruit.top/tags/%E5%89%8D%E7%AB%AF/"/>
    <content>
      <![CDATA[<p><strong>源码</strong><br>完整 Demo 已整理为可直接<a href="https://github.com/janice143/sprite-motion-lab">上传 GitHub 的项目</a>，包含 <code>index.html</code>、24 帧 <code>dog-sprite.svg</code> 和 <code>README.md</code>。</p><p>最近看到一种挺有意思的<a href="https://oiloil.org/">前端交互</a>：页面中放着一只小狗，当鼠标绕着它移动时，小狗的脑袋也会跟着鼠标方向旋转。</p><p>实现这种效果不一定需要 WebGL，也不需要实时做 3D 渲染。一个非常简单的方法，就是提前准备一张包含多个旋转状态的雪碧图（Sprite Sheet），然后根据鼠标的位置选择应该显示哪一帧。</p><p>整个问题可以抽象成一个很简单的数学模型：</p><div class="mathjax-block">$$(x,y)\rightarrow\theta\rightarrowframe\rightarrowbackground-position$$</div><p>也就是：</p><p><strong>鼠标二维坐标 → 方向角 → 雪碧图帧编号 → CSS 背景位置。</strong></p><h2 id="1-先建立坐标模型"><a href="#1-先建立坐标模型" class="headerlink" title="1. 先建立坐标模型"></a>1. 先建立坐标模型</h2><p>假设小狗图片中心的位置为</p><div class="mathjax-block">$$C=(x_c,y_c)$$</div><p>鼠标当前位置为</p><div class="mathjax-block">$$M=(x_m,y_m)$$</div><p>那么从小狗中心指向鼠标的向量就是：</p><div class="mathjax-block">$$\vec{r}=M-C=(x_m-x_c,\;y_m-y_c)$$</div><p>记作：</p><div class="mathjax-block">$$dx=x_m-x_c$$</div><div class="mathjax-block">$$dy=y_m-y_c$$</div><p>在浏览器里，这几个值都可以直接获得。</p><figure class="highlight js"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">const</span> rect = dog.<span class="title function_">getBoundingClientRect</span>();</span><br><span class="line"></span><br><span class="line"><span class="keyword">const</span> centerX = rect.<span class="property">left</span> + rect.<span class="property">width</span> / <span class="number">2</span>;</span><br><span class="line"><span class="keyword">const</span> centerY = rect.<span class="property">top</span> + rect.<span class="property">height</span> / <span class="number">2</span>;</span><br><span class="line"></span><br><span class="line"><span class="keyword">const</span> dx = event.<span class="property">clientX</span> - centerX;</span><br><span class="line"><span class="keyword">const</span> dy = event.<span class="property">clientY</span> - centerY;</span><br></pre></td></tr></table></figure><p>现在问题就从”鼠标在哪里”变成了：</p><blockquote><p>鼠标相对于小狗中心处于什么方向？</p></blockquote><hr><h2 id="2-从二维坐标计算方向角"><a href="#2-从二维坐标计算方向角" class="headerlink" title="2. 从二维坐标计算方向角"></a>2. 从二维坐标计算方向角</h2><p>已知向量</p><div class="mathjax-block">$$(dx,dy)$$</div><p>就可以通过 <code>atan2</code> 得到方向角：</p><div class="mathjax-block">$$\theta=\operatorname{atan2}(dy,dx)$$</div><p>对应 JavaScript：</p><figure class="highlight js"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">let</span> angle = <span class="title class_">Math</span>.<span class="title function_">atan2</span>(dy, dx);</span><br></pre></td></tr></table></figure><p>为什么不用</p><div class="mathjax-block">$$\arctan\frac{dy}{dx}$$</div><p>而使用 <code>atan2(dy, dx)</code>？</p><p>因为只计算</p><div class="mathjax-block">$$dy/dx$$</div><p>无法唯一判断向量位于哪个象限，而 <code>atan2</code> 同时使用 <code>dx</code> 和 <code>dy</code>，可以得到完整的方向信息。</p><p>它返回：</p><div class="mathjax-block">$$-\pi \leq \theta \leq \pi$$</div><p>为了方便后面映射动画帧，可以统一转换到：</p><div class="mathjax-block">$$0\leq\theta&lt;2\pi$$</div><figure class="highlight js"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">if</span> (angle &lt; <span class="number">0</span>) &#123;</span><br><span class="line">  angle += <span class="title class_">Math</span>.<span class="property">PI</span> * <span class="number">2</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>于是鼠标绕小狗转一圈时：</p><div class="mathjax-block">$$\theta:0\rightarrow2\pi$$</div><p>也就是：</p><div class="mathjax-block">$$0^\circ\rightarrow360^\circ$$</div><p>这里还要注意浏览器坐标系与传统数学坐标系不同：浏览器的 Y 轴是向下增长的，因此视觉上的旋转方向与标准笛卡尔坐标系会有所不同。不过这不会影响整个映射模型。</p><hr><h2 id="3-把连续角度映射成离散动画帧"><a href="#3-把连续角度映射成离散动画帧" class="headerlink" title="3. 把连续角度映射成离散动画帧"></a>3. 把连续角度映射成离散动画帧</h2><p>假设设计师已经制作好了 24 帧小狗旋转动画。</p><p>整张雪碧图可以理解成：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">frame0 | frame1 | frame2 | ... | frame23</span><br></pre></td></tr></table></figure><p>一圈对应：</p><div class="mathjax-block">$$2\pi$$</div><p>总帧数：</p><div class="mathjax-block">$$N=24$$</div><p>因此每一帧覆盖的角度范围约为：</p><div class="mathjax-block">$$\Delta\theta=\frac{2\pi}{N}$$</div><p>对于 24 帧：</p><div class="mathjax-block">$$\Delta\theta=\frac{360^\circ}{24}=15^\circ$$</div><p>于是当前方向对应的帧编号就是：</p><div class="mathjax-block">$$frame=\left\lfloor\frac{\theta}{2\pi}N\right\rfloor$$</div><p>代码非常简单：</p><figure class="highlight js"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">const</span> <span class="variable constant_">FRAME_COUNT</span> = <span class="number">24</span>;</span><br><span class="line"></span><br><span class="line"><span class="keyword">const</span> frame = <span class="title class_">Math</span>.<span class="title function_">floor</span>(</span><br><span class="line">  angle / (<span class="title class_">Math</span>.<span class="property">PI</span> * <span class="number">2</span>) * <span class="variable constant_">FRAME_COUNT</span></span><br><span class="line">);</span><br></pre></td></tr></table></figure><p>例如：</p><p>鼠标角度为 (0^\circ)，得到 frame 0。</p><p>鼠标角度约为 (90^\circ)，得到 frame 6。</p><p>鼠标角度约为 (180^\circ)，得到 frame 12。</p><p>鼠标角度约为 (270^\circ)，得到 frame 18。</p><p>所以这里真正发生的是一次连续量到离散量的量化：</p><div class="mathjax-block">$$\theta\in[0,2\pi)$$</div><p>被离散成：</p><div class="mathjax-block">$$frame\in\{0,1,\cdots,N-1\}$$</div><hr><h2 id="4-从帧编号定位雪碧图"><a href="#4-从帧编号定位雪碧图" class="headerlink" title="4. 从帧编号定位雪碧图"></a>4. 从帧编号定位雪碧图</h2><p>假设每一帧宽度都是：</p><div class="mathjax-block">$$W=140px$$</div><p>如果想显示第 (n) 帧，只需要让背景图向左移动：</p><div class="mathjax-block">$$x_{background}=-nW$$</div><p>因此：</p><figure class="highlight js"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">const</span> bgX = -frame * <span class="variable constant_">FRAME_WIDTH</span>;</span><br><span class="line"></span><br><span class="line">dog.<span class="property">style</span>.<span class="property">backgroundPosition</span> =</span><br><span class="line">  <span class="string">`<span class="subst">$&#123;bgX&#125;</span>px 0px`</span>;</span><br></pre></td></tr></table></figure><p>例如每帧宽 140 px：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">frame 0 →   0px</span><br><span class="line">frame 1 → -140px</span><br><span class="line">frame 2 → -280px</span><br><span class="line">frame 3 → -420px</span><br><span class="line">...</span><br></pre></td></tr></table></figure><p>而 DOM 元素本身始终只有一帧大小：</p><figure class="highlight css"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="selector-class">.dog</span> &#123;</span><br><span class="line">  <span class="attribute">width</span>: <span class="number">140px</span>;</span><br><span class="line">  <span class="attribute">height</span>: <span class="number">140px</span>;</span><br><span class="line"></span><br><span class="line">  <span class="attribute">background-image</span>: <span class="built_in">url</span>(<span class="string">&quot;./dog-sprite.svg&quot;</span>);</span><br><span class="line">  <span class="attribute">background-repeat</span>: no-repeat;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>所以用户看到的始终只是整张雪碧图中的一个窗口。</p><p>这实际上就是一个非常简单的离散采样过程。</p><hr><h2 id="5-完整核心代码"><a href="#5-完整核心代码" class="headerlink" title="5. 完整核心代码"></a>5. 完整核心代码</h2><p>把前面的模型组合起来，核心逻辑其实只有几十行：</p><figure class="highlight js"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">const</span> <span class="variable constant_">FRAME_COUNT</span> = <span class="number">24</span>;</span><br><span class="line"><span class="keyword">const</span> <span class="variable constant_">FRAME_WIDTH</span> = <span class="number">140</span>;</span><br><span class="line"></span><br><span class="line"><span class="keyword">const</span> dog = <span class="variable language_">document</span>.<span class="title function_">querySelector</span>(<span class="string">&quot;.dog&quot;</span>);</span><br><span class="line"></span><br><span class="line"><span class="variable language_">window</span>.<span class="title function_">addEventListener</span>(<span class="string">&quot;mousemove&quot;</span>, <span class="function">(<span class="params">event</span>) =&gt;</span> &#123;</span><br><span class="line">  <span class="keyword">const</span> rect = dog.<span class="title function_">getBoundingClientRect</span>();</span><br><span class="line"></span><br><span class="line">  <span class="comment">// 1. 小狗中心</span></span><br><span class="line">  <span class="keyword">const</span> centerX = rect.<span class="property">left</span> + rect.<span class="property">width</span> / <span class="number">2</span>;</span><br><span class="line">  <span class="keyword">const</span> centerY = rect.<span class="property">top</span> + rect.<span class="property">height</span> / <span class="number">2</span>;</span><br><span class="line"></span><br><span class="line">  <span class="comment">// 2. 鼠标相对小狗中心的向量</span></span><br><span class="line">  <span class="keyword">const</span> dx = event.<span class="property">clientX</span> - centerX;</span><br><span class="line">  <span class="keyword">const</span> dy = event.<span class="property">clientY</span> - centerY;</span><br><span class="line"></span><br><span class="line">  <span class="comment">// 3. 求方向角：-π ~ π</span></span><br><span class="line">  <span class="keyword">let</span> angle = <span class="title class_">Math</span>.<span class="title function_">atan2</span>(dy, dx);</span><br><span class="line"></span><br><span class="line">  <span class="comment">// 转换成 0 ~ 2π</span></span><br><span class="line">  <span class="keyword">if</span> (angle &lt; <span class="number">0</span>) &#123;</span><br><span class="line">    angle += <span class="title class_">Math</span>.<span class="property">PI</span> * <span class="number">2</span>;</span><br><span class="line">  &#125;</span><br><span class="line"></span><br><span class="line">  <span class="comment">// 4. 连续角度 → 离散帧</span></span><br><span class="line">  <span class="keyword">const</span> frame = <span class="title class_">Math</span>.<span class="title function_">floor</span>(</span><br><span class="line">    angle / (<span class="title class_">Math</span>.<span class="property">PI</span> * <span class="number">2</span>) * <span class="variable constant_">FRAME_COUNT</span></span><br><span class="line">  );</span><br><span class="line"></span><br><span class="line">  <span class="comment">// 5. 帧 → sprite background position</span></span><br><span class="line">  <span class="keyword">const</span> bgX = -frame * <span class="variable constant_">FRAME_WIDTH</span>;</span><br><span class="line"></span><br><span class="line">  dog.<span class="property">style</span>.<span class="property">backgroundPosition</span> =</span><br><span class="line">    <span class="string">`<span class="subst">$&#123;bgX&#125;</span>px 0px`</span>;</span><br><span class="line">&#125;);</span><br></pre></td></tr></table></figure><p>因此整个交互实际上没有真正意义上的”旋转图片”。</p><p>DOM 中的小狗一直没有发生：</p><figure class="highlight css"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="attribute">transform</span>: <span class="built_in">rotate</span>(...)</span><br></pre></td></tr></table></figure><p>真正改变的是：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">frame 3</span><br><span class="line">↓</span><br><span class="line">frame 4</span><br><span class="line">↓</span><br><span class="line">frame 5</span><br><span class="line">↓</span><br><span class="line">frame 6</span><br></pre></td></tr></table></figure><p>只是因为每一帧中的小狗姿态不同，人眼最终把这些离散图片理解成了一个连续旋转的头。</p><hr><h2 id="6-为什么这种动画会显得很自然？"><a href="#6-为什么这种动画会显得很自然？" class="headerlink" title="6. 为什么这种动画会显得很自然？"></a>6. 为什么这种动画会显得很自然？</h2><p>这里有一个比较有意思的地方。</p><p>我们实际上有两个空间。</p><p>第一个是连续的鼠标状态空间：</p><div class="mathjax-block">$$(x,y)\in\mathbb{R}^2$$</div><p>经过 <code>atan2</code> 以后变成：</p><div class="mathjax-block">$$\theta\in[0,2\pi)$$</div><p>第二个则是有限的动画状态空间：</p><div class="mathjax-block">$$F=\{0,1,\cdots,N-1\}$$</div><p>整个交互就是建立一个映射：</p><div class="mathjax-block">$$f:[0,2\pi)\rightarrow F$$</div><p>即：</p><div class="mathjax-block">$$f(\theta)=\left\lfloor\frac{\theta N}{2\pi}\right\rfloor$$</div><p>设计师负责定义每一个离散状态长什么样，程序负责根据用户输入选择正确的状态。</p><p>因此这种方法特别适合复杂插画、角色动画、产品模型、吉祥物等场景。</p><p>很多视觉上看起来很复杂的 Motion，背后的运行时逻辑反而非常简单。</p><hr><h2 id="7-更丝滑的版本：加入时间响应"><a href="#7-更丝滑的版本：加入时间响应" class="headerlink" title="7. 更丝滑的版本：加入时间响应"></a>7. 更丝滑的版本：加入时间响应</h2><p>前面的模型还有一个特点：</p><p>鼠标移动到哪里，小狗立即切换到对应帧。</p><p>数学上相当于：</p><div class="mathjax-block">$$\theta_{display}=\theta_{mouse}$$</div><p>这是一种瞬时响应。</p><p>但很多精致的 Motion Design 会故意增加一点惯性，例如：</p><div class="mathjax-block">$$\theta_{display}(t+\Delta t)=\theta_{display}(t)+\alpha[\theta_{target}-\theta_{display}(t)]$$</div><p>其中：</p><div class="mathjax-block">$$0&lt;\alpha&lt;1$$</div><p>例如：</p><figure class="highlight js"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">currentAngle +=</span><br><span class="line">  (targetAngle - currentAngle) * <span class="number">0.1</span>;</span><br></pre></td></tr></table></figure><p>然后使用 <code>requestAnimationFrame</code> 持续更新：</p><figure class="highlight js"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">function</span> <span class="title function_">animate</span>(<span class="params"></span>) &#123;</span><br><span class="line">  currentAngle +=</span><br><span class="line">    (targetAngle - currentAngle) * <span class="number">0.1</span>;</span><br><span class="line"></span><br><span class="line">  <span class="title function_">render</span>(currentAngle);</span><br><span class="line"></span><br><span class="line">  <span class="title function_">requestAnimationFrame</span>(animate);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>此时系统就从：</p><div class="mathjax-block">$$Mouse\rightarrowFrame$$</div><p>变成：</p><div class="mathjax-block">$$Mouse\rightarrowTargetAngle\rightarrowDynamicResponse\rightarrowFrame$$</div><p>鼠标突然移动时，角色不会瞬间跳过去，而是稍微滞后地跟随过去。</p><p>很多所谓”丝滑””有生命感”的 UI Motion，本质上就是在前面的几何映射外面再增加一个简单的时间响应模型。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/09/07/2026-09-07-%E5%B0%8F%E7%8B%97%E8%B7%9F%E9%9A%8F%E9%BC%A0%E6%A0%87%E6%97%8B%E8%BD%AC%EF%BC%9A%E9%9B%AA%E7%A2%A7%E5%9B%BE+%E6%95%B0%E5%AD%A6%E6%A8%A1%E5%9E%8B%E7%9A%84%E6%9E%81%E7%AE%80%E5%AE%9E%E7%8E%B0/</id>
    <link href="https://believed-breadfruit.top/2026/09/07/2026-09-07-%E5%B0%8F%E7%8B%97%E8%B7%9F%E9%9A%8F%E9%BC%A0%E6%A0%87%E6%97%8B%E8%BD%AC%EF%BC%9A%E9%9B%AA%E7%A2%A7%E5%9B%BE+%E6%95%B0%E5%AD%A6%E6%A8%A1%E5%9E%8B%E7%9A%84%E6%9E%81%E7%AE%80%E5%AE%9E%E7%8E%B0/"/>
    <published>2026-09-07T08:30:00.000Z</published>
    <summary>
      <![CDATA[<p><strong>源码</strong><br>完整 Demo 已整理为可直接<a href="https://github.com/janice143/sprite-motion-lab">上传 GitHub 的项目</a>，包含 <code>index.html</cod]]>
    </summary>
    <title>小狗跟随鼠标旋转：雪碧图+数学模型的极简实现</title>
    <updated>2026-09-07T08:30:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="随笔" scheme="https://believed-breadfruit.top/categories/%E9%9A%8F%E7%AC%94/"/>
    <category term="AI" scheme="https://believed-breadfruit.top/tags/AI/"/>
    <category term="复盘" scheme="https://believed-breadfruit.top/tags/%E5%A4%8D%E7%9B%98/"/>
    <category term="产品思考" scheme="https://believed-breadfruit.top/tags/%E4%BA%A7%E5%93%81%E6%80%9D%E8%80%83/"/>
    <content>
      <![CDATA[<p>去年发过一个小红书帖子，分享了一套极简复盘思路，有 921 个点赞，918 个收藏。</p><p>这套模板基本只记三类东西：</p><ul><li><strong>Did</strong>：今天真正做了什么；</li><li><strong>Bad</strong>：哪些地方需要修正；</li><li><strong>Thinking</strong>：今天脑子里出现了什么想法。</li></ul><p>我觉得这就是一个复盘：简单，每天只需要花几分钟，就可以慢慢形成记录和自我觉察的习惯。</p><p>最近，我把这个理念 vibe coding 成了一个微信小程序：<strong>随心迹 - 极简复盘</strong>。</p><hr><p>对于这个产品，我是这样思考的：</p><ol><li>记录是一个很有用的习惯，和吃饭、运动、接触大自然一样，可以帮助我们维持比较好的状态；</li><li>记录应该是低负担的，随手记就可以；</li><li>记录的目的不只是记录，而是让思考变成行动，行动又反过来促进思考；</li><li>AI 更像是包裹在这套系统外的一层助手。它可以整理记录、发现模式和趋势，也可以针对一个想法，给出一些微小、可行动的建议。但它不应该替人决定答案，真正的答案还是要靠行动去验证；</li><li>这套复盘背后还有一个我很认同的概念：<strong>Identity Capital</strong>，身份资本。它回答的是一个人如何慢慢形成对“我是谁”的认识，包括有形资本，比如经济资源、学历、社会关系、职业网络；也包括无形资本，比如觉察力、元认知、内控感、批判性思维等。</li></ol><p>我会觉得，这两种资本其实都需要积累，而积累的过程，就是不断思考、行动，再从行动里获得反馈。</p><hr><p>现在的随心迹还很简单，是一个低负担的记录工具。核心是 Did、Bad、Thinking，再加上每日心情打标、日历、趋势和列表，方便回头看看自己过去一段时间都记录了什么。</p><p>我真正想做的，其实不只是“记录”。因为很多东西光记录是没有用的。一个 Bad 反复出现，说明问题一直没有解决；一个 Thinking 出现了很多次，却始终没有进入 Did，那它可能永远只是停留在脑子里的想法。</p><p>所以随心迹的产品愿景，是把 Thinking、Action 和 Feedback 这套飞轮跑起来。</p><p>AI 是放大器：它可以分析、整理长期记录、发现重复和矛盾，把一个很大的想法缩小成下一步真正能做的事情。</p><p><strong>用简单的记录，过有方向的生活。</strong></p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/09/05/2026-09-06-%E9%9A%8F%E5%BF%83%E8%BF%B9%EF%BC%9A%E6%88%91%E4%B8%BA%E4%BB%80%E4%B9%88%E8%A6%81%E5%81%9A%E4%B8%80%E6%AC%BE%E5%A4%8D%E7%9B%98%E5%B0%8F%E7%A8%8B%E5%BA%8F/</id>
    <link href="https://believed-breadfruit.top/2026/09/05/2026-09-06-%E9%9A%8F%E5%BF%83%E8%BF%B9%EF%BC%9A%E6%88%91%E4%B8%BA%E4%BB%80%E4%B9%88%E8%A6%81%E5%81%9A%E4%B8%80%E6%AC%BE%E5%A4%8D%E7%9B%98%E5%B0%8F%E7%A8%8B%E5%BA%8F/"/>
    <published>2026-09-05T16:00:00.000Z</published>
    <summary>
      <![CDATA[<p>去年发过一个小红书帖子，分享了一套极简复盘思路，有 921 个点赞，918 个收藏。</p>
<p>这套模板基本只记三类东西：</p>
<ul>
<li><strong>Did</strong>：今天真正做了什么；</li>
<li><strong>Bad</strong>]]>
    </summary>
    <title>随心迹：我为什么要做一款复盘小程序</title>
    <updated>2026-09-05T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="Thinking" scheme="https://believed-breadfruit.top/categories/Thinking/"/>
    <category term="自我认知" scheme="https://believed-breadfruit.top/tags/%E8%87%AA%E6%88%91%E8%AE%A4%E7%9F%A5/"/>
    <category term="思考" scheme="https://believed-breadfruit.top/tags/%E6%80%9D%E8%80%83/"/>
    <category term="身份" scheme="https://believed-breadfruit.top/tags/%E8%BA%AB%E4%BB%BD/"/>
    <content>
      <![CDATA[<p>今天了解到「同一性资本」理论。看完后，我有一种比较强烈的新鲜感和顿悟感，因为它提供了一个我以前没有使用过的角度。</p><p>过去谈到理想和现实，通常有三种立场。</p><p>第一种是站在现实这一边。这种观点认为，普通人的容错率很低，生存和收入才是最重要的。兴趣、理想和个性都是资源充足以后才有资格考虑的东西。先选择就业好、收入高、风险低的道路，才是对自己负责。</p><p>第二种是站在理想这一边。这种人不认同现实中的功利、竞争和庸俗，更愿意保护自己的精神世界。但与此同时，他又会时刻感受到现实的威胁，担心理想被侵蚀，担心自己最终不得不屈服。</p><p>这两种观点表面上相反，实际上共享同一个前提：理想和现实是互相对立的，只能选择其中一边。</p><p>第三种观点看起来更成熟一些。它认为既不能完全理想主义，也不能完全现实主义，而应该具体情况具体分析，在现实的基础上保留一部分理想。不同阶段可以采用不同的比例，例如七分现实、三分理想，或者三分现实、七分理想。</p><p>我也停留在这种理解里（去年我是第二种）。我会觉得，理想和现实之间不存在统一答案，重点是根据自己的资源、环境和风险承受能力不断调整。这个策略式组合的判断看起来比简单地站队更合理，但它仍然把理想和现实看成了两种需要相互妥协的力量，而且更重要的是，这种妥协每次都要重新计算，天然具有认知决策负担。</p><hr><p>同一性资本理论提供的是完全不同的角度。它不再问：「理想和现实各应该占多少？」它问的是：「一个人围绕『我是谁』所做的选择，最终积累了什么？」</p><p>同一性资本分成两类。</p><p>一类是有形的同一性资本，例如经济资源、学历证书、社会关系、职业网络和家庭背景。</p><p>另一类是无形的同一性资本，例如认知复杂度、内控感、元认知能力、批判性思维和道德推理能力。这些能力并不专属于某一个职业，而是可以迁移到不同环境中。</p><p>这个理论最重要的地方，是它改变了我理解「现实」的方式。</p><p>通常所说的现实，往往只包括可以立即看见的外部回报：工资、专业热度、学历、岗位数量和社会评价。</p><p>但同一性资本理论认为，一个人内部形成的能力、动机和自我理解，同样属于现实资源。它们不是装饰，也不只是精神安慰，而是一个人在环境发生变化时，能够依靠的资本。</p><hr><p>前段时间，有个很火的概念叫做「奥德赛时期」，通常指 20 岁到 35 岁之间，也就是从大学毕业到进入稳定工作、组建家庭之前的这段时间。你会有种漂泊感和迷茫感，在事业、情感和自我认同上不断试错和探索，就像在海上航行，不知道下一个港口在哪里。</p><p>传统社会中，一个人的身份很大程度上由家庭、社区和职业结构直接赋予。出生在什么家庭，通常就会沿着相对确定的道路生活。在这样的社会里，个人自由较少，但「我是谁」也没有那么难回答。</p><p>现代社会完全不一样了。原有身份路径越来越不稳定，专业可能贬值，行业可能收缩，过去有效的技能也可能因为技术变化而迅速失去价值。一个人越来越难依靠某个固定身份度过一生，只能不断重新选择和组织自己。</p><p>在这种情况下，只积累某种具体技能是很难度过奥德赛时期的。具体技能当然重要，但它通常依赖特定环境。掌握一种编程语言、一项工程技术或者一个热门专业，可能在某个阶段具有很高价值，但不能保证这种价值长期存在。</p><p>无形的同一性资本则更加基础。它决定一个人能不能理解新的环境，能不能判断外部建议是否适合自己，能不能在原有路径失效以后重新学习，也决定一个人在没有明确答案的时候，能不能继续行动。</p><hr><p>很多人会认为「普通家庭的孩子容错率低，所以更应该放弃理想」，但是用同一性资本的理论来看，这是恰恰相反的。</p><p>普通人的外部资源确实更少，这个前提没有错。</p><p>但正因为缺乏家庭兜底，一个人才更需要发展那些不会轻易被外部环境夺走的东西。理想不保证成功，但它代表的兴趣和内在动机可能是一个人在遇到困难、学习成本增加或者行业下行以后，仍然愿意继续理解问题和调整方向的原因。</p><p>假如一个人从很早开始就只根据外部回报做选择，他可能会获得一条短期内更安全的路径，却没有练习过怎样从自己的内部作出判断。一旦原本承诺的回报消失，他不仅失去了外部动力，也很难从自身重新产生新的方向。</p><p>因此，普通家庭的孩子如果被要求过早放弃兴趣，选择当下最热门的专业，他放弃的可能恰好是自己少数不依赖家庭资源的竞争力：内在动机。</p><hr><p>坚持理想并不必然意味着无视现实。恰恰相反，真正地坚持理想，前提是最理解现实。</p><p>理想和现实不是一场比例分配。兴趣、价值判断和内在动机，本身也可以构成一种现实能力；学历、收入和职业技能也不只是外部工具，它们同样可以参与一个人的身份建构。</p><p>这就是同一性资本让我有启发的地方。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/07/25/2026-07-26-%E4%B8%BA%E4%BB%80%E4%B9%88%E6%99%AE%E9%80%9A%E4%BA%BA%E6%9B%B4%E5%BA%94%E8%AF%A5%E5%9D%9A%E6%8C%81%E7%90%86%E6%83%B3/</id>
    <link href="https://believed-breadfruit.top/2026/07/25/2026-07-26-%E4%B8%BA%E4%BB%80%E4%B9%88%E6%99%AE%E9%80%9A%E4%BA%BA%E6%9B%B4%E5%BA%94%E8%AF%A5%E5%9D%9A%E6%8C%81%E7%90%86%E6%83%B3/"/>
    <published>2026-07-25T16:00:00.000Z</published>
    <summary>
      <![CDATA[<p>今天了解到「同一性资本」理论。看完后，我有一种比较强烈的新鲜感和顿悟感，因为它提供了一个我以前没有使用过的角度。</p>
<p>过去谈到理想和现实，通常有三种立场。</p>
<p>第一种是站在现实这一边。这种观点认为，普通人的容错率很低，生存和收入才是最重要的。兴趣、理想和]]>
    </summary>
    <title>为什么普通人更应该坚持理想？</title>
    <updated>2026-07-25T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="Thinking" scheme="https://believed-breadfruit.top/categories/Thinking/"/>
    <category term="自我认知" scheme="https://believed-breadfruit.top/tags/%E8%87%AA%E6%88%91%E8%AE%A4%E7%9F%A5/"/>
    <category term="思考" scheme="https://believed-breadfruit.top/tags/%E6%80%9D%E8%80%83/"/>
    <content>
      <![CDATA[<p>看到一个讲投资的视频，里面有一句话让我挺有共鸣。</p><p>他说，真正可怕的不是亏钱，而是人的阈值会被改写。见过太大的收益之后，就很难再接受正常、缓慢的赚钱方式。</p><p>我没有投资经历，但我突然发现，我去年好像经历过一种类似的事情，只不过不是投资，而是思考。</p><p>去年有一段时间，我真的想得太多了，思考密度极大，而且抽象层次越来越高，这是一种认知上异常高刺激的状态。</p><hr><p>今天去南山博物馆的时候，看着深圳以前发展的历史，我就在想，如果我是那个时代的人，会怎么样？</p><p>如果我出生在那里，可能就是一个采牡蛎的人，每天干着这样的活。我会觉得挺惨的，因为很多事情不是自己喜欢不喜欢的问题，而是根本没有得选。从出生开始，你所处的时代、接触的人、生活的环境，很多东西就已经决定了人生的大方向。</p><p>但同样是在那个时代，有的人可能出生在战争里，从小颠沛流离；有的人却出生在富裕家庭，无忧无虑地长大。同一个时间，同一个地球，居然有人过着完全不一样的人生，而这些都不是自己能选择的。</p><p>后来我意识到，这种痛苦可能来自两个原因。</p><hr><p>第一个原因，是现在的信息太发达了。</p><p>我们可以一边过着自己简简单单、三点一线的生活，一边不断看到世界另一端完全不同的人生。今天看到美国常春藤毕业的人离职去硅谷创业，明天看到非洲的孩子吃不饱饭，后天又看到几百年前某个人的一生。我们的认知可以很丝滑地在不同国家、不同阶层、不同历史时期之间不断切换。</p><p>第二个原因，我本身喜欢思考，因为这件事情给我带来很多正反馈。但是，我到了一种极端，思考抽象层次越来越高，毫无边界，认知枯竭后甚至一度觉得很虚无。</p><p>当习惯了这种不断跳跃、不断抽象之后，那些真实生活里的摩擦，反而会被忽略。明明真正的生活就是这些具体的小事，但因为大脑已经习惯了站在很高的视角去思考，再回到现实的时候，就会觉得现实特别有摩擦。</p><p>比如读一本书需要慢慢读，学一个东西需要一点点积累，甚至蒸个蛋失败一次，都会觉得特别受打击。</p><hr><p>现在回头看，我觉得这和那个投资视频讲的是同一件事。</p><p>投资会把一个人的收益阈值拉高，而不断停留在抽象世界里，也会慢慢把一个人的认知阈值拉高。</p><p>阈值一旦被改写，再回到普通的现实生活，就需要重新学会接受那些缓慢、具体、充满摩擦的过程，而这个过程必定会非常痛苦。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/07/24/2026-07-24-%E5%BD%93%E4%B8%80%E4%B8%AA%E4%BA%BA%E7%9A%84%E8%AE%A4%E7%9F%A5%E9%98%88%E5%80%BC%E8%A2%AB%E6%8B%89%E9%AB%98%E5%90%8E/</id>
    <link href="https://believed-breadfruit.top/2026/07/24/2026-07-24-%E5%BD%93%E4%B8%80%E4%B8%AA%E4%BA%BA%E7%9A%84%E8%AE%A4%E7%9F%A5%E9%98%88%E5%80%BC%E8%A2%AB%E6%8B%89%E9%AB%98%E5%90%8E/"/>
    <published>2026-07-24T07:06:15.000Z</published>
    <summary>
      <![CDATA[<p>看到一个讲投资的视频，里面有一句话让我挺有共鸣。</p>
<p>他说，真正可怕的不是亏钱，而是人的阈值会被改写。见过太大的收益之后，就很难再接受正常、缓慢的赚钱方式。</p>
<p>我没有投资经历，但我突然发现，我去年好像经历过一种类似的事情，只不过不是投资，而是思考。</]]>
    </summary>
    <title>当一个人的认知阈值被拉高后</title>
    <updated>2026-07-24T07:06:15.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="Thinking" scheme="https://believed-breadfruit.top/categories/Thinking/"/>
    <category term="自我认知" scheme="https://believed-breadfruit.top/tags/%E8%87%AA%E6%88%91%E8%AE%A4%E7%9F%A5/"/>
    <category term="思考" scheme="https://believed-breadfruit.top/tags/%E6%80%9D%E8%80%83/"/>
    <category term="系统论" scheme="https://believed-breadfruit.top/tags/%E7%B3%BB%E7%BB%9F%E8%AE%BA/"/>
    <content>
      <![CDATA[<p>今天和姐姐视频聊天时，发现自己在对话中像一个心理辅导师：当对方陷入情绪时，会引导她切换到更理性的角度；当对方过度理性时，又会提醒她看到感性和情绪的一面。</p><p>这个过程让我意识到，自己常用的策略是“对症下药”，也就是当一个人偏向某一端时，帮助她看到另一端，以恢复某种平衡。</p><p>但进一步思考后，我开始怀疑“平衡一定是好的”这个默认假设。</p><p>过去我会把解决问题理解为恢复平衡：遇到冲突，就用对立面去调节它；遇到情绪，就用理性去处理它；遇到过度理性，又补充情绪视角。但如果平衡已经达成，冲突消失之后，我反而不知道下一步该做什么。</p><hr><p>和 AI 聊了一通，它指出了一个很有意思的点：</p><blockquote><p>如果想要成长，就不应该要平衡，而是梯度。</p></blockquote><p>举个例子。一个创业者，如果一直保持心理平衡，他可能不会创业。一个科学家，如果一直保持平衡，他可能不会花十年研究一个问题。一个艺术家，如果一直平衡，也可能不会产生那些极端投入的作品。</p><p>也就是说：<strong>稳定系统需要平衡，而成长系统需要梯度。</strong></p><p>我希望我的人生是不断往上增长的，所以我不该只是用策略保持平衡。当我今天写下这篇思考，这意味着我已经开始从平衡阶段向成长阶段过渡。</p><hr><p>下一个点，就是得主动创造想成长的方向：是否有一个方向，我愿意长期投入精力去做？</p><p>我想了下自己感兴趣的东西，其实不是某个固定领域，而是类似《硅谷》（Silicon Valley）里那种荒诞但可建模的问题：“10 分钟给 800 人……”也就是在约束条件下如何提高效率、如何建立模型、如何逼近最优解。</p><p>这种兴趣可以出现在光学、AI、人的思维、组织系统、职业选择等多个场景中。</p><p>也就是说，我的底层兴趣可能是复杂系统建模。但是经过一年多的高思考、低行动，我很清楚抽象的局限性，所以长期做的事情肯定还是得有一个具体现实的载体。</p><p>事实上，我没有任何答案。但是好在，我知道行动是方向的解药。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/07/04/2026-07-05-%E6%80%80%E7%96%91%E5%B9%B3%E8%A1%A1%E4%B8%80%E5%AE%9A%E6%98%AF%E5%A5%BD%E7%9A%84%E8%BF%99%E4%B8%AA%E5%81%87%E8%AE%BE/</id>
    <link href="https://believed-breadfruit.top/2026/07/04/2026-07-05-%E6%80%80%E7%96%91%E5%B9%B3%E8%A1%A1%E4%B8%80%E5%AE%9A%E6%98%AF%E5%A5%BD%E7%9A%84%E8%BF%99%E4%B8%AA%E5%81%87%E8%AE%BE/"/>
    <published>2026-07-04T16:00:00.000Z</published>
    <summary>
      <![CDATA[<p>今天和姐姐视频聊天时，发现自己在对话中像一个心理辅导师：当对方陷入情绪时，会引导她切换到更理性的角度；当对方过度理性时，又会提醒她看到感性和情绪的一面。</p>
<p>这个过程让我意识到，自己常用的策略是“对症下药”，也就是当一个人偏向某一端时，帮助她看到另一端，以恢复某种]]>
    </summary>
    <title>怀疑『平衡一定是好的』这个假设</title>
    <updated>2026-07-04T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="Today I Learn" scheme="https://believed-breadfruit.top/categories/Today-I-Learn/"/>
    <category term="AI" scheme="https://believed-breadfruit.top/tags/AI/"/>
    <category term="工程实践" scheme="https://believed-breadfruit.top/tags/%E5%B7%A5%E7%A8%8B%E5%AE%9E%E8%B7%B5/"/>
    <content>
      <![CDATA[<p>最近看到一篇综述兼评论风格的文章（<a href="https://mp.weixin.qq.com/s/bk3-aSyTGsx_hEo-vt5KfQ">原文链接</a>）。起因是 Anthropic 新发布了 Dynamic Workflows，作者借此回顾了从 2022 年到 2025&#x2F;2026 年这几年间 Agent 技术的研究脉络。</p><p>文章的核心观点可以总结为一句话：Agent 能力的提升，并不只是靠模型本身更强，而是把那些不适合塞进上下文窗口的东西，挪到了 runtime、代码、技能库和工作流脚本里。</p><p>这篇文章让我对工程实践产生了三点新的思考。</p><p>一、工程的高可用，来自确定性</p><p>什么是确定性？相同的输入，系统总能产生相同的输出。</p><p>在计算机工程里，确定性有：计算确定（数学运算、排序、解析）和逻辑确定（if&#x2F;else、布尔判断）。</p><p>所以在 Agent 技术里，代码做了确定的事情（计算、执行、可重复运行），大模型则做”模糊”的事（制定计划、解释概念、拆解意图）；人做”决策”的事（定目标、做取舍）。</p><p>二、厉害的技术，未必新颖</p><p>还有另一个感悟，是关于 Agent 这一路的发展历程。</p><p>提示词工程、思维链（CoT）、ReAct 推理、Function Calling、工作流……回头看，这些概念在底层原理上其实都谈不上多么”高明”。</p><p>这让我意识到一个长期存在的误区：我们总觉得，真正厉害的东西一定得足够新颖。</p><p>所以，当一项技术的底层实现并不新颖时，很多人会下意识地说：”这不就跟那个谁谁差不多吗？”——这种评价背后的潜台词是：一项技术要够牛，就必须够新。</p><p>但现实恰恰相反。技术演进路上的每一步，其提出的观念往往本身都算不上惊艳。它们只是”恰好有用”，并且被足够多的人验证过、确实能跑出好结果而已。</p><p>三、为什么技术总是”沿着第一条路”走下去</p><p>再延伸一点。假设技术演进是一条 A1 → A2 → A3 → A4 不断向前的路径。</p><p>但其实在 A1 这个节点上，原本可能同时存在三条岔路：A1、B1、C1。</p><p>只是因为 A1 最先出现、最先被大多数人验证，又恰好反响热烈，于是大家会迅速围绕 A1 去做周边迭代、做配套基建。结果就是——整个技术生态都顺着 A1 这条路一路长了下去，而不是从 B1 或 C1 出发。</p><p>所以技术的演进方向，很多时候并不是因为 A1 一定最优，而是因为它”先到”，先吃到了验证和生态的红利。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/06/04/2026-06-05-%E5%AF%B9%E5%B7%A5%E7%A8%8B%E5%AE%9E%E8%B7%B5%E6%9C%89%E4%BA%86%E6%96%B0%E8%AE%A4%E8%AF%86/</id>
    <link href="https://believed-breadfruit.top/2026/06/04/2026-06-05-%E5%AF%B9%E5%B7%A5%E7%A8%8B%E5%AE%9E%E8%B7%B5%E6%9C%89%E4%BA%86%E6%96%B0%E8%AE%A4%E8%AF%86/"/>
    <published>2026-06-04T16:00:00.000Z</published>
    <summary>
      <![CDATA[<p>最近看到一篇综述兼评论风格的文章（<a href="https://mp.weixin.qq.com/s/bk3-aSyTGsx_hEo-vt5KfQ">原文链接</a>）。起因是 Anthropic 新发布了 Dynamic Workflows，作者借此回顾了从 2022]]>
    </summary>
    <title>对工程实践有了新认识</title>
    <updated>2026-06-04T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="Today I Learn" scheme="https://believed-breadfruit.top/categories/Today-I-Learn/"/>
    <category term="AI" scheme="https://believed-breadfruit.top/tags/AI/"/>
    <category term="技术洞察" scheme="https://believed-breadfruit.top/tags/%E6%8A%80%E6%9C%AF%E6%B4%9E%E5%AF%9F/"/>
    <content>
      <![CDATA[<p><a href="https://aiweekly.co/learning-ai/artificial-intelligence/ai-weekly-index">AI Weekly Index</a>，它用一份报表呈现了 2015–2026 年的 AI 话语趋势。</p><p>其中有一个观察很有意思：这两年，扩散模型、RAG、Transformer 这些概念几乎从讨论中消失了。但它们消失，并不是因为失败，而是因为它们已经沉淀成了一种”不可见的基础设施”。</p><p>这句话可以从三个层面来理解。</p><p>一、为什么”消失”不等于”失败”</p><p>我们之所以会反复谈论一项新技术，往往是因为它还停留在”需要被解释、需要被证明”的阶段。</p><p>Transformer 在 2022 年被高频提及（0.44 次&#x2F;期），正是因为人们还在争论它的潜力；而到了 2026 年，提及次数归零，恰恰是因为它已经成为所有主流大模型的底层架构。它不再需要被讨论，因为它已经被默认了。</p><p>这就像今天没有人会特意说”我用互联网来发邮件”：互联网早已融入一切，反而不再作为一个独立话题存在。扩散模型和 RAG 走的是同一条路：从”前沿概念”变成”标准工具”，于是话语自然向更上层迁移。</p><p>二、”不可见的基础设施”意味着什么</p><p>报表里的数据把这个模式呈现得很清楚：机器学习在 2021 年达到峰值（3.72 次&#x2F;期），到 2026 年降为 0；深度学习晚两年，但走出了同样的曲线；扩散模型只”存活”了两年（2022–2023）便淡出了讨论。</p><p>但它们并没有退出舞台，恰恰相反，它们渗透进了每一个产品、每一篇论文、每一次对话的底层。</p><p>当一项技术不再需要被特意命名，就说明它已经从”创新”变成了”常识”，从”需要被选择”变成了”无需选择”。这正是技术走向成熟的最强信号。</p><p>三、”消失得最快 &#x3D; 最成功”的深层逻辑</p><p>这句话真正精妙的地方，在于它翻转了我们判断”成功”的标准。</p><p>我们通常用热度、讨论量、搜索指数来衡量一项技术的影响力。但这份数据揭示了相反的规律：真正改变行业的技术，往往是最快从话语中退场的那一批。原因很简单：当所有人都已经在用它，就没人再需要谈论它了。</p><p>反过来看，那些长期停留在讨论阶段的概念（比如”伦理”在 2019–2022 年持续高热），往往意味着行业还没有形成共识、找到解法，问题仍然悬而未决。</p><p>到这里，这让我想起 skills 刚出来的时候，很多文章把它和 MCP 拿来对比，断言”MCP 被推翻了”。</p><p>我当时专门调研过，发现 MCP 不仅没有退场，反而沉到了更底层，渗透进了 agent 技术的基础之中。</p><p>skills 和 MCP 本就是两个不同维度的东西，很多人把它们放在一起比较，其实是不了解二者的本质：skills 是一套稳定的工作流，MCP 是一种通信协议。</p><p>它们唯一可比的角度，是对上下文的影响：skills 按需加载，对上下文友好；MCP 偏向全量加载，更容易让上下文膨胀。除此之外，二者并不在同一条赛道上。</p><p>每当一个新概念出现，人们总是习惯性地把它和最近一个”看起来相关”的旧概念做替代式对比，而不是去理解它们各自在技术栈中所处的位置。</p><p>身处技术栈内部的人，能感知到各层之间的相对位置和依赖关系；而身处外部的人，只能看到话语层的表面，哪个词上了热搜，哪个词消失了，就据此判断谁赢谁输。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/06/02/2026-06-03-%E6%8A%80%E6%9C%AF%E6%B6%88%E5%A4%B1%E7%9A%84%E5%9F%BA%E7%A1%80%E8%AE%BE%E6%96%BD/</id>
    <link href="https://believed-breadfruit.top/2026/06/02/2026-06-03-%E6%8A%80%E6%9C%AF%E6%B6%88%E5%A4%B1%E7%9A%84%E5%9F%BA%E7%A1%80%E8%AE%BE%E6%96%BD/"/>
    <published>2026-06-02T16:00:00.000Z</published>
    <summary>
      <![CDATA[<p><a href="https://aiweekly.co/learning-ai/artificial-intelligence/ai-weekly-index">AI Weekly Index</a>，它用一份报表呈现了 2015–2026 年的 AI 话语趋势。</p>]]>
    </summary>
    <title>这两年扩散模型、RAG、Transformer 这些概念几乎从讨论中消失了</title>
    <updated>2026-06-02T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="Today I Learn" scheme="https://believed-breadfruit.top/categories/Today-I-Learn/"/>
    <category term="技术" scheme="https://believed-breadfruit.top/tags/%E6%8A%80%E6%9C%AF/"/>
    <category term="Claude Code" scheme="https://believed-breadfruit.top/tags/Claude-Code/"/>
    <content>
      <![CDATA[<p>Claude Code 的过程观测有几个层次，从轻量到重型都有，下面分层介绍。</p><hr><h2 id="一、交互模式下的即时查看"><a href="#一、交互模式下的即时查看" class="headerlink" title="一、交互模式下的即时查看"></a>一、交互模式下的即时查看</h2><p><strong><code>--debug</code> 标志</strong> — 最直接的方式</p><p>启动时加上 <code>--debug</code> 可以看到 API 调用、工具调用、执行耗时等详细信息，输出到 stderr：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">claude --debug                          <span class="comment"># 完整 debug 输出</span></span><br><span class="line">claude --debug <span class="string">&quot;api,hooks&quot;</span>              <span class="comment"># 只看特定类别</span></span><br><span class="line">claude --debug-file /tmp/claude-debug.log  <span class="comment"># 写入文件，保持终端整洁</span></span><br></pre></td></tr></table></figure><p><strong><code>--verbose</code></strong> 则是更轻量的开关，可在配置里持久化，或启动时传入。</p><hr><h2 id="二、读取本地-JSONL-日志（离线回溯）"><a href="#二、读取本地-JSONL-日志（离线回溯）" class="headerlink" title="二、读取本地 JSONL 日志（离线回溯）"></a>二、读取本地 JSONL 日志（离线回溯）</h2><p>Claude Code 的 session transcript 以 JSONL 格式存储在 <code>~/.claude/projects/</code> 目录下，里面记录了每次 tool call、thinking step、token 用量等内容。原始文件可读性较差（是 escaped JSON），但可以直接 <code>cat</code> 或用 <code>jq</code> 解析。</p><p>社区工具 <strong><a href="https://claude-dev.tools/">claude-devtools</a></strong> 可以解析这些文件，它会重建完整的 session transcript —— 每个 tool call 展开、thinking step 可见、token 用量按 turn 分解，subagent 执行以树状结构渲染。</p><hr><h2 id="三、通过-Hooks-实时拦截（适合自定义观测）"><a href="#三、通过-Hooks-实时拦截（适合自定义观测）" class="headerlink" title="三、通过 Hooks 实时拦截（适合自定义观测）"></a>三、通过 Hooks 实时拦截（适合自定义观测）</h2><p>Hooks 是 Claude Code 的扩展点，可以在 <code>PreToolUse</code>、<code>PostToolUse</code> 等生命周期事件上挂载脚本。这是目前<strong>最灵活</strong>的方案——你可以在 hook 脚本里把 tool call 的输入&#x2F;输出写到自己的日志系统，或触发告警。</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line">// .claude/settings.json</span><br><span class="line">&#123;</span><br><span class="line">  &quot;hooks&quot;: &#123;</span><br><span class="line">    &quot;PostToolUse&quot;: [&#123;</span><br><span class="line">      &quot;matcher&quot;: &quot;*&quot;,</span><br><span class="line">      &quot;hooks&quot;: [&#123;</span><br><span class="line">        &quot;type&quot;: &quot;command&quot;,</span><br><span class="line">        &quot;command&quot;: &quot;python3 /path/to/logger.py&quot;</span><br><span class="line">      &#125;]</span><br><span class="line">    &#125;]</span><br><span class="line">  &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>Hook 脚本通过 stdin 收到 JSON 事件，包含 tool 名称、参数、结果等。</p><hr><h2 id="四、OpenTelemetry-导出（生产-团队级别）"><a href="#四、OpenTelemetry-导出（生产-团队级别）" class="headerlink" title="四、OpenTelemetry 导出（生产&#x2F;团队级别）"></a>四、OpenTelemetry 导出（生产&#x2F;团队级别）</h2><p>Claude Code CLI 内置了 OpenTelemetry instrumentation：它会在每次 model request 和 tool execution 上记录 span，发出 token&#x2F;cost 计数的 metrics，并为 prompt 和 tool result 发出结构化 log event。</p><p>开启方式：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">export</span> CLAUDE_CODE_ENABLE_TELEMETRY=1</span><br><span class="line"><span class="built_in">export</span> CLAUDE_CODE_ENHANCED_TELEMETRY_BETA=1   <span class="comment"># 开启 Traces（beta）</span></span><br><span class="line"><span class="built_in">export</span> OTEL_TRACES_EXPORTER=otlp</span><br><span class="line"><span class="built_in">export</span> OTEL_LOGS_EXPORTER=otlp</span><br><span class="line"><span class="built_in">export</span> OTEL_EXPORTER_OTLP_ENDPOINT=http://localhost:4318</span><br></pre></td></tr></table></figure><p>支持导出到任何接受 OTLP 协议的后端，比如 Honeycomb、Datadog、Grafana、Langfuse，或自托管的 collector。</p><hr><h2 id="小结"><a href="#小结" class="headerlink" title="小结"></a>小结</h2><table><thead><tr><th>需求</th><th>方案</th></tr></thead><tbody><tr><td>临时调试某次执行</td><td><code>claude --debug</code></td></tr><tr><td>事后回溯 session</td><td>读 <code>~/.claude/projects/*.jsonl</code> 或用 claude-devtools</td></tr><tr><td>自定义日志&#x2F;告警</td><td>Hooks + 脚本</td></tr><tr><td>团队监控 &#x2F; 成本追踪</td><td>OpenTelemetry 导出</td></tr></tbody></table>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/06/01/2026-06-01-claude-code%E8%BF%87%E7%A8%8B%E8%A7%82%E6%B5%8B/</id>
    <link href="https://believed-breadfruit.top/2026/06/01/2026-06-01-claude-code%E8%BF%87%E7%A8%8B%E8%A7%82%E6%B5%8B/"/>
    <published>2026-06-01T00:00:00.000Z</published>
    <summary>
      <![CDATA[<p>Claude Code 的过程观测有几个层次，从轻量到重型都有，下面分层介绍。</p>
<hr>
<h2 id="一、交互模式下的即时查看"><a href="#一、交互模式下的即时查看" class="headerlink" title="一、交互模式下的即时查看"></]]>
    </summary>
    <title>Claude Code 过程观测的几种方式</title>
    <updated>2026-06-01T00:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="Today I Learn" scheme="https://believed-breadfruit.top/categories/Today-I-Learn/"/>
    <category term="哲学" scheme="https://believed-breadfruit.top/tags/%E5%93%B2%E5%AD%A6/"/>
    <category term="思考" scheme="https://believed-breadfruit.top/tags/%E6%80%9D%E8%80%83/"/>
    <content>
      <![CDATA[<p>斯多葛哲学（Stoicism）起源于古希腊、在古罗马发展成熟，代表人物包括 Zeno of Citium、Epictetus、Seneca 和 Marcus Aurelius。很多人以为斯多葛就是”忍耐””压抑情绪”，但那只是很小的一部分——它本质上是一套关于如何生活的哲学体系。浓缩成几个核心思想，大致如下。</p><ol><li>区分可控与不可控</li></ol><p>Epictetus 在《手册》开篇就指出：”有些事情取决于我们，有些事情不取决于我们。”取决于我们的，是判断、选择、价值观和行动；不取决于我们的，则是天气、他人评价、财富、身体健康的很多方面、社会环境，以及最终结果。</p><p>斯多葛认为，痛苦往往来自于试图控制无法控制的东西——希望所有人喜欢自己、希望永远不失败、希望事情完全按计划发展，这些目标本身就与现实冲突。因此他们主张把精力集中于行动而非结果，这与现代心理学中的”过程导向”很接近。</p><ol start="2"><li>德性是唯一真正的善</li></ol><p>这是斯多葛最容易被现代人忽略的部分。他们认为财富、地位、健康、名声都不是人生最高目标，真正重要的是 智慧（Wisdom）、勇气（Courage）、正义（Justice）、节制（Temperance）。一个人贫穷但正直，依然是成功的人；一个人富有却卑劣，依然是失败的人。幸福建立在品格上，而不是建立在运气上。</p><ol start="3"><li>情绪来自判断</li></ol><p>斯多葛并不认为外界直接产生情绪，而是 事件 → 判断 → 情绪。同样是”失业”，解释成”人生完了”会带来焦虑和绝望，解释成”一次新的机会”则带来平静和积极行动。事件相同、情绪不同，区别完全来自认知解释——这也是后来 CBT（认知行为疗法）的重要思想来源。</p><ol start="4"><li>接受现实（Amor Fati）</li></ol><p>斯多葛强调不要与已经发生的现实对抗，Nietzsche 后来把这种思想概括为 Amor Fati（热爱命运）。这不是消极认命，而是承认现实已经发生、与现实争吵毫无意义，应当把精力放在”接下来我能做什么”上。面对考试失败、项目延期、被人拒绝，斯多葛不会否认痛苦的存在，只是认为抱怨无法改变事实，行动才可能改变未来。</p><ol start="5"><li>死亡意识（Memento Mori）</li></ol><p>斯多葛经常提醒自己”人终将死亡”，这听起来悲观，目的却恰恰相反：当意识到生命有限时，网络争吵、面子问题、一时得失这些烦恼都会缩小。他们借助死亡意识来校准人生优先级。</p><ol start="6"><li>负面预演（Premeditatio Malorum）</li></ol><p>主动去想象失业、失败、被拒绝、贫穷，目的不是吓自己，而是降低对不确定性的恐惧。很多焦虑来自”我无法接受最坏情况”，但当真正面对最坏情况时，人往往发现自己能够承受，这会显著提高心理韧性。</p><ol start="7"><li>人是共同体动物</li></ol><p>斯多葛并不主张独来独往。Marcus Aurelius 写道：”人生来就是为了彼此合作。”他们认为每个人都是更大整体的一部分，因此应当善待他人、履行责任、贡献社会——这与纯粹的个人主义并不相同。</p><hr><p>一句话总结：接受无法改变的现实，专注于能够控制的行动，并通过智慧、勇气、正义和节制塑造自己的品格。</p><p>斯多葛哲学最有价值的部分可能不是”坚强”，而是那个持续追问：<strong>“这件事究竟是现实本身让我痛苦，还是我对现实的解释让我痛苦？”</strong> 这个问题，正是斯多葛哲学和认知行为疗法的交汇点。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/05/29/2026-05-30-%E6%96%AF%E5%A4%9A%E8%91%9B%E5%93%B2%E5%AD%A6%E5%BE%88%E5%A4%9A%E7%90%86%E5%BF%B5%E5%92%8C%E6%88%91%E7%B1%BB%E4%BC%BC/</id>
    <link href="https://believed-breadfruit.top/2026/05/29/2026-05-30-%E6%96%AF%E5%A4%9A%E8%91%9B%E5%93%B2%E5%AD%A6%E5%BE%88%E5%A4%9A%E7%90%86%E5%BF%B5%E5%92%8C%E6%88%91%E7%B1%BB%E4%BC%BC/"/>
    <published>2026-05-29T16:00:00.000Z</published>
    <summary>
      <![CDATA[<p>斯多葛哲学（Stoicism）起源于古希腊、在古罗马发展成熟，代表人物包括 Zeno of Citium、Epictetus、Seneca 和 Marcus Aurelius。很多人以为斯多葛就是”忍耐””压抑情绪”，但那只是很小的一部分——它本质上是一套关于如何生活的哲学]]>
    </summary>
    <title>斯多葛哲学很多理念和我类似</title>
    <updated>2026-05-29T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="Thinking" scheme="https://believed-breadfruit.top/categories/Thinking/"/>
    <category term="自我认知" scheme="https://believed-breadfruit.top/tags/%E8%87%AA%E6%88%91%E8%AE%A4%E7%9F%A5/"/>
    <category term="自律" scheme="https://believed-breadfruit.top/tags/%E8%87%AA%E5%BE%8B/"/>
    <category term="精力管理" scheme="https://believed-breadfruit.top/tags/%E7%B2%BE%E5%8A%9B%E7%AE%A1%E7%90%86/"/>
    <content>
      <![CDATA[<p>这周上班用脑过度，周五下班时已经累到连吃饭都觉得是负担，那天晚上很早就睡了，其他事一概不想干。周六索性休息了一整天；到了周天，整个人才重新「get my shit together」——有精力健身，也愿意坐下来复盘了。</p><p>这个小小的循环让我意识到一件事：能不能做事，本质上取决于精力，而不是意志力。休息好了，思考自然涌出来、想法自然冒出来，做事的欲望也跟着回来；可一旦精力被榨干，再有道理的事也推不动。顺着这个观察，我对「自律」又有了一些新的理解。</p><hr><p>去年我得出过一个结论：所谓自律，其实并不需要刻意强迫自己。当一件事变成你当下「最有可能、也最合适」做的选项，去做它就是顺理成章的事，根本谈不上什么自律。那时候我的方法论也很简单：不依赖意志力，而是设计环境，让目标行为成为大脑唯一可选项。顺着本能走，而不是顶着本能上。</p><p>今年我发现，「自然而然做事」这种状态其实不是凭空发生的。它有两个前提：身体已经恢复，以及饮食、休息、睡眠都到位。只有这些条件齐备，人才会自动滑入下一种状态；如果地基不在，再去硬撑着做事——确实也能做——那大概就是大家口中真正的「自律」吧。</p><hr><p>小时候被灌输的「自律」是另一套叙事：克服意志力、突破生理极限，运动员带伤跑完比赛、学生周末还在埋头做题。后来我发现，那些被鼓励去「自律」的事——学习、思考、锻炼——在生活足够单调、选项有限的时候，本来就会自然发生，根本不需要咬牙坚持。</p><p>这是去年的我看到的一面。</p><p>今年又看到了另一面：工作日精力被榨干之后，这些事真的推不动；可一旦周末休息够了，它们又会自发回来。这至少说明两点：</p><ol><li><p>学习、思考、锻炼本身就是高消耗的事。你不想做，不一定是懒、不一定是不自律，更可能是身体资源已经见底。</p></li><li><p>身体就像一块电池。低电量时确实可以再逼自己一把，但这种透支不可持续。与其执着于「再坚持一次」，不如想清楚：这一次硬撑能换来什么？如果回报有限，那休息才是更划算的选择。</p></li></ol><hr><p>这些东西表面上是个人感受，但其实背后都能找到一些更底层的逻辑。</p><p><strong>第一件事是，意志力本身就是一种有限的生理资源。</strong> 心理学里有个说法叫「自我损耗」（Ego Depletion）——Roy Baumeister 那一批研究的结论是，自控力像肌肉一样，高强度的脑力劳动、决策、情绪控制，都在持续抽取同一个能量池。能量耗尽后，人会自然倾向于阻力最小的路径，此时再去迫自己做难事，失败率高得离谱。所以「精力被榨干之后什么也不想做」，不是性格问题，是生理问题。</p><p><strong>第二件事是，真正高绩效的人管理的不是时间，而是精力。</strong> 小时候作文里那个「带伤跑完比赛的运动员」，在现代职业体育里是被严厉禁止的——那种「坚持」会毁掉运动员的整个职业生涯。</p><p>《哈佛商业评论》那篇被反复引用的 <em>The Making of a Corporate Athlete</em>，Jim Loehr 和 Tony Schwartz 说得很直白：时间是固定的，精力才是可以扩展、可以恢复的资源。顶级运动员的训练模式从来不是「持续发力」，而是压力与恢复有节奏地交替；职场上所谓的「企业运动员」也一样——不是撑着硬干，而是刻意留出恢复周期。长期只消耗不恢复，表面上还在运转，实际上决策质量、创造力和情绪稳定性都在悄悄滑坡。</p><p>所以所谓的「咬牙坚持」，本质上是在透支核心储备。如果不计投资回报，仅仅为了「感动自己」或者「看起来比别人自律」而硬撑，那不叫自律，叫自我消耗。</p><p><strong>第三件事更伤感一点，是我们被教会的「坚持」叙事，本来就是为了学校这个场景设计的。</strong> 哲学家 James P. Carse 把世间的游戏分成两种：有限游戏和无限游戏。学校是典型的有限游戏——规则固定、玩家固定（同班同学）、目标唯一（分数），且常常是零和博弈。为了在这场有限游戏里胜出，「吃苦」和「盲目坚持」自然就被括刷成了筛选机制。但社会是一场无限游戏，那套逻辑拿出来就完全不成立了。</p><p>如果社会是一场多维度的无限游戏，那么真正值得问的不是「我周末要不要逼自己学习」，而是：<strong>我该如何利用周末和精力，构建适合自己的「多维竞争优势」？</strong></p><hr><p>顺着这个问题，我比较认可三条思路。</p><p><strong>1. 从「一万小时」转向「技能叠加」</strong></p><p>学校要求你在单一学科上做到前 1%，但在社会这场无限游戏里，更聪明的策略是在两到三个领域都做到前 25%，再把它们组合起来。Marc Andreessen 说过一句话，我记很清楚：除了极少数天才，普通人获得超额回报最可靠的方式，就是同时掌握两种「组合起来很值钱」的技能。</p><p>这意味着，精力充沛的周末，不该再去死磕本职工作中边际收益递减的技能。可以挑一个完全不同、但能与现有能力发生化学反应的领域去探索——比如程序员去学设计心理学。</p><p><strong>2. 用「杠铃策略」分配精力</strong></p><p>既然身体是一块电池，那周末的精力分配就不该平均用力。Nassim Taleb 在《反脆弱》里讲过一个我觉得很好用的思路：把资源推向两个极端，避开中间地带。落到周末上是这样的：</p><p>约 <strong>80%</strong> 的精力投入「绝对恢复」。周五晚上的彻底摆烂、充足睡眠、毫无压力的散步、优质饮食。这一端守住基本盘。</p><p>约 <strong>20%</strong> 的精力投入「激进探索」。在周六下午或周日上午精力顶峰的 2–3 小时，去做有长期复利的事：写一篇东西、研究一个新工具、做一次深度训练。</p><p>砍掉中间地带。那些既不能让你彻底放松、也不能让你真正成长的活动（漫无目的刷短视频、无效社交），是最不划算的投入。</p><p><strong>3. 重新看待「休闲」</strong></p><p>休闲不是生产力的对立面。Cal Newport 讲「深度游戏」（Deep Play）时说得很准：高质量的休闲并不是对生产力的浪费，反而是维持高水平深度工作的前提。</p><p>对我来说，这意味着周末除了「纯休息」，还可以主动去找那种让人愿意投入、甚至能带来能量回流的活动：需要专注的运动（球类）、一门手艺（做饭）、沉浸式的阅读。它们也消耗体力，但不榨干心智带宽，反而能清理工作日积下的认知垃圾。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/05/24/2026-05-24-%E6%88%91%E7%9A%84%E8%87%AA%E5%BE%8B%E8%A7%82-2-0/</id>
    <link href="https://believed-breadfruit.top/2026/05/24/2026-05-24-%E6%88%91%E7%9A%84%E8%87%AA%E5%BE%8B%E8%A7%82-2-0/"/>
    <published>2026-05-24T08:30:00.000Z</published>
    <summary>
      <![CDATA[<p>这周上班用脑过度，周五下班时已经累到连吃饭都觉得是负担，那天晚上很早就睡了，其他事一概不想干。周六索性休息了一整天；到了周天，整个人才重新「get my shit together」——有精力健身，也愿意坐下来复盘了。</p>
<p>这个小小的循环让我意识到一件事：能不能做]]>
    </summary>
    <title>我的自律观 2.0</title>
    <updated>2026-05-24T08:30:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="Today I Learn" scheme="https://believed-breadfruit.top/categories/Today-I-Learn/"/>
    <category term="技术" scheme="https://believed-breadfruit.top/tags/%E6%8A%80%E6%9C%AF/"/>
    <category term="JavaScript" scheme="https://believed-breadfruit.top/tags/JavaScript/"/>
    <category term="Promise" scheme="https://believed-breadfruit.top/tags/Promise/"/>
    <category term="Deferred Pattern" scheme="https://believed-breadfruit.top/tags/Deferred-Pattern/"/>
    <category term="Vue" scheme="https://believed-breadfruit.top/tags/Vue/"/>
    <content>
      <![CDATA[<blockquote><p>本文从一段 Vue 项目中「防抖 + Promise resolve 外挂」的弹窗代码出发，分析它为什么别扭、背后想实现的 Deferred Pattern 究竟是什么，以及在现代 JavaScript 里更干净的写法。</p></blockquote><h2 id="一、问题代码"><a href="#一、问题代码" class="headerlink" title="一、问题代码"></a>一、问题代码</h2><p>先看引发讨论的这段代码：</p><figure class="highlight typescript"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">const</span> debounceOpenRecomfirmPopup = <span class="title function_">debounce</span>(</span><br><span class="line"><span class="function">(<span class="params">resolve</span>) =&gt;</span> &#123;</span><br><span class="line"><span class="comment">// 记录 Promise resolve，等待关闭回调传回 actionCode</span></span><br><span class="line">recomfirmPopupPromiseResolve.<span class="property">value</span> = resolve <span class="keyword">as</span> (<span class="attr">actionCode</span>: <span class="string">&#x27;confirm&#x27;</span> | <span class="string">&#x27;cancel&#x27;</span> | <span class="string">&#x27;close&#x27;</span>) =&gt; <span class="built_in">void</span></span><br><span class="line"><span class="comment">// 打开二次确认弹窗</span></span><br><span class="line">isShowRecomfirmPopup.<span class="property">value</span> = <span class="literal">true</span></span><br><span class="line">&#125;,</span><br><span class="line"><span class="number">300</span></span><br><span class="line">)</span><br><span class="line"></span><br><span class="line"><span class="comment">// 利息换超市卡二次确认弹窗：打开</span></span><br><span class="line"><span class="keyword">const</span> <span class="title function_">openRecomfirmPopupAsync</span> = (<span class="params"></span>) =&gt; &#123;</span><br><span class="line"><span class="keyword">return</span> <span class="keyword">new</span> <span class="title class_">Promise</span>&lt;<span class="string">&#x27;confirm&#x27;</span> | <span class="string">&#x27;cancel&#x27;</span> | <span class="string">&#x27;close&#x27;</span>&gt;(<span class="function">(<span class="params">resolve</span>) =&gt;</span> &#123;</span><br><span class="line"><span class="title function_">debounceOpenRecomfirmPopup</span>(resolve)</span><br><span class="line">&#125;)</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>第一眼看上去会有几个疑问：</p><ul><li>防抖的回调里再去记录 Promise 的 <code>resolve</code>，打开和完成是断开的，<strong>顺序怎么保证？</strong></li><li>这是某种「高级稳定」的写法吗？</li><li>我是不是应该照着学？</li></ul><p>直觉是对的——<strong>这不是值得照搬的高级模式，而是一个把两个机制硬耦合在一起的 workaround。</strong></p><hr><h2 id="二、为什么这段代码别扭"><a href="#二、为什么这段代码别扭" class="headerlink" title="二、为什么这段代码别扭"></a>二、为什么这段代码别扭</h2><h3 id="2-1-完整的执行链路"><a href="#2-1-完整的执行链路" class="headerlink" title="2.1 完整的执行链路"></a>2.1 完整的执行链路</h3><ol><li>调用 <code>openRecomfirmPopupAsync()</code>：创建 Promise，把 <code>resolve</code> 传给 <code>debounceOpenRecomfirmPopup</code>。</li><li>防抖 300ms 后才执行：把 <code>resolve</code> 存到 <code>recomfirmPopupPromiseResolve.value</code>，并打开弹窗。</li><li>弹窗关闭：<code>handleRecomfirmClose</code> 调用存起来的 <code>resolve(actionCode)</code>，Promise 才算完成。</li></ol><h3 id="2-2-顺序隐患：debounce-会吞掉-resolve"><a href="#2-2-顺序隐患：debounce-会吞掉-resolve" class="headerlink" title="2.2 顺序隐患：debounce 会吞掉 resolve"></a>2.2 顺序隐患：debounce 会吞掉 resolve</h3><p>如果用户快速连续触发两次 <code>openRecomfirmPopupAsync()</code>：</p><ul><li>第一次的 <code>resolve</code> 被防抖<strong>吞掉了</strong>（不执行），但对应的 Promise 已经挂起在等待。</li><li>防抖只执行最后一次回调，第二次的 <code>resolve</code> 覆盖了 <code>recomfirmPopupPromiseResolve.value</code>。</li><li><strong>第一次的 Promise 永远不会被 resolve —— 直接挂死。</strong></li></ul><blockquote><p><strong>核心问题</strong>：防抖的语义是「只保留最后一次调用」，而 Promise 的语义是「每次调用都必须有结果」。把 <code>resolve</code> 丢进 debounce，相当于允许「Promise 完成事件」被静默丢弃。</p></blockquote><h3 id="2-3-「resolve-外挂到-ref」本身也不稳"><a href="#2-3-「resolve-外挂到-ref」本身也不稳" class="headerlink" title="2.3 「resolve 外挂到 ref」本身也不稳"></a>2.3 「resolve 外挂到 ref」本身也不稳</h3><ul><li>依赖一个全局 ref 做中转，任何地方意外清空就会挂死。</li><li>和 Vue 响应式系统混用，调试困难。</li><li>弹窗如果走了非预期路径（组件销毁、路由跳转、异常），<code>resolve</code> 永远不会被调用，<strong>Promise 泄漏</strong>。</li></ul><hr><h2 id="三、它想做的事：Deferred-Pattern"><a href="#三、它想做的事：Deferred-Pattern" class="headerlink" title="三、它想做的事：Deferred Pattern"></a>三、它想做的事：Deferred Pattern</h2><p>抛开实现，这段代码的实质意图非常简单：</p><blockquote><p>弹窗打开 → 等用户操作 → 拿到结果继续。</p></blockquote><p>业务代码希望能这样写：</p><figure class="highlight typescript"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// 一气呵成，逻辑连贯</span></span><br><span class="line"><span class="keyword">const</span> actionCode = <span class="keyword">await</span> <span class="title function_">openRecomfirmPopupAsync</span>()</span><br><span class="line"><span class="keyword">if</span> (actionCode === <span class="string">&#x27;cancel&#x27;</span>) <span class="keyword">return</span> <span class="literal">false</span></span><br><span class="line"><span class="comment">// 继续下单...</span></span><br></pre></td></tr></table></figure><p>但弹窗本身是异步的：</p><ol><li><code>isShowRecomfirmPopup = true</code> 打开它；</li><li>用户看到弹窗，点击「确认 &#x2F; 取消」；</li><li>Vue 组件 emit <code>close</code> 事件，传回 <code>actionCode</code>。</li></ol><p><strong>步骤 2 是不可预测的时间间隔</strong>——你不可能在打开弹窗后同步拿到结果。这正是 Promise 的用武之地。</p><blockquote><p><strong>Promise 的本质</strong>：把「未来才会发生的结果」变成一个现在就能持有的对象。</p></blockquote><p>这种「把异步操作和它的完成控制权解耦」的模式，就是 <strong>Deferred Pattern（延迟对象模式）</strong>。</p><hr><h2 id="四、Deferred-Pattern-详解"><a href="#四、Deferred-Pattern-详解" class="headerlink" title="四、Deferred Pattern 详解"></a>四、Deferred Pattern 详解</h2><h3 id="4-1-Promise-vs-Deferred"><a href="#4-1-Promise-vs-Deferred" class="headerlink" title="4.1 Promise vs. Deferred"></a>4.1 Promise vs. Deferred</h3><table><thead><tr><th>对比维度</th><th>Promise</th><th>Deferred</th></tr></thead><tbody><tr><td>关注点</td><td>异步操作的<strong>结果</strong></td><td>异步操作<strong>本身及其控制权</strong></td></tr><tr><td>类比</td><td>取餐票，只能等出餐</td><td>厨师手里的底单，决定何时出餐</td></tr><tr><td>谁能完成它</td><td>构造函数内部的逻辑</td><td>外部任意代码（持有 resolve &#x2F; reject 的人）</td></tr></tbody></table><h3 id="4-2-基础实现"><a href="#4-2-基础实现" class="headerlink" title="4.2 基础实现"></a>4.2 基础实现</h3><p>在现代 JavaScript 里，可以用一个工具函数构造 Deferred：</p><figure class="highlight typescript"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">function</span> createDeferred&lt;T&gt;() &#123;</span><br><span class="line"><span class="keyword">let</span> resolve!: <span class="function">(<span class="params">value: T</span>) =&gt;</span> <span class="built_in">void</span></span><br><span class="line"><span class="keyword">let</span> reject!: <span class="function">(<span class="params">reason?: <span class="built_in">unknown</span></span>) =&gt;</span> <span class="built_in">void</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">const</span> promise = <span class="keyword">new</span> <span class="title class_">Promise</span>&lt;T&gt;(<span class="function">(<span class="params">res, rej</span>) =&gt;</span> &#123;</span><br><span class="line">resolve = res</span><br><span class="line">reject = rej</span><br><span class="line">&#125;)</span><br><span class="line"></span><br><span class="line"><span class="keyword">return</span> &#123; promise, resolve, reject &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>要点：</p><ul><li><code>resolve / reject</code> 在构造函数中被「偷出来」赋值给外部变量。</li><li>返回一个三件套：<code>promise</code> 给消费方 await，<code>resolve / reject</code> 给控制方调用。</li></ul><h3 id="4-3-适用场景"><a href="#4-3-适用场景" class="headerlink" title="4.3 适用场景"></a>4.3 适用场景</h3><ul><li><strong>解耦异步逻辑</strong>：开始和结束不在同一个作用域里（事件监听、Socket 消息、弹窗回调等）。</li><li><strong>封装回调式 API</strong>：旧接口不便直接塞进 <code>new Promise</code> 构造函数时，用 Deferred 当外挂。</li><li><strong>跨函数共享 resolve</strong>：多个回调函数协同决定一个 Promise 的命运。</li></ul><hr><h2 id="五、现代标准：Promise-withResolvers"><a href="#五、现代标准：Promise-withResolvers" class="headerlink" title="五、现代标准：Promise.withResolvers()"></a>五、现代标准：<code>Promise.withResolvers()</code></h2><p>ECMAScript 2024 (ES15) 已经把这个模式标准化了，直接内置：</p><figure class="highlight typescript"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">const</span> &#123; promise, resolve, reject &#125; = <span class="title class_">Promise</span>.<span class="property">withResolvers</span>&lt;<span class="built_in">string</span>&gt;()</span><br><span class="line"></span><br><span class="line"><span class="built_in">setTimeout</span>(<span class="function">() =&gt;</span> &#123;</span><br><span class="line"><span class="title function_">resolve</span>(<span class="string">&#x27;任务完成！&#x27;</span>)</span><br><span class="line">&#125;, <span class="number">2000</span>)</span><br><span class="line"></span><br><span class="line">promise.<span class="title function_">then</span>(<span class="variable language_">console</span>.<span class="property">log</span>)</span><br></pre></td></tr></table></figure><p>以后写 Deferred 不需要再手撸 <code>createDeferred</code>，直接用原生 API 即可。</p><hr><h2 id="六、为什么-Promise-一开始是-pending"><a href="#六、为什么-Promise-一开始是-pending" class="headerlink" title="六、为什么 Promise 一开始是 pending"></a>六、为什么 Promise 一开始是 pending</h2><p>回到最初的疑问：</p><blockquote><p>点击下单要打开二次弹窗时，<code>openRecomfirmPopupAsync</code> 返回的 Promise 里也没立刻 <code>resolve</code> 啊，它一直在 pending —— 这是怎么工作的？</p></blockquote><p>答案是：<strong><code>resolve</code></strong> <strong>是一个普通函数对象，可以被传递、存储、延后调用。Promise 不需要在创建时就完成。</strong></p><h3 id="6-1-执行时间线"><a href="#6-1-执行时间线" class="headerlink" title="6.1 执行时间线"></a>6.1 执行时间线</h3><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br></pre></td><td class="code"><pre><span class="line">时间 0ms ─── 业务代码调用 openRecomfirmPopupAsync()</span><br><span class="line">│</span><br><span class="line">│  new Promise(resolve =&gt; debounceOpenRecomfirmPopup(resolve))</span><br><span class="line">│  → resolve 被当作参数传进 debounce，但 debounce 不立即执行</span><br><span class="line">│  → 此时 Promise 状态：pending，resolve 函数&quot;悬空&quot;</span><br><span class="line">│  → await 暂停，业务代码停在这里等待</span><br><span class="line">│</span><br><span class="line">时间 300ms ─── debounce 延迟结束，执行回调</span><br><span class="line">│</span><br><span class="line">│  recomfirmPopupPromiseResolve.value = resolve   ← resolve 被存起来</span><br><span class="line">│  isShowRecomfirmPopup.value = true              ← 弹窗打开</span><br><span class="line">│</span><br><span class="line">│  → Promise 状态：仍然是 pending</span><br><span class="line">│  → 但现在 resolve 有了&quot;持有者&quot;（ref），未来可以被调用</span><br><span class="line">│</span><br><span class="line">时间 ?s ─── 用户在弹窗里点了确认 / 取消 / 关闭</span><br><span class="line">│</span><br><span class="line">│  handleRecomfirmClose(&#123; actionCode &#125;)</span><br><span class="line">│  recomfirmPopupPromiseResolve.value?.(actionCode) ← resolve 被调用</span><br><span class="line">│  recomfirmPopupPromiseResolve.value = null         ← 清理</span><br><span class="line">│</span><br><span class="line">│  → Promise 状态：pending → fulfilled，值 = actionCode</span><br><span class="line">│  → await 恢复执行，业务代码拿到 &#x27;confirm&#x27; / &#x27;cancel&#x27; / &#x27;close&#x27;</span><br></pre></td></tr></table></figure><h3 id="6-2-类比：事件监听"><a href="#6-2-类比：事件监听" class="headerlink" title="6.2 类比：事件监听"></a>6.2 类比：事件监听</h3><p>这就像你给 <code>addEventListener</code> 注册了一个回调：事件没触发时回调当然不会执行，但回调已经「挂上」了。Promise 的 <code>resolve</code> 也是同理：</p><figure class="highlight typescript"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">const</span> promise = <span class="keyword">new</span> <span class="title class_">Promise</span>(<span class="function">(<span class="params">resolve</span>) =&gt;</span> &#123;</span><br><span class="line"><span class="comment">// resolve 是一个函数，可以像任何变量一样被传递</span></span><br><span class="line"><span class="comment">// 传给 debounce、存到 ref、传给另一个函数——都可以</span></span><br><span class="line"><span class="comment">// 只要最终有人调用 resolve(值)，Promise 就会完成</span></span><br><span class="line"><span class="title function_">debounceOpenRecomfirmPopup</span>(resolve)</span><br><span class="line">&#125;)</span><br></pre></td></tr></table></figure><p><strong>Deferred Pattern 的核心</strong>就是：把「何时完成」的决定权从 Promise 内部移到了外部。</p><ul><li>普通 Promise 是<strong>内部自治</strong>的（网络请求成功就 resolve）。</li><li>Deferred 是<strong>外部控制</strong>的（弹窗关闭才 resolve）。</li></ul><hr><h2 id="七、更干净的写法"><a href="#七、更干净的写法" class="headerlink" title="七、更干净的写法"></a>七、更干净的写法</h2><p>回到最初那段代码，改造方向有两个原则：</p><ol><li><strong>防双击应该在 UI 层做（按钮点击节流），不要和 Promise 机制纠缠。</strong></li><li><strong><code>resolve</code></strong>** 不要散落在 ref 里，尽量保持在同一个闭包内管理。**</li></ol><h3 id="方案-A：用-Deferred-工具函数封装"><a href="#方案-A：用-Deferred-工具函数封装" class="headerlink" title="方案 A：用 Deferred 工具函数封装"></a>方案 A：用 Deferred 工具函数封装</h3><figure class="highlight typescript"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">function</span> createDeferred&lt;T&gt;() &#123;</span><br><span class="line"><span class="keyword">let</span> resolve!: <span class="function">(<span class="params">value: T</span>) =&gt;</span> <span class="built_in">void</span></span><br><span class="line"><span class="keyword">let</span> reject!: <span class="function">(<span class="params">reason?: <span class="built_in">unknown</span></span>) =&gt;</span> <span class="built_in">void</span></span><br><span class="line"><span class="keyword">const</span> promise = <span class="keyword">new</span> <span class="title class_">Promise</span>&lt;T&gt;(<span class="function">(<span class="params">r, j</span>) =&gt;</span> &#123; resolve = r; reject = j &#125;)</span><br><span class="line"><span class="keyword">return</span> &#123; promise, resolve, reject &#125;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="comment">// 弹窗使用</span></span><br><span class="line"><span class="keyword">let</span> <span class="attr">currentDeferred</span>: <span class="title class_">ReturnType</span>&lt;<span class="keyword">typeof</span> createDeferred&lt;<span class="title class_">ActionCode</span>&gt;&gt; | <span class="literal">null</span> = <span class="literal">null</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">const</span> <span class="title function_">openRecomfirmPopupAsync</span> = (<span class="params"></span>) =&gt; &#123;</span><br><span class="line">currentDeferred = createDeferred&lt;<span class="title class_">ActionCode</span>&gt;()</span><br><span class="line">isShowRecomfirmPopup.<span class="property">value</span> = <span class="literal">true</span></span><br><span class="line"><span class="keyword">return</span> currentDeferred.<span class="property">promise</span></span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="keyword">const</span> <span class="title function_">handleRecomfirmClose</span> = (<span class="params">actionCode: ActionCode</span>) =&gt; &#123;</span><br><span class="line">currentDeferred?.<span class="title function_">resolve</span>(actionCode)</span><br><span class="line">currentDeferred = <span class="literal">null</span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="方案-B：直接用-Promise-withResolvers"><a href="#方案-B：直接用-Promise-withResolvers" class="headerlink" title="方案 B：直接用 Promise.withResolvers()"></a>方案 B：直接用 <code>Promise.withResolvers()</code></h3><figure class="highlight typescript"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">let</span> <span class="attr">pending</span>: <span class="title class_">ReturnType</span>&lt;<span class="keyword">typeof</span> <span class="title class_">Promise</span>.<span class="property">withResolvers</span>&lt;<span class="title class_">ActionCode</span>&gt;&gt; | <span class="literal">null</span> = <span class="literal">null</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">const</span> <span class="title function_">openRecomfirmPopupAsync</span> = (<span class="params"></span>) =&gt; &#123;</span><br><span class="line">pending = <span class="title class_">Promise</span>.<span class="property">withResolvers</span>&lt;<span class="title class_">ActionCode</span>&gt;()</span><br><span class="line">isShowRecomfirmPopup.<span class="property">value</span> = <span class="literal">true</span></span><br><span class="line"><span class="keyword">return</span> pending.<span class="property">promise</span></span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="keyword">const</span> <span class="title function_">handleRecomfirmClose</span> = (<span class="params">actionCode: ActionCode</span>) =&gt; &#123;</span><br><span class="line">pending?.<span class="title function_">resolve</span>(actionCode)</span><br><span class="line">pending = <span class="literal">null</span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="方案-C：组件内部用-watchOnce-自动收尾"><a href="#方案-C：组件内部用-watchOnce-自动收尾" class="headerlink" title="方案 C：组件内部用 watchOnce 自动收尾"></a>方案 C：组件内部用 <code>watchOnce</code> 自动收尾</h3><figure class="highlight typescript"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">const</span> <span class="title function_">openRecomfirmPopupAsync</span> = (<span class="params"></span>) =&gt; <span class="keyword">new</span> <span class="title class_">Promise</span>&lt;<span class="title class_">ActionCode</span>&gt;(<span class="function">(<span class="params">resolve</span>) =&gt;</span> &#123;</span><br><span class="line">isShowRecomfirmPopup.<span class="property">value</span> = <span class="literal">true</span></span><br><span class="line"><span class="title function_">watchOnce</span>(isShowRecomfirmPopup, <span class="function">(<span class="params">val</span>) =&gt;</span> &#123;</span><br><span class="line"><span class="keyword">if</span> (!val) <span class="title function_">resolve</span>(lastActionCode.<span class="property">value</span>)</span><br><span class="line">&#125;)</span><br><span class="line">&#125;)</span><br></pre></td></tr></table></figure><p>三种写法的共同点：<strong>逻辑是线性的，不会丢 resolve，也没有防抖和 Promise 的耦合。</strong></p><hr><h2 id="八、总结"><a href="#八、总结" class="headerlink" title="八、总结"></a>八、总结</h2><blockquote><p><strong>值得学的</strong>：Deferred Pattern 的思路 —— Promise 可以拆开，手动控制完成时机。这是处理异步 UI 交互、事件驱动逻辑的标准手段。</p></blockquote><blockquote><p><strong>不值得照搬的</strong>：在原代码里，把 <code>debounce</code> 和 Deferred 混用、把 <code>resolve</code> 外挂到 Vue ref —— 这是两个不相干机制的硬耦合，会带来顺序丢失和 Promise 泄漏的隐患。</p></blockquote><p>一句话总结：</p><blockquote><p>学到的是<strong>思路</strong>（Promise 可以手动控制完成时机），不是<strong>具体写法</strong>（debounce + ref 外挂 resolve）。</p></blockquote>]]>
    </content>
    <id>https://believed-breadfruit.top/2026/05/10/2026-05-10-Promise-Deferred-Pattern/</id>
    <link href="https://believed-breadfruit.top/2026/05/10/2026-05-10-Promise-Deferred-Pattern/"/>
    <published>2026-05-10T08:30:00.000Z</published>
    <summary>
      <![CDATA[<blockquote>
<p>本文从一段 Vue 项目中「防抖 + Promise resolve 外挂」的弹窗代码出发，分析它为什么别扭、背后想实现的 Deferred Pattern 究竟是什么，以及在现代 JavaScript 里更干净的写法。</p>
</blockqu]]>
    </summary>
    <title>Promise Deferred Pattern：从一段别扭的弹窗代码说起</title>
    <updated>2026-05-10T08:30:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="运动与健康" scheme="https://believed-breadfruit.top/categories/%E8%BF%90%E5%8A%A8%E4%B8%8E%E5%81%A5%E5%BA%B7/"/>
    <category term="跑步" scheme="https://believed-breadfruit.top/tags/%E8%B7%91%E6%AD%A5/"/>
    <category term="运动" scheme="https://believed-breadfruit.top/tags/%E8%BF%90%E5%8A%A8/"/>
    <category term="健身" scheme="https://believed-breadfruit.top/tags/%E5%81%A5%E8%BA%AB/"/>
    <category term="训练计划" scheme="https://believed-breadfruit.top/tags/%E8%AE%AD%E7%BB%83%E8%AE%A1%E5%88%92/"/>
    <content>
      <![CDATA[<h2 id="衡量跑步性能的指标"><a href="#衡量跑步性能的指标" class="headerlink" title="衡量跑步性能的指标"></a>衡量跑步性能的指标</h2><p>作为有氧运动，跑步的性能衡量主要分为4个方面：</p><ul><li>持续性和坚持: 能够长期坚持跑步，养成稳定的锻炼习惯，例如每周跑步3-5次。</li><li>距离和耐力: 可以连续跑完一定的距离，如5公里、10公里，甚至半程或全程马拉松。</li><li>速度和配速: 在特定距离内达到较快的速度，例如5公里跑进25分钟。</li><li>心率: 心率是衡量心肺能力的重要指标。在跑步中能够长时间维持在有氧区间（Zone 2, 60%-70%的最大心率）是良好心肺健康的表现。</li></ul><h2 id="现状"><a href="#现状" class="headerlink" title="现状"></a>现状</h2><h3 id="近3个月跑步记录"><a href="#近3个月跑步记录" class="headerlink" title="近3个月跑步记录"></a>近3个月跑步记录</h3><table><thead><tr><th>Month</th><th>Consistency (Runs)</th><th>Speed (Pace)</th><th>Distance (Avg km)</th><th>Heart Rate (Avg bpm)</th></tr></thead><tbody><tr><td>11月</td><td>10</td><td>6.21 min&#x2F;km</td><td>7.11</td><td>149.9</td></tr><tr><td>10月</td><td>12</td><td>6.59 min&#x2F;km</td><td>4.47</td><td>137.2</td></tr><tr><td>9月</td><td>17</td><td>7.23 min&#x2F;km</td><td>5.37</td><td>145.35</td></tr></tbody></table><h3 id="近两周跑步记录"><a href="#近两周跑步记录" class="headerlink" title="近两周跑步记录"></a>近两周跑步记录</h3><table><thead><tr><th>Week</th><th>Consistency (Runs)</th><th>Speed (Pace)</th><th>Distance (Avg km)</th><th>Heart Rate (Avg bpm)</th></tr></thead><tbody><tr><td>11.24-12.01</td><td>3</td><td>5.59 min&#x2F;km</td><td>7.57</td><td>147.33</td></tr><tr><td>11.17-11.24</td><td>3</td><td>6.05 min&#x2F;km</td><td>7.86</td><td>152</td></tr></tbody></table><h3 id="数据趋势总结"><a href="#数据趋势总结" class="headerlink" title="数据趋势总结"></a>数据趋势总结</h3><ol><li>跑步频率（Consistency）：形成跑步习惯</li></ol><ul><li>近3个月：9月最多（17次），10月减少到12次，11月进一步下降到10次。</li><li>近两周：保持稳定，每周跑步3次，目前跑步频率趋于均衡，已经形成跑步习惯</li></ul><ol start="2"><li>配速（Speed &#x2F; Pace）：配速稳定提升，尤其是近两周已经显著超过前三个月的平均水平，跑步效率和速度都有所改善。</li></ol><ul><li>近3个月：配速持续提升：9月为 7.23 min&#x2F;km，10月为 6.59 min&#x2F;km，11月进一步提升到 6.21 min&#x2F;km。</li><li>近两周：11.24-12.01：5.59 min&#x2F;km，比前一周 6.05 min&#x2F;km 提升显著。</li></ul><ol start="3"><li>距离（Distance）：耐力逐步提升</li></ol><ul><li>近3个月：9月平均 5.37 km，10月减少到 4.47 km，但11月回升到 7.11 km。</li><li>近两周：11.17-11.24 跑步距离较高（7.86 km），11.24-12.01 略微下降到 7.57 km。</li></ul><ol start="4"><li>平均心率（Heart Rate）：心肺适应性有所改善，逐渐适应高强度训练</li></ol><ul><li>近3个月：9月心率为 145.35 bpm，10月下降到 137.2 bpm，但11月上升到 149.9 bpm。</li><li>近两周：11.24-12.01：147.33 bpm，略低于前一周的 152 bpm。</li><li>心率整体呈波动趋势：<ul><li>9月和10月的心率偏低，可能因为配速较慢。</li><li>11月心率回升至较高水平，与配速加快和训练强度提升相关。</li><li>近两周心率略有下降，表明跑步的心肺适应性有所改善。</li></ul></li></ul><h3 id="数据对标"><a href="#数据对标" class="headerlink" title="数据对标"></a>数据对标</h3><p>根据<a href="https://runninglevel.com/#results">running level 网站</a>的计算，我的5k, 10k的水平如下图所示：</p><ul><li><p>5k<br><img src="/../images/better_at_running/image-2.png" alt="alt text"></p></li><li><p>10k<br><img src="/../images/better_at_running/image-1.png" alt="alt text"></p></li></ul><p>可以看到，对标我年龄段的业余跑者来看，我处于入门水平。</p><h3 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h3><p>总体来讲，我很满意目前的跑步性能，看到了我未来的提升空间很大，看到了进步的趋势。最重要的是，每次跑完，感觉真的很爽，心情舒畅。</p><h2 id="回忆以前"><a href="#回忆以前" class="headerlink" title="回忆以前"></a>回忆以前</h2><p>我是今年5月份开始跑步，那段时间，我面临着两个不争的事实：</p><ol><li><p>我感觉自己达不到现在的水平。我的微信朋友圈有一个好友一直在坚持跑步，他的配速时5-6min&#x2F;km，距离是5k。有一次我直接向外发出了一个失败的感叹，“我永远也做不到像他这”，这句话我印象十分深刻。</p></li><li><p>第2公里很难坚持下去，每次往前跑一步，我都有疑问“自己为什么要迈出这步”。那个时候，我根本不知道自己为什么要跑步，只知道身体需要锻炼，我没有任何方法。</p></li></ol><p>今年上半年，我的跑步情况是这样的：</p><ul><li>1月跑了1次，2.67km, 配速9:16 min&#x2F;km</li><li>2月跑了1次，2.83km, 配速10:53 min&#x2F;km</li><li>3月没跑</li><li>4月跑了6次，平均2km, 配速9:12 min&#x2F;km</li><li>5月跑了10次，平均3.23km, 配速7:54 min&#x2F;km</li><li>6月跑了11次，平均3.23km, 配速8:48 min&#x2F;km</li></ul><p><img src="/../images/better_at_running/image-3.png" alt="alt text"></p><p>可以发现，这些数据真的很糟糕。</p><h2 id="跑步阶段回顾"><a href="#跑步阶段回顾" class="headerlink" title="跑步阶段回顾"></a>跑步阶段回顾</h2><p>从今年5月份开始决定跑步，到现在，我的跑步历程主要分为下面5个阶段，</p><ol><li>起步（5-7月份）。定一个简单的目标: 每周跑3次，随便找了个habit tracker工具，跑完记录一次。</li></ol><p><img src="/../images/better_at_running/habit.jpeg" alt="alt text"></p><p>这个阶段有两个问题：非常多断跑，跑的过程中很痛苦，不知道为啥要跑下一步。</p><ol start="2"><li>稳定跑（8月份）。主要是解决断跑+跑多少的问题。开了个keep会员，可以选一些跑步训练，比如3公里，跑的过程中还可以听节奏。</li></ol><p>这个阶段有点跑步的感觉了，但是感觉每次跑步都很累，如果跑步的情绪记忆是痛苦的，那肯定会影响跑步积极性。</p><p><img src="/../images/better_at_running/IMG_1374.jpg" alt="alt text"></p><ol start="3"><li><p>数据跑（9月份）。买了个新表garmin，忘了为什么要买，但是这表可以记录更多数据，从这个月开始，我开始了解跑步数据了，每次跑完就看看数据，还让ai给我生成一些跑步计划。</p></li><li><p>科学跑（10月份）。无意间了解到一个“二区跑”这个概念，然后在网上看了很多讲解，开始关注心率、有氧、耐力这些性能指标了。</p></li></ol><p><img src="/../images/better_at_running/image-4.png" alt="alt text"></p><ol start="5"><li>上瘾跑（11月份）。二区跑开始慢慢提速了，虽然心率跑到3、4区了，但是配速快了，而且跑完也不累，心情感觉也很爽，这个月跑步性能突然有了质的提升，数据给的正向反馈+多巴胺内啡肽的释放+习惯，各种buff叠加，发现跑步越来越上瘾了。</li></ol><h2 id="经验总结"><a href="#经验总结" class="headerlink" title="经验总结"></a>经验总结</h2><h3 id="阶段路径总结"><a href="#阶段路径总结" class="headerlink" title="阶段路径总结"></a>阶段路径总结</h3><p>每一个阶段，我都有一套统一的规则：目标，工具，反思。工具的选择其实并没有精心挑选过，大部分都是过程中体验，而且在好奇心的驱使下，无意间建立了很多认知。</p><h3 id="经验分析"><a href="#经验分析" class="headerlink" title="经验分析"></a>经验分析</h3><p>过程中确实有一些弯路，但是正是因为有这些弯路，才逐渐建立了对跑步的全局认知，这种认知我并不需要前置，不必要求一开始就全部知道。所以这样看，谈论规避弯路没有意义，但是确实两点可以前置。</p><ul><li>目标感加强。一开始动机不强不要紧，但是必须清楚地意识到，一件事情，要么做，要么不做，要是做了，就早点get going，缩短无效探索时间。</li><li>早点建立科学理念，在这个场景下，就是跑步理论，防止受伤。</li></ul><p>第二点对我来说不强烈，可能因为我这方面底子好，但是第一点是非常真实的感悟，通过这次跑步的经验总结，我似乎拥有了一种可以实现目标的超能力。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2024/12/01/2024-12-01-how-do-i-get-better-at-running/</id>
    <link href="https://believed-breadfruit.top/2024/12/01/2024-12-01-how-do-i-get-better-at-running/"/>
    <published>2024-12-01T03:05:01.562Z</published>
    <summary>
      <![CDATA[<h2 id="衡量跑步性能的指标"><a href="#衡量跑步性能的指标" class="headerlink" title="衡量跑步性能的指标"></a>衡量跑步性能的指标</h2><p>作为有氧运动，跑步的性能衡量主要分为4个方面：</p>
<ul>
<li>持续性和坚]]>
    </summary>
    <title>How do I get better at RUNNING</title>
    <updated>2024-12-01T03:05:01.562Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="前端" scheme="https://believed-breadfruit.top/categories/%E5%89%8D%E7%AB%AF/"/>
    <category term="微前端" scheme="https://believed-breadfruit.top/tags/%E5%BE%AE%E5%89%8D%E7%AB%AF/"/>
    <content>
      <![CDATA[<p>微前端是现代前端开发的趋势，许多企业选择将微前端架构融入其技术战略中，有些是选择现有微前端框架如 <a href="https://single-spa.js.org/docs/getting-started-overview">Single-SPA</a>、<a href="https://qiankun.umijs.org/zh/guide">Qiankun</a>、<a href="https://micro-zoe.github.io/micro-app/docs.html#/">Micro-App</a> 或 <a href="https://wujie-micro.github.io/doc/guide/#%E6%97%A0%E7%95%8C%E6%96%B9%E6%A1%88">Wujie</a>，有些是根据自身独特的业务需求研发了定制的解决方案。</p><p>这一技术趋势的背后是前端技术的快速进化和单页面应用（SPA）开发模式的普及。</p><h3 id="多页应用"><a href="#多页应用" class="headerlink" title="多页应用"></a>多页应用</h3><p>在早期的前端开发中，网站通常采用多页面应用（MultiPage Application, MPA）的形式，每个页面都有自己独立的 HTML、JavaScript 和 CSS 文件。这种架构的一个显著特点是，当浏览器的 URL 发生变化时，浏览器会加载一个新的 HTML 页面，并随之加载相应的 JavaScript 和 CSS 资源。这导致页面不断刷新，虽然简单直接，但对于用户来说体验并不友好，尤其是在需要快速响应和交互的现代Web应用中。</p><h3 id="单页应用"><a href="#单页应用" class="headerlink" title="单页应用"></a>单页应用</h3><p>为了减少页面全局刷新，提升用户体验，单页面应用（SinglePage Web Application, SPA）应运而生。SPA 通过在一个单一的HTML页面加载所有JavaScript 和 CSS 资源，在用户交互过程中，网页不会重新加载或跳转，而是动态地重写当前页面与用户交互的部分，从而避免了页面的全面刷新。</p><p>SPA能实现局部渲染主要是基于两个技术实现：</p><ul><li><strong>AJAX异步</strong></li></ul><p>通过AJAX技术异步请求数据，客户端可以在不刷新整个页面的情况下，与服务器交换数据，并根据返回的数据更新页面的部分内容。这种方式允许用户在网页上进行快速交互，只加载或变更需要更新的部分。</p><ul><li><strong>JavaScript 路由</strong></li></ul><p>路由管理通常由JavaScript在前端处理，而不是服务器端。通过在客户端监听URL的变化，然后根据URL的不同展示相应的视图，而无需重新加载页面。单页面应用主要依赖两种路由模式来管理 URL 的变化：一种是基于 URL 的哈希（hash），另一种是利用 HTML5 的 History API。</p><h3 id="微前端应用"><a href="#微前端应用" class="headerlink" title="微前端应用"></a>微前端应用</h3><p>随着业务的增长和应用的扩展，单页面应用往往逐渐演变为庞大的单体应用，这不仅使得项目难以维护，同时由于前端技术栈的快速迭代，老旧技术的技术债务也日益增加。</p><p>在这样的背景下，传统的巨石单体应用已经难以应对快速迭代和灵活部署的要求。微前端架构应运而生，在微前端架构下，一个大型单一的前端应用被拆分成多个小型、独立的子应用，这些子应用负责应用的一部分功能，可以独立开发、部署、运行，并且可以使用不同的技术栈，从而带来更加灵活高效的项目开发和管理。</p><p><img src="/../images/2024-04/mfe.png" alt="Small Picture"></p><p>微前端架构本质上依然采用单页面应用的形式，即在一个单一的 HTML 文件中加载多个 JavaScript 和 CSS 资源。然而，它通过精巧的路由和应用生命周期管理，以及不可缺少的隔离和共享机制，能够将多个独立开发的子应用集成到一个协调一致的用户界面中。</p><p>从微前端概念和产生背景出发，基于对现有微前端框架的考查，可以总结出微前端架构的设计具有以下特征：</p><ul><li>子应用的独立性：独立开发、技术栈无关。</li><li>子应用的自治性（隔离）：应用运行期间有明显的边界，不受影响。</li><li>共享机制：复用性、统一体验、高效协调。</li></ul><p>这种模式不仅提高了开发效率，降低了维护难度，还使得旧系统的逐步迁移变得可行，无需重构整个应用。因此，微前端是现代Web开发中的一个重要趋势。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2024/04/22/%E5%BE%AE%E5%89%8D%E7%AB%AF%E6%8A%80%E6%9C%AF%E7%BB%BC%E8%BF%B0/</id>
    <link href="https://believed-breadfruit.top/2024/04/22/%E5%BE%AE%E5%89%8D%E7%AB%AF%E6%8A%80%E6%9C%AF%E7%BB%BC%E8%BF%B0/"/>
    <published>2024-04-22T13:15:58.000Z</published>
    <summary>
      <![CDATA[<p>微前端是现代前端开发的趋势，许多企业选择将微前端架构融入其技术战略中，有些是选择现有微前端框架如 <a href="https://single-spa.js.org/docs/getting-started-overview">Single-SPA</a>、<a href]]>
    </summary>
    <title>从多应用到微应用：前端架构的技术演变</title>
    <updated>2024-04-22T13:15:58.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Daria Lan</name>
    </author>
    <category term="前端" scheme="https://believed-breadfruit.top/categories/%E5%89%8D%E7%AB%AF/"/>
    <category term="微前端" scheme="https://believed-breadfruit.top/tags/%E5%BE%AE%E5%89%8D%E7%AB%AF/"/>
    <content>
      <![CDATA[<h2 id="引言"><a href="#引言" class="headerlink" title="引言"></a>引言</h2><p>微前端是微服务概念在前端的应用。在微前端架构下，一个大型单一的前端应用被拆分成多个小型、独立的子应用，这些子应用可以独立开发、独立部署、独立运行，从而带来更加灵活高效的项目开发和管理。</p><p>作为现代前端开发的趋势，许多企业的技术栈融入了微前端，有些是选择成熟的框架如 Qiankun、Micro-App 或 Single-SPA，有些是自研解决方案。</p><p>微前端最简单的实现形式是基于Iframe。本文主要从<a href="https://github.com/andregardi/micro-frontends-iframe">一个简单的微前端</a>案例入手，通过这个简单的Demo，让我们对微前端框架及其设计理念有个初步的理解。</p><h2 id="Demo源代码讲解"><a href="#Demo源代码讲解" class="headerlink" title="Demo源代码讲解"></a>Demo源代码讲解</h2><h3 id="目录结构"><a href="#目录结构" class="headerlink" title="目录结构"></a>目录结构</h3><figure class="highlight jsx"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line">iframe-demo</span><br><span class="line">├─ <span class="title class_">EventBus</span></span><br><span class="line">│  └─ <span class="title class_">EventBus</span>.<span class="property">js</span></span><br><span class="line">├─ cart</span><br><span class="line">│  ├─ index.<span class="property">html</span></span><br><span class="line">│  ├─ script.<span class="property">js</span></span><br><span class="line">│  └─ style.<span class="property">css</span></span><br><span class="line">├─ catalog</span><br><span class="line">│  ├─ index.<span class="property">html</span></span><br><span class="line">│  └─ script.<span class="property">js</span></span><br><span class="line">├─ composition.<span class="property">html</span></span><br><span class="line">├─ script.<span class="property">js</span></span><br><span class="line">└─ style.<span class="property">css</span></span><br></pre></td></tr></table></figure><p>这个Demo的目录结构非常简单，主要分为三部分：</p><ul><li>两个子应用cart、catalog</li><li>全局事件总线</li><li>主应用</li></ul><p>可以看到这个简单的项目已经体现了微前端的核心设计：应用管理、隔离和共享。</p><h3 id="应用管理"><a href="#应用管理" class="headerlink" title="应用管理"></a>应用管理</h3><p>从<code>composition.html</code>文件我们可以看出这个项目的应用管理非常简单，两个子应用通过<code>iframe</code>标签加载，共同存在于同一个页面。</p><figure class="highlight jsx"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">&lt;link rel=<span class="string">&quot;stylesheet&quot;</span> href=<span class="string">&quot;style.css&quot;</span> /&gt;</span><br><span class="line"><span class="language-xml"><span class="tag">&lt;<span class="name">iframe</span> <span class="attr">src</span>=<span class="string">&quot;./catalog/index.html&quot;</span> <span class="attr">id</span>=<span class="string">&quot;catalog&quot;</span>&gt;</span><span class="tag">&lt;/<span class="name">iframe</span>&gt;</span></span></span><br><span class="line"><span class="language-xml"><span class="tag">&lt;<span class="name">iframe</span> <span class="attr">src</span>=<span class="string">&quot;./cart/index.html&quot;</span> <span class="attr">id</span>=<span class="string">&quot;cart&quot;</span>&gt;</span><span class="tag">&lt;/<span class="name">iframe</span>&gt;</span></span></span><br><span class="line"><span class="language-xml"><span class="tag">&lt;<span class="name">script</span> <span class="attr">src</span>=<span class="string">&quot;script.js&quot;</span>&gt;</span><span class="tag">&lt;/<span class="name">script</span>&gt;</span></span></span><br><span class="line"></span><br></pre></td></tr></table></figure><h2 id="隔离"><a href="#隔离" class="headerlink" title="隔离"></a>隔离</h2><p>由于使用的是iframe标签，两个子应用天然地存在CSS和JS隔离，不会有样式和运行时的冲突。</p><h3 id="微前端-why-iframe-not-div"><a href="#微前端-why-iframe-not-div" class="headerlink" title="微前端 why iframe not div?"></a><strong>微前端 why iframe not div?</strong></h3><p>为什么微前端使用<code>iframe</code>做隔离，而不是普通<code>div</code>。</p><p>主要是因为<code>iframe</code>在浏览器中具有天然的隔离环境，主要表现在：</p><ol><li><strong>JavaScript 隔离</strong>：<code>iframe</code> 内的 JavaScript 运行在独立的全局上下文中。这意味着，<code>iframe</code> 内的 JavaScript 变量和函数不会影响到主页面，反之亦然。这种特性对于确保应用间不会相互干扰是非常重要的。</li><li><strong>样式隔离</strong>：<code>iframe</code> 内的样式不会影响到外部页面。每个 <code>iframe</code> 有自己的文档流，所以里面的 CSS 只会作用于 <code>iframe</code>内部，不会泄露到外部，这保证了样式的独立性和一致性。</li><li><strong>DOM 隔离</strong>：每个 <code>iframe</code> 都有自己的 DOM 树，与主页面的 DOM 树完全隔离。这意味着，iframe 内的 DOM 操作不会影响到外部页面，减少了应用间的直接 DOM 冲突。</li></ol><p>这些隔离特性对于普通的<code>div</code>标签是没有的。</p><h2 id="共享-通信"><a href="#共享-通信" class="headerlink" title="共享(通信)"></a>共享(通信)</h2><p>虽然<code>iframe</code>能实现简单的微前端架构，但是通过代码中设计的全局事件总线（<code>EventBus.js</code>文件），我们可以看出基于<code>iframe</code>的微前端需要单独设计跨域通信方式。</p><p>本案例主要是通过<code>PostMessage</code>方法实现的。<code>PostMessage</code>  是一种安全地实现不同浏览器窗口（包括弹出窗口和<code>iframe</code>）间通信的方式。允许不同源（<code>origin</code>）的窗口进行数据交换，从而克服了同源策略的限制。适用于多种场景，如页面与弹出窗口、页面与嵌入的<code>iframe</code>、甚至是不同的web workers之间的通信。</p><p><strong>基本用法</strong><br>包括两部分：发送消息和接收消息。</p><p><strong>发送消息:</strong> <code>window.postMessage</code><br>这个方法接受两个参数：要发送的消息和消息接收方的源（<code>origin</code>）。但出于安全考虑，这通常不推荐。</p><figure class="highlight jsx"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">otherWindow.<span class="title function_">postMessage</span>(message, targetOrigin); <span class="comment">// otherWindow 是另一个窗口的引用，例如一个 iframe 或者通过 window.open 打开的窗口</span></span><br></pre></td></tr></table></figure><ul><li><code>message</code>：你想要发送的数据。</li><li><code>targetOrigin</code>：指定目标窗口的源，例如 “<code>https://example.com</code>“。这是一种安全机制，用来确保消息只被预期的接收者接收。如果你不关心目标窗口的源，也可以使用 “*” 作为通配符。</li></ul><p>**接收消息：**在目标窗口添加一个事件监听器来监听 <code>message</code> 事件</p><figure class="highlight jsx"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line"><span class="variable language_">window</span>.<span class="title function_">addEventListener</span>(<span class="string">&quot;message&quot;</span>, <span class="function">(<span class="params">event</span>) =&gt;</span> &#123;</span><br><span class="line">    <span class="comment">// 可以通过 event.origin 检查消息来源的源</span></span><br><span class="line">    <span class="keyword">if</span> (event.<span class="property">origin</span> !== <span class="string">&quot;&lt;http://expected-origin.com&gt;&quot;</span>) &#123;</span><br><span class="line">        <span class="keyword">return</span>; <span class="comment">// 忽略来自不期望源的消息</span></span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="comment">// 处理接收到的数据</span></span><br><span class="line">    <span class="variable language_">console</span>.<span class="title function_">log</span>(event.<span class="property">data</span>);</span><br><span class="line">&#125;);</span><br></pre></td></tr></table></figure><p>在本项目中，<code>composition</code>主应用的<code>JS</code>脚本中注册了<code>message</code>事件监听，将基座应用接收到的消息转发给所有子应用。</p><figure class="highlight jsx"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">const</span> <span class="title function_">sendReceivedMessageToAllIframes</span> = (<span class="params">event</span>) =&gt; &#123;</span><br><span class="line">  <span class="variable language_">document</span></span><br><span class="line">    .<span class="title function_">querySelectorAll</span>(<span class="string">&#x27;iframe&#x27;</span>)</span><br><span class="line">    .<span class="title function_">forEach</span>(<span class="function">(<span class="params">iframe</span>) =&gt;</span> iframe.<span class="property">contentWindow</span>.<span class="title function_">postMessage</span>(event.<span class="property">data</span>, <span class="string">&#x27;*&#x27;</span>));</span><br><span class="line">&#125;;</span><br><span class="line"><span class="variable language_">window</span>.<span class="title function_">addEventListener</span>(<span class="string">&#x27;message&#x27;</span>, sendReceivedMessageToAllIframes);</span><br><span class="line"></span><br></pre></td></tr></table></figure><p>在<code>catalog</code>子应用中，注册了一个全局事件总线，并且给按钮注册了点击事件，当按钮点击后，会触发<code>productToCart</code>事件，在该事件中，会向主应用发送消息。</p><p>最终该消息会经过主应用，接着由<code>cart</code>子应用中的全局事件总线接收，执行<code>add</code>方法。</p><p>大致的交互示意图如下所示：</p><p><img src="https://prod-files-secure.s3.us-west-2.amazonaws.com/3c07946f-64a3-4eae-a269-738c94764b10/009cb022-bc62-4374-9163-d687c21e83ee/Untitled.png" alt="Untitled"></p><h2 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h2><p>一个 <code>iframe</code> 具备四层能力：文档的加载能力、HTML 的渲染能力、独立执行 JavaScript 的能力、隔离样式的能力。这些能力，其实也是微前端项目设计的核心要求。通过学习本项目，我们可以很好地初步学习微前端，为后来深入学习Single-SPA、qiankun等框架提供理论基础。</p>]]>
    </content>
    <id>https://believed-breadfruit.top/2024/04/01/%E4%B8%80%E4%B8%AA%E7%AE%80%E5%8D%95%E7%9A%84Demo%E4%BA%86%E8%A7%A3Iframe%E5%BE%AE%E5%89%8D%E7%AB%AF/</id>
    <link href="https://believed-breadfruit.top/2024/04/01/%E4%B8%80%E4%B8%AA%E7%AE%80%E5%8D%95%E7%9A%84Demo%E4%BA%86%E8%A7%A3Iframe%E5%BE%AE%E5%89%8D%E7%AB%AF/"/>
    <published>2024-04-01T13:41:25.000Z</published>
    <summary>
      <![CDATA[<h2 id="引言"><a href="#引言" class="headerlink" title="引言"></a>引言</h2><p>微前端是微服务概念在前端的应用。在微前端架构下，一个大型单一的前端应用被拆分成多个小型、独立的子应用，这些子应用可以独立开发、独立部署、独立]]>
    </summary>
    <title>一个简单的Demo了解Iframe微前端</title>
    <updated>2024-04-01T13:41:25.000Z</updated>
  </entry>
</feed>